Solução de problemas de operações no Jitterbit Studio
Este guia aborda erros e comportamentos inesperados ao criar, implantar e executar operações no Jitterbit Studio, incluindo operações, transformações, scripts e funções, além de validação em tempo de design. Se você está solucionando problemas de um conector específico, consulte Solução de problemas de conectores.
Para uma referência unificada que abrange problemas de integração, automação, gerenciamento de API, EDI e desenvolvimento de aplicativos em um único lugar, consulte o guia de solução de problemas do Harmony.
Todas as entradas de solução de problemas nesta página
-
Erros de transformação e dados
- Elementos XML não suportados (CDATA) incorporados em JSON
- Transformação falha quando um valor de string JSON excede o comprimento máximo
- Caracteres especiais em esquemas JSON fornecidos por conectores
- Caracteres multibyte corrompidos em uma resposta grande do conector
- Esquemas espelhados com grupos de substituição
- Importação de mapeamento de transformação com nós duplicados falha com "nó não pode ser criado"
- Reprocessamento de esquema XML espelhado em projetos criados antes da versão 10.25
- Aviso de subelemento extra nos logs de operação
- Saída de transformação convertida para 0 para campos de destino com tipo de dados
double - Campos mapeados em branco com esquemas de origem simples
- Nó de loop de destino mapeado para vários nós de loop de origem
- Transformação descarta registros duplicados quando a saída é hierárquica
- IDs numéricos longos corrompidos na saída de transformação
- Saída de transformação JSON omite campos
nulle string vazio - Campos mapeados vazios se tornam
xsi:nil="true"e invalidam uma solicitação XML ou SOAP - Marca de ordem de byte (BOM) em um arquivo de origem é passada para o valor do primeiro registro
-
- Funções de arquivo: Operação continua após falha de
ArchiveFileouReadFile ReadFile: Leituras parciais com conteúdo de arquivo binário- Conteúdo de
ReadFilecom bytes não UTF-8 falha quando mapeado em uma carga útil XML ou JSON UTF-8 FlushFile/FlushAllFiles: Erro quando o arquivo de destino já existeDeleteFiles: Erro quando o caminho de origem não pode ser encontradoGetJSONString: Execução interrompida em caminho inválido- Limite de iteração de loop de script excedido
- Comparar uma string com um número produz resultados inesperados
Unmapnão desmapeia um campo quando usado junto comRunScriptDBExecute: Erro quandoauto_commitetransactionsão ambostrueCallStoredProcedure:resultSetsempre nulo com drivers ODBCCallStoredProcedure: "Stored proc or function could not be found" com PostgreSQL JDBCDBLoad: Requer um driver de banco de dados JDBCAESDecryptionfalha com dados criptografados sob OpenSSL 3- Variáveis de projeto retornam valores vazios durante testes de script e transformação
IsNullretorna false para strings vazias de dados de origem JSON- Comparar uma variável de string com o número
0retorna inesperadamentetrue - Aritmética decimal produz resultados de ponto flutuante inesperados
- Funções de data retornam meia-noite em vez de um valor apenas de data
- Valor em cache expira mais cedo do que o esperado
RunXSLTfalha com "XML version must be 1.0 or 1.1"SelectSingleNoderetorna o nó errado quando usado com um elemento de arraySelectNodes- Saída de
HexToBinaryparece inalterada quando registrada SortArrayclassifica nomes de arquivo lexicograficamente, não cronologicamenteURLEncodenão codifica certos caracteres "seguros" ou multibyte- JavaScript: erro "Call to Jitterbit Tomcat failed"
- JavaScript: Alterações de variável global perdidas em falha de script
- JavaScript:
GetVarretorna null para variáveis de projeto definidas pelo usuário
- Funções de arquivo: Operação continua após falha de
-
- Erros comuns de validação de operação
- Erros de regra de validação HTTP
- Nomes de componentes devem ser únicos após importação de projeto
- Blocos de conector exclusivos de agente privado não importam para ambiente de agente na nuvem
- Fazer upload de um arquivo de schema o substitui em todo o projeto
- Implantação de modelo de processo do Marketplace falha devido a incompatibilidade de schema
- Studio fica lento ou não responde com projetos muito grandes
-
- Chunking não respeitado quando a origem é um conector baseado em SDK
- Atualizações de variáveis perdidas em operações multi-thread em chunks
- Falha ao criar diretório temporário
- Mensagens de log de operação truncadas em aproximadamente 100 KB
- Log de debug de operação expõe PII e credenciais em texto simples
Etapas de diagnóstico
Estas etapas se aplicam a quase qualquer falha de operação e são o ponto de partida recomendado antes de investigar um erro específico.
Testar a conexão
Para qualquer operação que use conectores, na conexão, clique no botão Test para garantir que a conexão seja bem-sucedida.
Para conectores baseados em Connector SDK implantados em operações executadas em agentes privados, clicar em Test também garante que a versão mais recente do conector seja baixada para o agente (a menos que a política de organização Disable Auto Connector Update esteja habilitada).
Verificar os logs de operação
Verifique os logs de operação para qualquer informação escrita durante a execução.
Dependendo do tipo de agente, dados de log adicionais estão disponíveis:
- Habilitar log de debug de operação (para agentes na nuvem ou para agentes privados).
- Habilitar log detalhado de conector (apenas agentes privados).
- Verificar os logs do agente (apenas agentes privados).
Isolar falhas específicas do agente
Se uma operação falhar em alguns agentes mas funcionar em outros dentro do mesmo grupo de agente privado, use a opção Run on dedicated agent para direcionar a operação para um agente específico. Isso permite reproduzir e investigar a falha no agente problemático sem colocar o resto do grupo offline.
Para configurar esta opção, abra as configurações de operação, selecione a guia Options e configure Run on dedicated agent.
Execução e agendamento de operação
Operações presas em estado Submitted ou Running
-
Sintoma: Uma operação não é concluída conforme esperado. Ela permanece em estado Submitted ou Running e nunca progride, ou é cancelada com a mensagem:
Long running operation canceled by SystemO cancelamento pode ocorrer após a operação ter sido executada por um tempo ou logo após o início, e não reflete necessariamente quanto tempo a operação realmente foi executada.
-
Possíveis causas:
- Um agente privado perdeu sua conexão com a plataforma Harmony e não conseguiu relatar o status da operação. A plataforma continua mostrando a operação como Running e pode cancelá-la como aparentemente travada, mesmo quando a operação foi concluída no agente. Isso pode afetar operações que normalmente terminam em segundos.
- A operação foi concluída, mas seu status final não foi reportado de volta para Harmony, então continua aparecendo como Running até expirar.
- O grupo de agentes está sob carga pesada e é lento para pegar ou atualizar operações enfileiradas.
- A operação está travada especificamente em Submitted: a mensagem de execução foi enfileirada, mas nenhum agente no grupo a aceitou, porque os agentes estão offline, não saudáveis ou não têm capacidade livre para aceitar novas operações (por exemplo, cada thread de trabalho está ocupada).
-
Resolução:
- Para agentes privados, confirme que o agente tem status Running na página Agents no Management Console, revise os logs do agente privado para problemas de conexão e verifique se a conexão de rede entre o agente e a plataforma Harmony está estável.
- Revise os logs de operação para confirmar o que aconteceu durante a execução. A mensagem de cancelamento pode aparecer mesmo para operações que foram executadas brevemente, portanto não indica necessariamente uma operação genuinamente de longa duração. Os logs também podem revelar um erro específico a ser resolvido, como
401 Unauthorized(verifique as credenciais) ou429 Too Many Requests. Um429de um endpoint de destino pode ser atenuado reduzindo a taxa de requisições ou adicionando lógica de retry; um429do gateway de API em nuvem gerenciado pela Jitterbit é seu limite de plataforma de 200 requisições por minuto, portanto distribua as chamadas ao longo do tempo ou execute as APIs afetadas em agentes privados. - Mantenha os agentes privados em uma versão atual. Versões posteriores do agente melhoram a resiliência do agente e reduzem o cancelamento prematuro de operações.
- Tente cancelar as operações afetadas. O cancelamento está disponível para operações nos status Submitted, Received, Pending ou Running na página Runtime do Management Console, na tabela de log de operação ou no status de runtime de uma operação na tela de design.
- Se a operação afetada é executada em um agendamento e nunca inicia, consulte Operações agendadas não sendo executadas.
- Se as operações não puderem ser canceladas, se o problema recorrer ou se muitas operações forem afetadas simultaneamente, entre em contato com o suporte Jitterbit, pois esses casos podem exigir resolução no lado do servidor.
Nota
A configuração MaxOperationRuntimeSeconds na seção [ProcessEngine] do arquivo jitterbit.conf do agente privado apenas limita quanto tempo uma operação é executada após um agente ter começado a executá-la, portanto não tem efeito em operações ainda enfileiradas no estado Submitted. A configuração de operação Operation Time Out limita o tempo total de execução de uma operação, mas não pode ser limitada apenas ao estado Submitted, portanto reduzi-la para forçar um cancelamento rápido também cancelaria operações que ainda estão sendo executadas legitimamente. Para limpar operações presas em Submitted, restaure a capacidade e a saúde do agente para que as mensagens de execução enfileiradas sejam processadas, em vez de ajustar um timeout.
Operações agendadas não sendo executadas
- Sintoma: Uma operação configurada com um agendamento de operação não é executada no horário agendado ou é despachada mas permanece em estado Pending ou Received.
- Possíveis causas:
- O agendamento foi atribuído à operação no Studio, mas o projeto não foi implantado. Os agendamentos atribuídos no Studio não entram em vigor até que o projeto seja implantado.
- O agendamento está desabilitado.
- Existe uma configuração incorreta de fuso horário nas configurações de agendamento.
- Para agentes privados, o serviço de agendamento não está em execução.
- O agente associado ao ambiente está offline ou não está saudável.
- As alterações implantadas em um projeto não foram totalmente sincronizadas com o agente.
- O grupo de agentes está saturado de recursos. Um acúmulo de operações de longa duração ou uso sustentado alto de CPU ou memória pode impedir que um grupo de agentes execute operações agendadas no prazo.
- Resolução:
- Confirme que o projeto foi implantado desde que o agendamento foi atribuído à operação.
- Confirme que o agendamento está habilitado. Os agendamentos podem ser habilitados ou desabilitados apenas na página Projects do Management Console, nas abas Operations e Schedules.
- Revise a configuração de agendamento, prestando atenção especial à configuração de fuso horário. Para detalhes, consulte Fusos horários de operação.
- Para agentes privados, verifique se o agente está online e saudável na página Agents no Management Console e confirme se o serviço de agendamento está em execução na máquina do agente. No Windows, verifique se Jitterbit Scheduler e Jitterbit Scheduler Service estão em execução no Gerenciador de Tarefas. No Linux e Docker, use o comando
jitterbit status. - Reimplante o projeto para forçar o agendamento a ser ressincronizado com o agente.
- Se operações estão presas em estado Pending, cancele-as pela página Runtime do Management Console e reinicie o serviço do agente.
- Se as falhas de agendamento se correlacionam com carga, reduza o número de operações de longa duração simultâneas. Em agentes privados, também revise o uso de CPU e memória e equilibre operações agendadas com a capacidade do agente (um agente privado pode executar até duas vezes sua contagem de núcleos de CPU em operações simultâneas).
- Se uma operação agendada é despachada mas depois trava em vez de nunca iniciar, consulte Operações presas em estado Submitted ou Running.
Dicionário ou variável global vazio após uma operação ser executada de forma assíncrona
- Sintoma: Um dicionário ou variável global preenchido dentro de uma operação filha fica vazio ou mantém seu valor anterior quando a operação pai o lê após invocar a filha de forma assíncrona.
- Possível causa: Quando uma operação é invocada de forma assíncrona (a propriedade Run type da ferramenta Invoke Operation definida como Asynchronously, ou
RunOperationchamada comrunSynchronouslydefinido comofalse), a filha é executada em uma thread separada e a pai continua sem aguardar. Variáveis globais e dicionários são passados para a filha por valor em vez de por referência e não são thread-safe, portanto as alterações feitas na filha não se refletem na pai. A pai também pode ler o valor antes da filha terminar. - Resolução:
- Se a pai depende de valores que a filha produz, invoque a filha de forma síncrona (a propriedade Run type da ferramenta Invoke Operation definida como Synchronously, ou
RunOperationexecutada de forma síncrona, que é o padrão) para que a filha seja concluída e suas alterações de variável global sejam herdadas pela pai. - Para compartilhar dados entre operações que devem ser executadas independentemente, persista-os com funções de cache (
WriteCacheeReadCache) em vez de depender de um dicionário ou variável global entre threads. Por padrão, as funções de cache são limitadas a 100 chamadas combinadas por minuto por organização. - Inserir um atraso fixo (por exemplo, com a função
Sleep) adiciona latência e não garante que a filha tenha terminado; execute a operação de forma síncrona.
- Se a pai depende de valores que a filha produz, invoque a filha de forma síncrona (a propriedade Run type da ferramenta Invoke Operation definida como Synchronously, ou
- Relacionado: Para o comportamento equivalente em operações multi-thread em chunks, consulte Atualizações de variáveis perdidas em operações multi-thread em chunks.
Falhas de conexão e autenticação
Certificado Salesforce: incompatibilidade de Subject Alternative Name (SAN)
-
Symptom: A Salesforce connection to a sandbox or an org with Enhanced Domains enabled fails with:
Certificate for <url> doesn't match any of the subject alternative names -
Possible causes:
- The certificate does not include the Salesforce MyDomain or sandbox URL in its Subject Alternative Names.
- The Sandbox checkbox in the Salesforce connection settings is not correctly toggled.
-
Resolution:
- Inspect the certificate's SAN entries using OpenSSL:
openssl x509 -in cert.crt -text -noout. Confirm the Subject Alternative Name section includes your Salesforce MyDomain URL. - In the Salesforce connection settings in Studio, verify the Sandbox checkbox is correctly set for your target org.
- If the Salesforce URL is absent from the SANs, regenerate the certificate to include the specific domain.
- If the same connection succeeds on a cloud agent group but fails on a private agent, the cause may instead be a missing SNI extension in the agent's TLS handshake. See Salesforce sandbox connection fails with certificate mismatch.
- Inspect the certificate's SAN entries using OpenSSL:
Falha de conexão com banco de dados do agente privado (TranDb)
- Sintoma: As operações falham com erros que fazem referência ao banco de dados PostgreSQL interno do agente privado (
TranDb), por exemploFailed to connect to back-end database 'TranDb'ouFATAL: query_wait_timeout. - Causa e resolução: Este é um problema no nível do agente com as conexões de banco de dados interno do agente privado. Consulte Falhas de conexão
TranDbno guia de solução de problemas do agente para as causas e resolução.
Falha ao carregar certificado do cliente em agentes privados Linux
-
Sintoma: Uma operação que faz uma chamada de serviço web TLS mútuo (certificado do cliente) de saída falha em tempo de execução em um agente privado Linux, com um erro como:
Problem with the local SSL certificate. Unable to set private key file: '<path>.key' type PEM.O certificado é carregado com sucesso no Studio, mas a operação falha quando é executada. A mesma configuração pode ter funcionado anteriormente em um agente privado Windows.
-
Possíveis causas:
- O usuário do sistema operacional que executa o agente Jitterbit não tem permissão de leitura para o arquivo de chave privada ou seus diretórios pai.
- Um módulo de segurança do Linux, como SELinux ou AppArmor, está bloqueando o acesso do agente ao arquivo de chave privada.
-
Resolução:
- Certifique-se de que a conta que executa o agente Jitterbit tem acesso de leitura ao arquivo de chave privada e a todos os diretórios pai.
- Verifique se SELinux ou AppArmor está restringindo o acesso ao arquivo de chave e ajuste a política ou o contexto do arquivo conforme necessário.
Erros de transformação e dados
Elementos XML não suportados (CDATA) incorporados em JSON
-
Sintoma: As seções de dados de caracteres (CDATA) não são suportadas em XML incorporado em JSON passado por uma transformação. Quando presentes, o seguinte erro aparece no log de operação:
Transformation failed. Error: The operation "Operation" failed. Error: Failed to convert XML file to JSON. org.jitterbit.integration.server.engine.EngineSessionException: org.xml.sax.SAXParseException ... -
Resolução: Use um script Jitterbit para
Substituiros caracteres&,<,>,'e"dentro da seção CDATA, incluindo os delimitadores CDATA (<![CDATA[ ... ]]>), pelos seus equivalentes escapados (&,<,>,',"). Se não for viável direcionar apenas a seção CDATA, toda a string XML que a contém pode ser substituída.O exemplo a seguir é considerado inválido sem essas substituições:
{
  "name": "Jitterbit",
  "data": "<xml><content><![CDATA[<greeting>Hello, world!</greeting>]]></content></xml>"
}
A transformação falha quando um valor de string JSON excede o comprimento máximo
-
Sintoma: Uma transformação que processa um grande valor de string JSON falha com um erro informando que a string excede o comprimento máximo permitido, por exemplo:
Transformation failed. Error: Error Code: String value length (20054016) exceeds the maximum allowed (20000000, from StreamReadConstraints.getMaxStringLength())O rastreamento de pilha faz referência a
StreamConstraintsExceptione ao analisador JSON do agente. Um gatilho comum é uma resposta do HTTP v2 com Obter conteúdo de resposta em string base64 ativado: a codificação Base64 aumenta o conteúdo binário (como um arquivo de áudio ou mídia), portanto, a string codificada pode exceder o limite mesmo quando o arquivo original é menor. -
Causa: O analisador JSON do agente limita um único valor de string JSON a 20 MB (
20000000caracteres) por padrão. Uma resposta ou valor mapeado maior que isso falha enquanto o agente o analisa, antes de qualquer atividade downstream (como um upload) ser executada. -
Resolução: Em um agente privado executando a versão 12.5 ou posterior, aumente o limite com a chave
MaxStringLengthna seção[JsonParser]do arquivo de configuraçãojitterbit.conf(por exemplo, defina como50000000para um limite de 50 MB) e reinicie o agente. Esta chave está disponível na versão 12.5 do agente e posterior, portanto, atualize o agente primeiro se estiver em uma versão anterior.
Caracteres especiais em esquemas JSON fornecidos por conectores
- Sintoma: Quando uma transformação usa um esquema JSON herdado de uma atividade de conector adjacente, qualquer caractere especial em um nome de campo ou nó de esquema é substituído por sublinhados (
_). Ao usar o processamento JSON legado (o padrão para projetos criados antes do lançamento Harmony 11.48), isso pode fazer com que o endpoint retorne erros porque os nomes de campo reais não correspondem mais ao que ele espera.
Por exemplo, se a atividade fornece um campo chamado location_ids[], ele é convertido para location_ids__. Se o endpoint ainda espera o nome original, pode retornar um erro como:
"error_message": "{location_ids:expected String to be a Array}"
-
Resolução:
-
Confirme que um esquema JSON está sendo usado na atividade afetada. Esses esquemas têm um nó raiz chamado
json: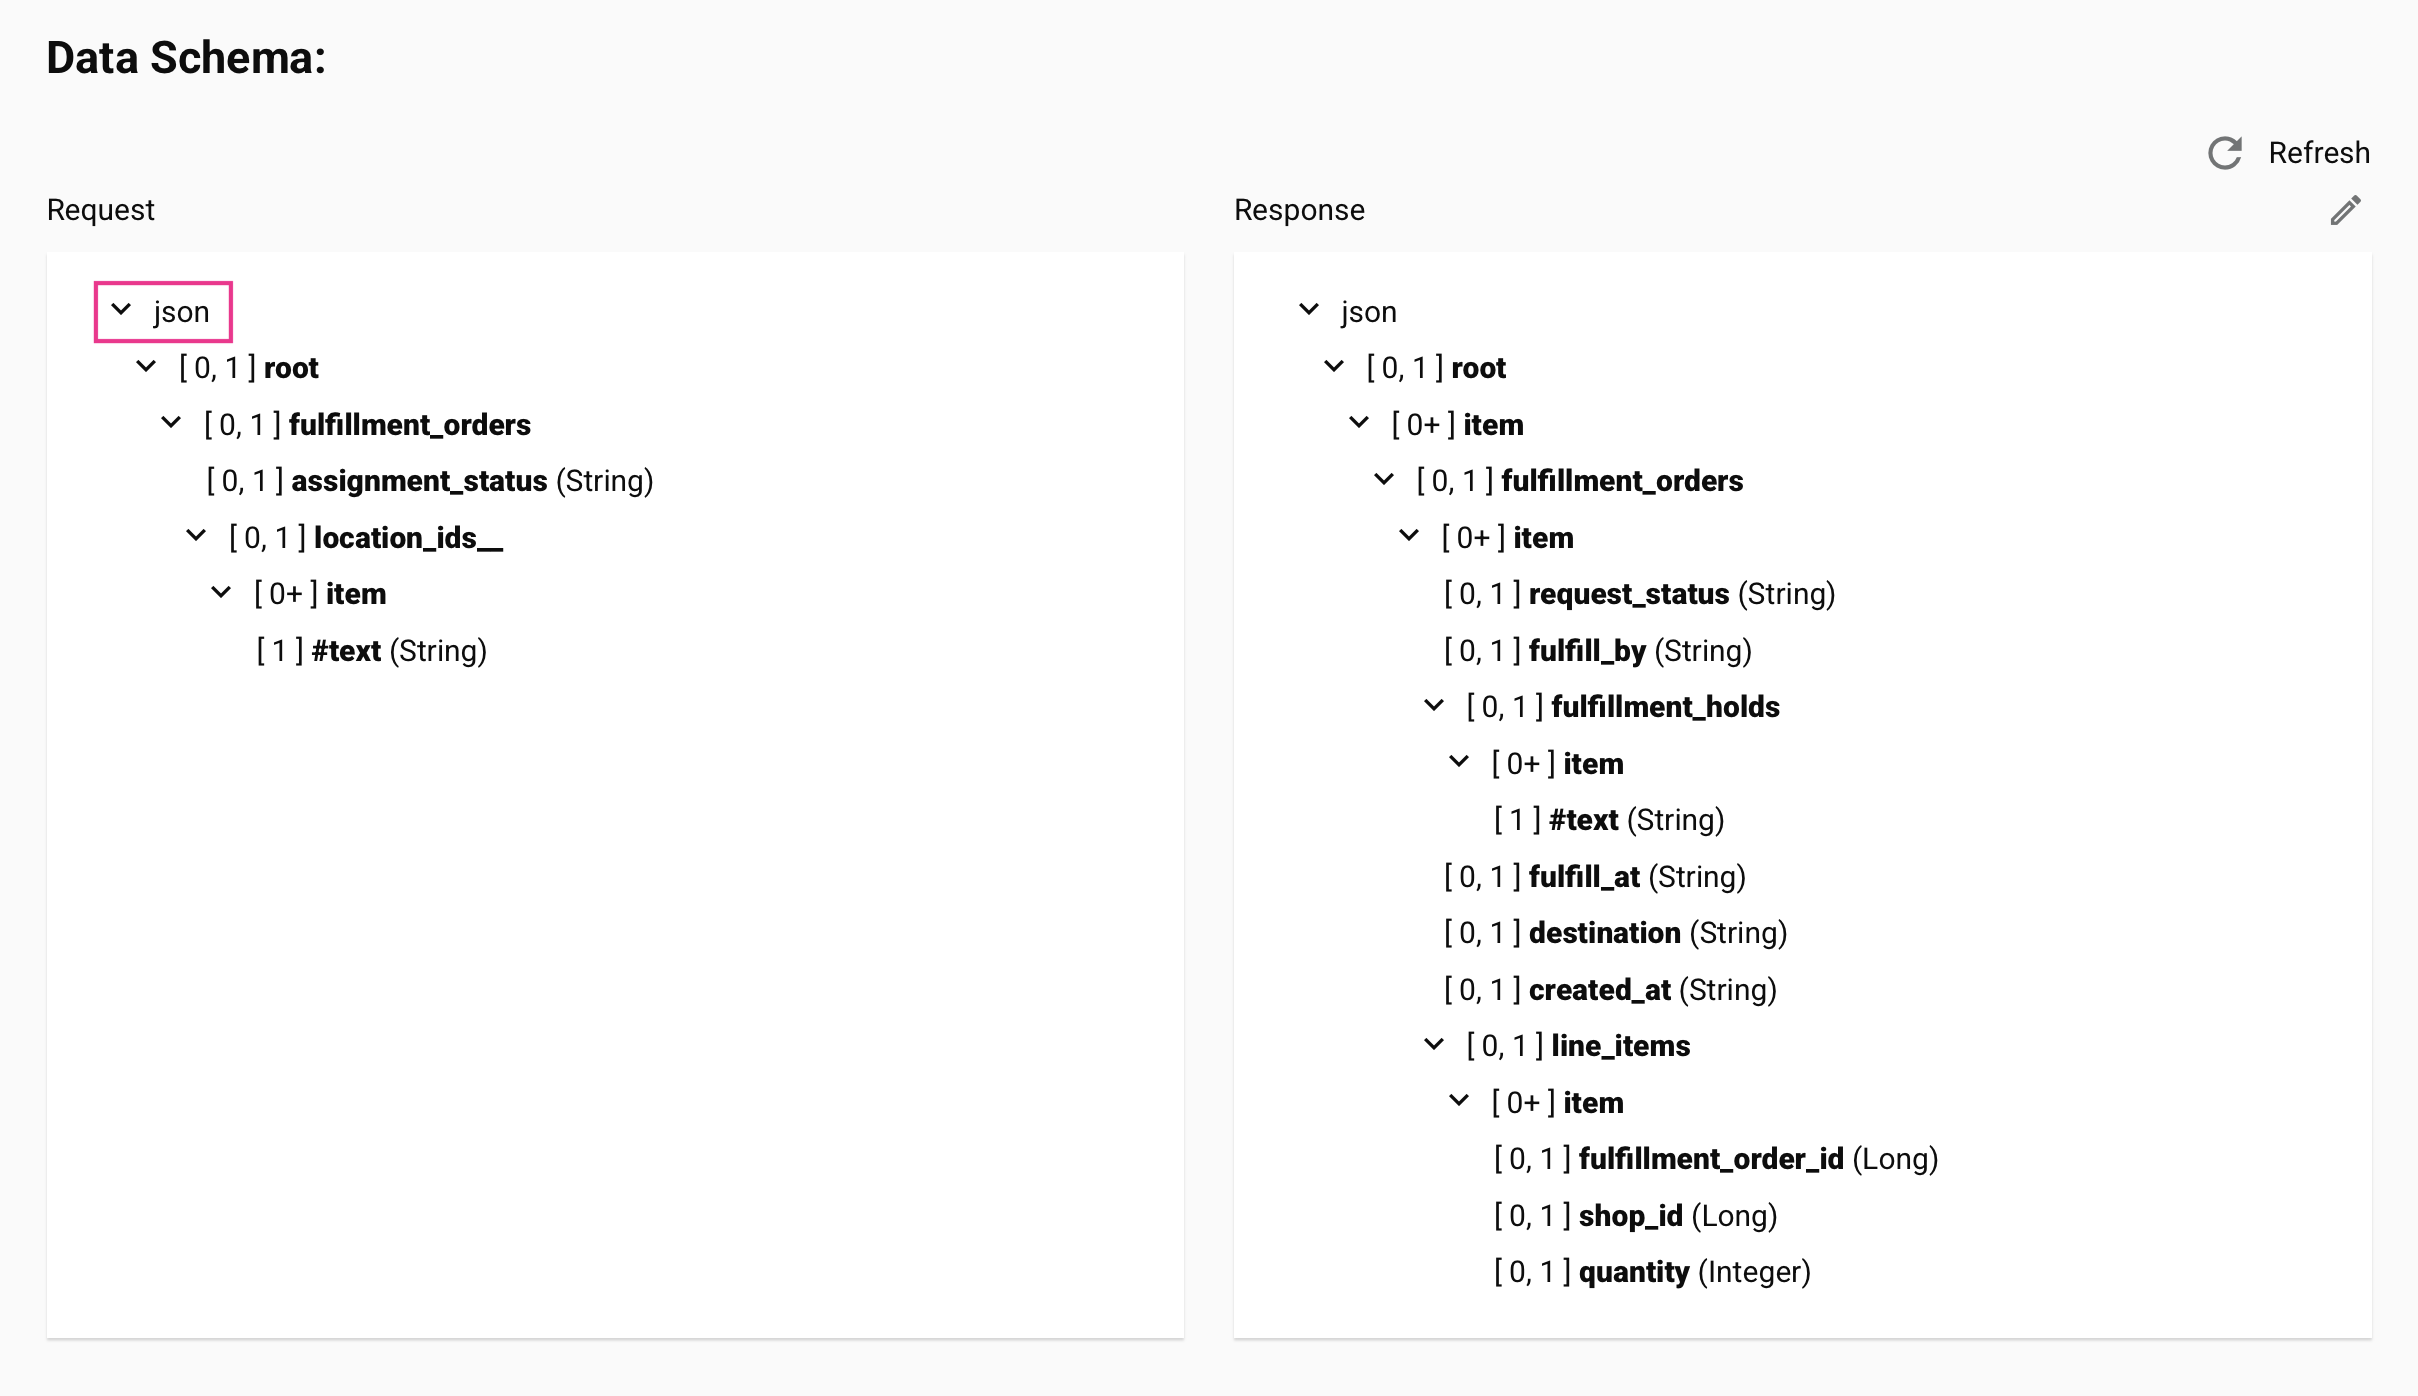
-
Ative a configuração de projeto Preserve JSON names (requer versão do agente 11.48 ou posterior).
- Reconfigure, implante e execute a operação.
Importante
Quando Preserve JSON names é ativado em um projeto onde estava desativado anteriormente, o novo método de processamento se aplica apenas a operações e esquemas configurados após a ativação da configuração. Operações e esquemas existentes continuam usando o processamento JSON legado. Para evitar inconsistências dentro de um projeto, reconfigure todas as operações e esquemas existentes após ativar essa configuração.
Para verificar o nome do campo sendo enviado ao endpoint, verifique o valor
jsonPropertyNamenos dados de entrada ou saída da atividade com log de depuração ativado: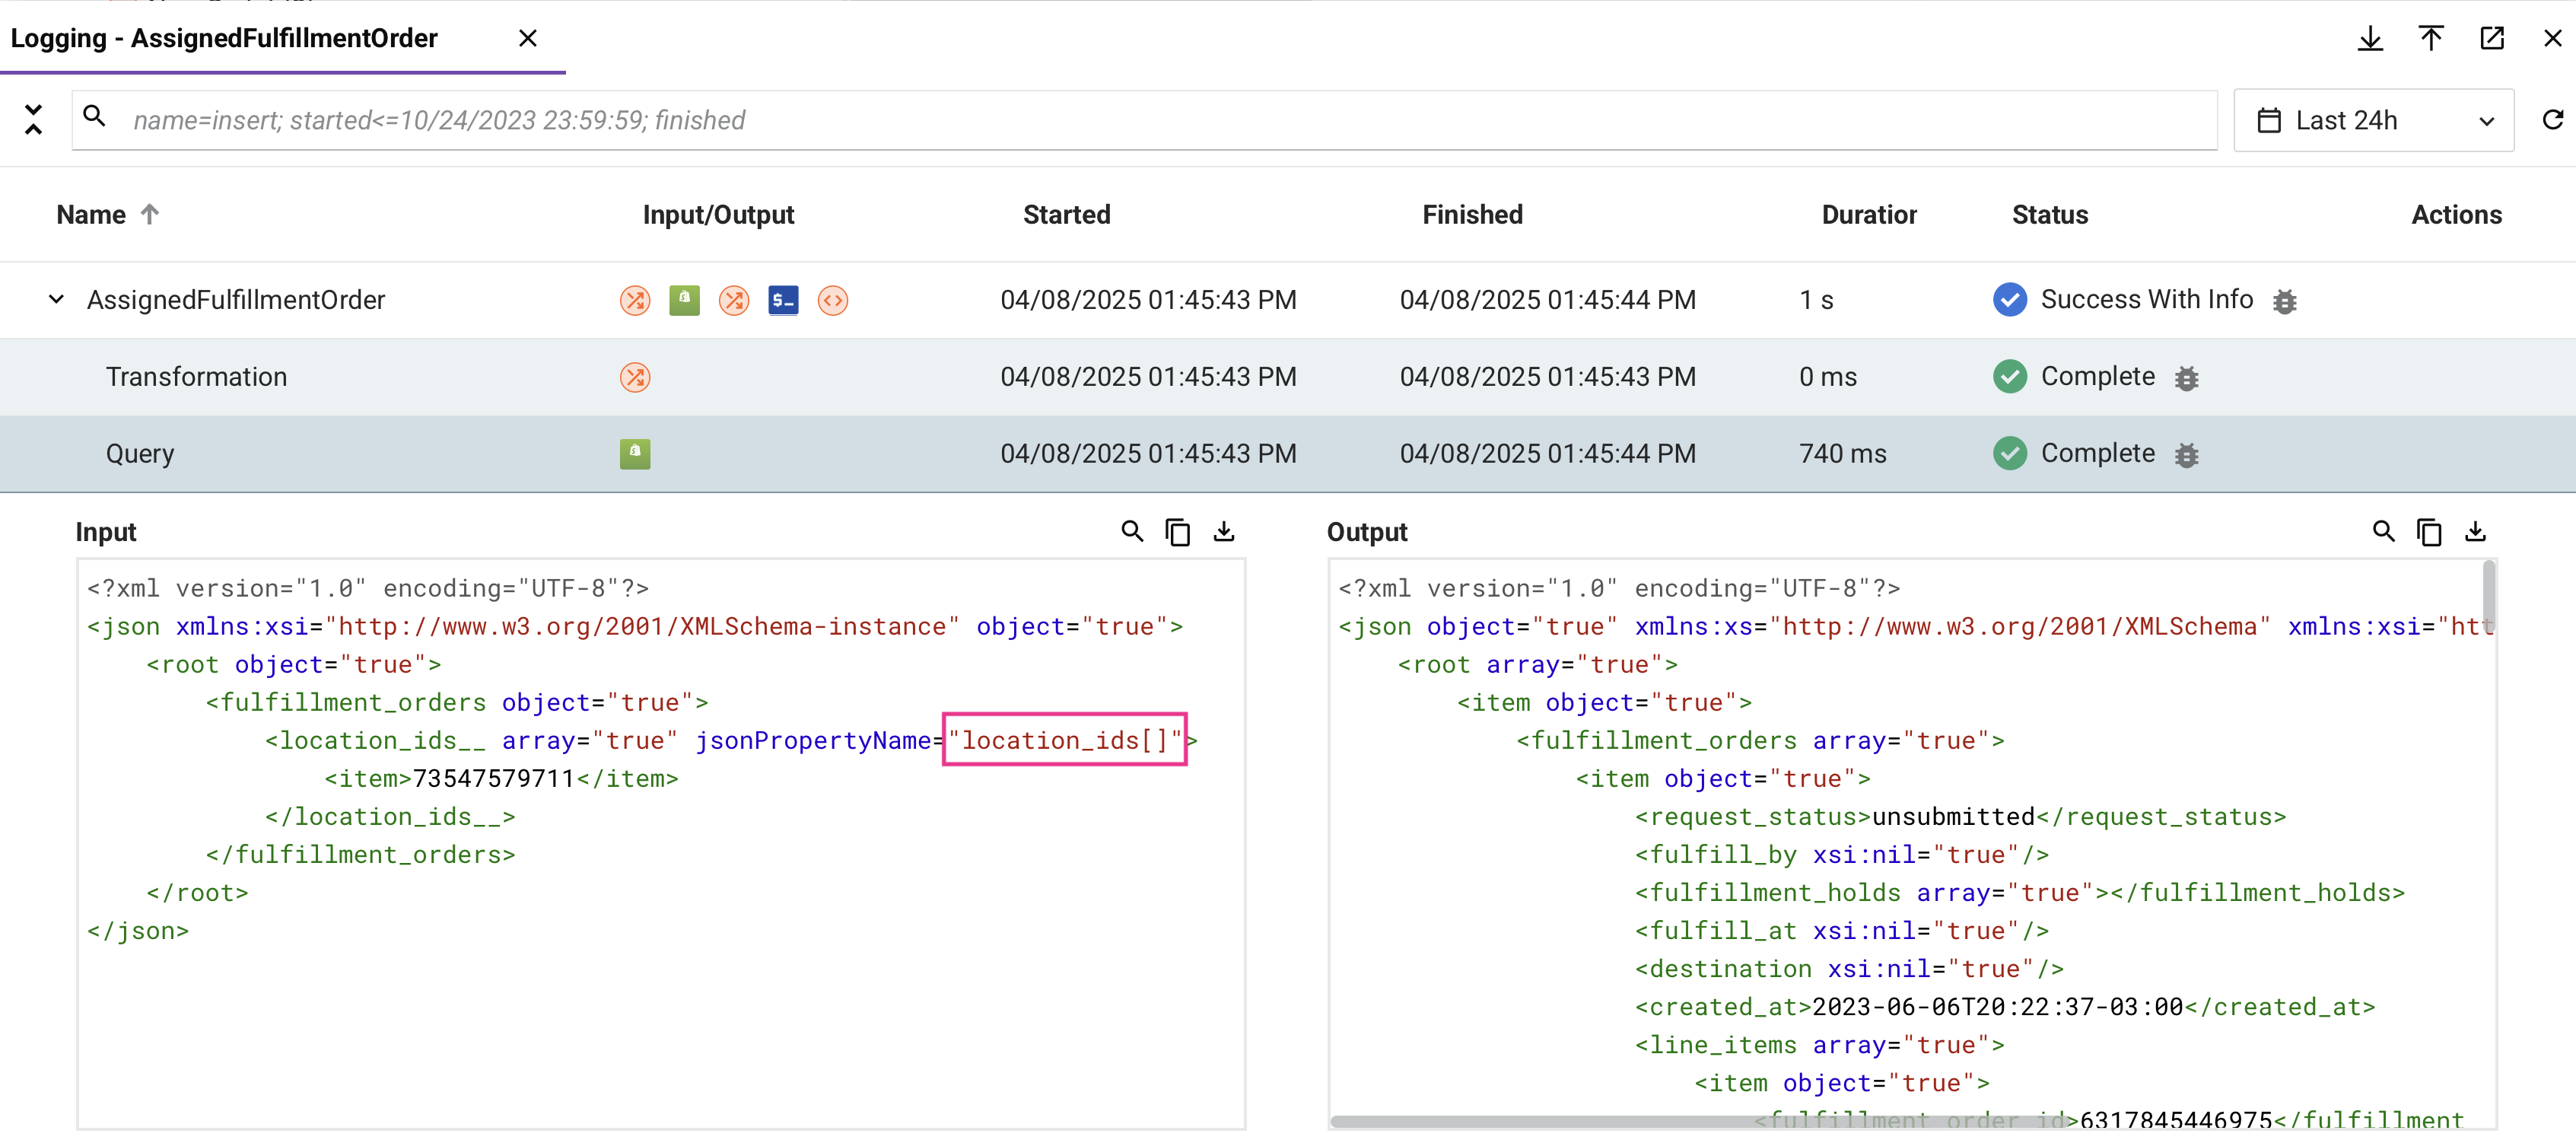
-
Caracteres multibyte corrompidos em uma resposta grande do conector
- Sintoma: Um caractere multibyte em uma resposta do conector JSON está corrompido. O texto corrompido mostra o padrão clássico de bytes UTF-8 decodificados como Latin-1 (por exemplo,
São Luísretornado comoSão LuÃs). Normalmente, apenas um caractere multibyte que aparece após aproximadamente os primeiros 8 KB da resposta é afetado; o mesmo caractere aparecendo antes na resposta não é afetado. - Possível causa: Nas versões 12.8 e 12.9 do agente, a detecção automática de codificação de caracteres amostra apenas o início da resposta para determinar sua codificação. Se essa amostra contiver apenas caracteres ASCII, a resposta é detectada como Latin-1 (ISO-8859-1) em vez de UTF-8, corrompendo qualquer caractere multibyte que apareça além da porção amostrada.
- Resolução: Atualize para a versão 12.10 ou posterior do agente, que corrige a detecção de codificação.
Esquemas espelhados com grupos de substituição
-
Sintoma: Esquemas espelhados que usam grupos de substituição XML não são suportados. Usar um resulta em um erro em tempo de execução:
Failed to initialize transformation "<transformation name>". Failed to expand the (source|target) tree for the path: <path to substitution head node>.Esse erro também pode ocorrer por outros motivos, como importar um mapeamento de transformação com nós duplicados, e não necessariamente indica um problema de grupo de substituição.
-
Resolução: Se grupos de substituição forem a causa confirmada, limpe o esquema espelhado e recrie-o usando um método diferente (upload, criação de esquema personalizado, etc.).
Importar um mapeamento de transformação com nós duplicados falha com "node cannot be created"
- Sintoma: Uma transformação cujo mapeamento foi importado de um arquivo que referencia nós duplicados falha em tempo de execução com um erro como:
Falha ao inicializar a transformação "<transformation name>". Falha ao expandir a árvore de destino para o caminho: <path to node>. O nó: <node name> não pode ser criado.
O mapeamento pode parecer correto no designer de transformação, mesmo que a operação falhe quando executada.
-
Possível causa: Importar um arquivo de mapeamento que adicionou nós duplicados ao esquema de destino não aplicou a alteração correspondente à definição de esquema usada quando a operação é executada, deixando os dois fora de sincronização. Isso foi corrigido, mas uma transformação cujo mapeamento foi importado antes da correção ainda pode ser afetada.
-
Resolução: Na transformação afetada, use Remover todos os mapeamentos abaixo deste nó no nó raiz para remover todos os mapeamentos e, em seguida, importe o arquivo de mapeamento novamente. Reimportar ressincroniza a definição de esquema usada em tempo de execução com o mapeamento. Se o erro persistir, reconfigure a atividade que fornece o esquema e, em seguida, atualize o esquema na transformação.
Reprocessamento de esquema XML espelhado em projetos criados antes da versão 10.25
-
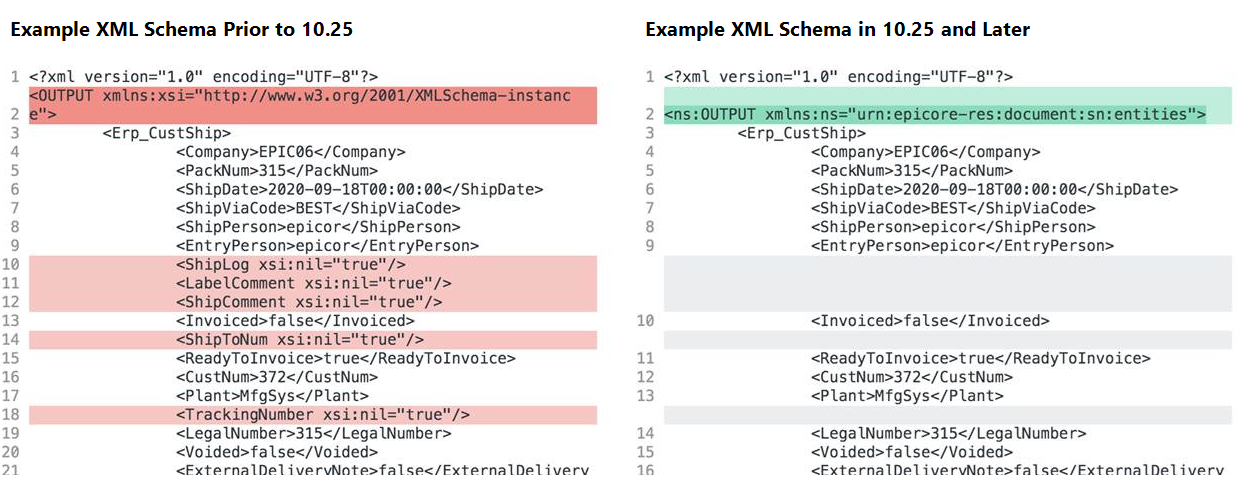
Sintoma: Devido a alterações nas versões do Harmony 10.25 e 10.27, projetos criados antes de 10.25 que usam esquemas XML espelhados podem se comportar de forma diferente do esperado. Mapeamentos que usaram funções XML envolvendo namespaces (como
SelectNodes) podem agora ser inválidos.A diferença está no tratamento do prefixo de namespace:
- Antes de 10.25: Esquemas XML espelhados usavam o prefixo de namespace padrão
xsi. - 10.25 e posterior: Esquemas XML espelhados usam o prefixo de namespace qualificado
ns. Campos não mapeados não são exibidos no esquema.
- Antes de 10.25: Esquemas XML espelhados usavam o prefixo de namespace padrão
-
Resolução: A partir da versão 10.27, importar um projeto cujos esquemas XML espelhados foram criados antes de 10.25 retém o prefixo de namespace original, portanto o esquema é idêntico a quando foi criado. Para forçar uma atualização para o prefixo de namespace atual, regenere o esquema atualizando-o ou reconfigurando a atividade que o fornece. Após regenerar, revise todas as chamadas de função de namespace XML afetadas e atualize as referências de prefixo de acordo.
Consulte a comparação de esquema XML anotado para uma ilustração da diferença entre os dois formatos.
Aviso de subelemento extra nos logs de operação
- Sintoma: Uma mensagem
extra subelementnos logs de operação é um aviso, não um erro, e geralmente pode ser ignorada. Indica que a carga útil da API de um conector retornou mais nós ou campos do que estão definidos no esquema de dados de resposta. - Resolução: Se você precisar capturar os dados adicionais, atualize o esquema para incluir os campos extras.
Saída de transformação convertida para 0 para campos de destino com tipo de dados double
- Sintoma: Um campo de destino com tipo de dados
doubleno esquema recebe um valor de0mesmo que o script de mapeamento retorne um valor de string não vazio. - Possível causa: Quando a transformação processa uma saída de script, ela converte o resultado para o tipo de dados do campo de destino. Se o valor da string começar com um caractere não numérico (por exemplo,
"string1"), nenhuma porção numérica pode ser extraída e o campo recebe o valor numérico padrão de0. Por outro lado, um valor como"1string"produziria1, já que o dígito inicial é mantido. - Resolução:
- Verifique a definição do esquema para o campo de destino afetado e confirme se seu tipo de dados é
doubleou outro tipo de dados numérico. - Se o script de mapeamento puder retornar uma string não numérica, adicione validação explícita para garantir que apenas valores numéricos sejam mapeados para campos de destino numéricos, ou altere o tipo de dados do campo no esquema.
- Verifique a definição do esquema para o campo de destino afetado e confirme se seu tipo de dados é
Campos mapeados em branco com esquemas de origem simples
- Sintoma: Os campos de destino aparecem em branco na saída da operação mesmo que os dados de origem contenham valores. Este problema ocorre especificamente ao usar um esquema de origem simples. Não ocorre com esquemas espelhados ou esquemas JSON.
- Possível causa: O modo de transformação de streaming padrão processa registros incrementalmente, o que pode fazer com que campos mapeados não recebam valores quando usados com esquemas de origem simples.
-
Resolução:
-
Adicione uma etapa de script no início da operação que desabilite as transformações de streaming definindo
jitterbit.transformation.auto_streamingcomofalse:$jitterbit.transformation.auto_streaming = false; -
Implante e execute novamente a operação. Para mais contexto sobre streaming e processamento de transformação, consulte Processamento de transformação.
-
Nó de loop de destino mapeado para múltiplos nós de loop de origem
-
Sintoma: Uma transformação é inválida ou falha ao ser implantada com:
Mappings of a target loop node depend on more than one source loop node. -
Possível causa: Um nó de loop de destino possui mapeamentos de campo que fazem referência a dois ou mais nós de loop de origem diferentes. Cada nó de loop de destino pode iterar apenas sobre um único nó de loop de origem.
- Resolução:
- Abra a transformação e identifique o nó de loop de destino indicado no erro.
- Revise os mapeamentos sob esse nó para confirmar que todos os campos mapeados derivam do mesmo nó de loop de origem.
- Se dados de múltiplos nós de origem forem necessários, pré-processe ou mescle os dados de origem adicionais em uma etapa de script antes da transformação, para que um único nó de origem unificado alimente o loop de destino.
- Para mais detalhes sobre padrões de mapeamento válidos, consulte Validade de mapeamento de transformação.
Transformação descarta registros duplicados quando a saída é hierárquica
- Sintoma: Uma transformação que lê uma origem CSV e mapeia para um formato de saída hierárquico (como JSON) descarta silenciosamente registros duplicados. Registros com valores de campo idênticos aparecem apenas uma vez na saída, independentemente de quantas vezes ocorrem na origem. A operação é concluída com sucesso, mas relata menos registros de destino do que registros de origem.
- Possíveis causas:
- Ao converter dados de origem simples para um formato de saída hierárquico, o mecanismo de transformação remove registros duplicados durante a normalização. Registros com valores idênticos após análise são tratados como duplicados e apenas uma cópia é mantida.
- Este comportamento é específico para saída hierárquica. Quando o esquema de saída é simples, a normalização não é executada e todos os registros são gravados.
- O mecanismo de transformação também remove espaços em branco à esquerda e à direita dos valores de campo CSV por padrão. Registros que diferem apenas por espaços à esquerda ou à direita tornam-se idênticos após a remoção e estão sujeitos à mesma desduplicação.
- Resolução:
- Ative o chunking nas opções de operação. O chunking processa registros em lotes, o que ignora a normalização e preserva todos os registros, incluindo duplicados.
- Use um esquema de saída simples na transformação em vez de um hierárquico. A normalização não se aplica à saída simples, portanto todos os registros são preservados.
- Desabilite a normalização definindo uma variável Jitterbit em uma etapa de script anterior à transformação. Para transformações simples para simples, defina
jitterbit.transformation.disable_normalizationcomotrue. Para transformações simples para XML, definajitterbit.transformation.flat_to_xml.disable_normalizationcomotrue(requer agente 11.58 ou posterior). Ambas as variáveis podem afetar outras transformações na mesma operação, portanto teste a alteração cuidadosamente. - Se os duplicados forem causados especificamente por diferenças de espaço em branco, defina
jitterbit.source.preserve_char_whitespacecomotrueem uma etapa de script anterior à transformação. Isso preserva o espaço em branco durante a análise para que os registros afetados permaneçam distintos.
IDs numéricos longos são corrompidos na saída da transformação
- Sintoma: Um valor numérico longo (por exemplo, um número de rastreamento, número de conta ou ID externo) é enviado para o destino com um valor incorreto. O número é muito grande para caber no tipo numérico implícito usado durante o mapeamento, causando um estouro e produzindo um valor incorreto no destino.
- Possível causa: O campo de origem ou destino é implicitamente tipado como um tipo de dado numérico cujo intervalo não consegue conter o valor completo, causando um estouro durante a conversão.
- Resolução:
- Na transformação, defina o tipo de dado do campo de destino afetado como String em vez de um tipo numérico. IDs longos que não são usados em operações aritméticas devem ser tratados como strings.
-
Se o campo de origem também for tipado numericamente, converta o valor explicitamente com
Stringantes de mapeá-lo:String($source.numericId)
A saída da transformação JSON omite campos null e de string vazia
- Sintoma: Uma transformação JSON remove campos cujo valor é
nullou uma string vazia ("") da carga de saída, mesmo que esses campos sejam mapeados explicitamente. O sistema de destino recebe uma carga que não inclui os campos omitidos, o que pode causar erros de validação a jusante quando o destino exige que os campos estejam presentes. - Possível causa: O processador de saída JSON omite campos com valores
nullou string vazia por padrão. - Resolução:
- Em uma etapa de script anterior à transformação, defina
jitterbit.target.xml.include_nil_attributecomotrue. Na versão do agente 11.37 ou posterior, isso inclui valoresnulle strings vazias na saída JSON, correspondendo à entrada. (Apesar doxmlem seu nome, essa variável se aplica a destinos JSON.) - Se você precisar de controle total sobre quais campos aparecem na carga, construa o corpo JSON em uma etapa de script usando concatenação de strings e envie-o através de um conector HTTP v2 com um corpo de solicitação sem schema.
- Em uma etapa de script anterior à transformação, defina
Campos mapeados vazios se tornam xsi:nil="true" e invalidam uma solicitação XML ou SOAP
-
Sintoma: Em uma transformação XML ou SOAP, um campo mapeado com um valor vazio é emitido como um elemento nil, e o endpoint de destino rejeita a solicitação. Por exemplo, um mapeamento de número de telefone vazio produz:
<ns1:Phone_Number xsi:nil="true"/>Alguns endpoints (por exemplo, serviços SOAP do Workday) tratam isso como inválido e retornam um erro.
-
Causa: Por padrão, quando um mapeamento para um nó de destino resulta em um valor nulo ou vazio, a transformação inclui o nó mas o marca como nil (
xsi:nil="true"). Isso é controlado porjitterbit.target.xml.include_null_xml, cujo padrão étrue. -
Resolução: Em uma etapa de script anterior à transformação, defina
$jitterbit.target.xml.include_null_xml = falsepara remover completamente da saída os nós com valor nulo ou vazio. Se, em vez disso, o nó deve estar presente como um elemento vazio, use as variáveis Jitterbit de destino relacionadasjitterbit.target.xml.include_empty_xmlejitterbit.target.xml.include_nil_attribute, que controlam se valores vazios e nulos são incluídos na saída.
Marca de ordem de byte (BOM) em um arquivo de origem é passada para o valor do primeiro registro
- Sintoma: Quando um arquivo de origem (por exemplo, um arquivo CSV) começa com uma marca de ordem de byte (BOM) UTF-8, o primeiro campo do primeiro registro na saída da transformação contém um caractere extra ou inesperado que não faz parte dos dados de origem, em vez do valor esperado. Arquivos exportados como CSV UTF-8 do Microsoft Excel geralmente incluem este BOM.
- Possível causa: O Studio lê o conteúdo de um arquivo de origem como está e não detecta nem remove um BOM inicial. Os bytes brutos do BOM se tornam parte do valor do primeiro campo uma vez que o arquivo é analisado em registros.
- Resolução: Inspecione o valor do campo afetado para identificar os caracteres exatos produzidos pelo BOM e, em seguida, mapeie o campo usando
Replacepara removê-los. Na versão do agente 12.6 ou anterior, onde UTF-8 não é o padrão, você também pode definir explicitamente a codificação de caracteres como UTF-8 antes da atividade de origem ser executada, por exemplo$jitterbit.source.text.character_encoding = "utf-8";. A versão do agente 12.7 e posterior usam UTF-8 por padrão.
Erros de script e função
Funções de arquivo: Operação continua após falha de ArchiveFile ou ReadFile
- Sintoma: Uma operação é concluída com status de sucesso, mas os arquivos não foram arquivados ou os dados não foram lidos conforme esperado. Nenhum erro aparece no resultado da operação, apenas um aviso no log da operação.
- Possível causa:
ArchiveFileeReadFiletêm comportamento de falha suave: se qualquer uma das funções falhar, o script atual é abortado e um aviso é adicionado ao log da operação, mas a operação em si não falha e as etapas subsequentes continuam. A partir da versão do agente 12.5, há uma exceção:ArchiveFilechamado comdeleteSourcedefinido comotruelança um erro capturável quando o arquivo de origem não pode ser deletado, em vez de falhar silenciosamente. - Resolução:
- Verifique os logs da operação para mensagens de aviso quando uma operação é bem-sucedida mas a saída de arquivo esperada está faltando.
- Se o script deve parar em uma falha de função de arquivo, envolva a chamada em uma função
Evale chameRaiseErrorexplicitamente para promover o aviso a uma falha de operação.
ReadFile: Leituras parciais com conteúdo de arquivo binário
- Sintoma: Um script usando
ReadFilepara ler um arquivo binário (como um ZIP ou PDF) retorna dados incompletos ou corrompidos. - Possível causa:
ReadFilenão é confiável com conteúdo de arquivo binário e geralmente lê apenas uma parte desses arquivos. - Resolução: Use
Base64EncodeFileem vez deReadFilepara ler o conteúdo completo de um arquivo binário como uma string codificada em Base64.
Conteúdo de ReadFile com bytes não-UTF-8 falha quando mapeado em uma carga XML ou JSON UTF-8
-
Sintoma: Uma transformação que mapeia conteúdo de arquivo bruto lido com
ReadFile(por exemplo, um arquivo EDI bruto) para um campo de destino XML ou JSON em UTF-8 falha durante a conversão XML ou JSON. Substituir o valor mapeado por uma string codificada permite que a operação seja concluída, o que confirma que o conteúdo bruto é o gatilho. Tentativas de remover o caractere ofensivo usando seu ponto de código Unicode (por exemplo,Replace($readFile, HexToString("2026"), "~")para a reticênciaU+2026) não correspondem, e chamarStringToHexno conteúdo com suporte Unicode ativado lança:not a UTF-8 string, byte not in range: 13 -
Causa: O conteúdo do arquivo contém um byte que não é UTF-8 válido (por exemplo, o byte único
0x85, que alguns arquivos EDI usam como terminador de segmento). Este byte bruto não é o mesmo que a codificação UTF-8 multibyte de um caractere Unicode de aparência similar (a reticênciaU+2026é codificada como três bytes), portanto uma substituição direcionada ao ponto de código Unicode nunca corresponde. Comjitterbit.scripting.hex.enable_unicode_supportdefinido comotrue, as funções hex interpretam o conteúdo como UTF-8 e falham no byte inválido. -
Resolução: Corresponda e substitua o byte bruto com suporte Unicode hex desativado, para que
HexToStringfuncione em bytes brutos em vez de caracteres UTF-8:$jitterbit.scripting.hex.enable_unicode_support = false; $badByte = HexToString("85"); $readFile = Replace($readFile, $badByte, "~");Ajuste o valor hex (
85) para o byte informado porStringToHex($readFile)e a string de substituição (~) conforme necessário, depois mapeie o valor sanitizado.
FlushFile / FlushAllFiles: Erro quando o arquivo de destino já existe
- Sintoma: Um script falha ao tentar gravar um arquivo em um destino que já contém um arquivo com o mesmo nome.
- Possível causa:
FlushFileeFlushAllFiles(e por extensãoArchiveFile) lançam um erro se um arquivo com o nome de destino já existe no local de destino. - Resolução:
- Adicione uma chamada
DeleteFileouDeleteFilesantes da operação de gravação para remover o arquivo existente. - Alternativamente, use um nome de arquivo dinâmico que inclua um timestamp ou identificador único para evitar conflitos.
- Adicione uma chamada
DeleteFiles: Erro quando o caminho de origem não pode ser encontrado
- Sintoma: Um script usando
DeleteFilesfalha com um erro quando o caminho de origem ou diretório especificado não pode ser encontrado. (Um filtro que não corresponde a nenhum arquivo retorna0em vez de um erro.) - Possível causa: Se o caminho de origem não puder ser encontrado,
DeleteFileslança um erro em vez de retornar silenciosamente. Isso pode causar falhas inesperadas de operação quando o arquivo a ser excluído não existe. - Resolução: Envolva a chamada
DeleteFilesem uma funçãoEvalpara capturar o erro e tratá-lo sem falhar na operação.
GetJSONString: Execução interrompida em caminho inválido
- Sintoma: Um script que chama
GetJSONStringfalha quando o caminho fornecido não é resolvido no JSON (por exemplo, o nó está ausente ou uma matriz está vazia). O erro é genérico e não identifica o caminho como a causa; quando a operação é invocada por meio de uma API, pode aparecer como umProxy Error [502]enganoso retornado ao chamador da API. - Possível causa: Se o argumento
pathpassado paraGetJSONStringfor inválido ou não corresponder a nenhum dado, a função interrompe o fluxo de execução imediatamente e retorna um erro, o que pode fazer com que todo o script seja abortado. - Resolução:
- Valide o caminho JSON antes de passá-lo para
GetJSONString, ou (na versão do agente 11.59 / 12.3 ou posterior) useGetJSONStringEx, que retorna um valor personalizável em vez de interromper a execução quando o caminho é inválido ou não encontrado. - Registre o payload JSON imediatamente antes da chamada
GetJSONStringpara verificar a estrutura real e confirmar o caminho.
- Valide o caminho JSON antes de passá-lo para
Limite de iteração de loop de script excedido
- Sintoma: Um script falha com um erro indicando que o número máximo de iterações de loop foi atingido. O limite padrão é 50.000 iterações.
- Possíveis causas:
- Um loop em um script Jitterbit excede o limite de iterações da plataforma.
- Um script JavaScript contém múltiplos loops cujas contagens de iterações combinadas excedem 50.000. Em JavaScript, o limite se aplica por script (em todos os loops), não por loop individual.
- Resolução:
- Revise a lógica do script para determinar se o loop pode ser otimizado para reduzir o número de iterações.
- Para scripts JavaScript em agentes privados, o limite por script pode ser aumentado adicionando
JavaScriptMaxIterations=X(ondeXé maior que50000) à seção[Settings]do arquivo de configuração do agente privado. - Para Jitterbit Script em agentes privados, aumente o limite definindo
jitterbit.scripting.while.max_iterationspara um valor maior que50000.
Comparar uma string com um número produz resultados inesperados
-
Sintoma: Uma comparação entre uma string e um número retorna um resultado inesperado. Por exemplo, comparar uma string não numérica com
0é avaliado como igual, então o branch errado é executado:$value = "test"; If($value == 0, WriteToOperationLog("equal"), WriteToOperationLog("not equal")); // logs "equal", even though "test" is not 0 -
Causa: Quando os dois operandos são de tipos diferentes, o Jitterbit Script converte ambos para números para compará-los. Uma string que não representa um número é convertida para
0, então"test" == 0se torna0 == 0, que étrue. Este é o comportamento esperado. -
Resolução: Compare valores do mesmo tipo. Para testar uma string contra um valor específico, compare-a com um literal de string (por exemplo,
$value == "0"ou$value == "") em vez de um número. Se um valor puder chegar como qualquer tipo, converta ambos os operandos para o mesmo tipo (por exemplo, comString) antes de comparar.
Unmap não desmapeia um campo quando usado junto com RunScript
-
Sintoma: A expressão de mapeamento de um campo de destino envolve tanto
RunScriptquantoUnmap, mas o campo não é desmapiado. Para um destino JSON ou XML, o campo aparece na saída com um valornullem vez de ser omitido. -
Possíveis causas:
RunScriptprecedeUnmapna mesma expressão de mapeamento (por exemplo,RunScript("<TAG>script:MyScript</TAG>"); Unmap();). Em versões de agente anteriores à 12.9, essa combinação não desmapiava o campo.Unmapé chamado de dentro do script invocado porRunScript, em vez de diretamente na própria expressão de mapeamento do campo de destino.RunScriptretorna o resultado do script chamado como uma string em vez de propagar um sinal de desmapeamento de volta para o mapeamento, portanto chamarUnmapde dentro do script chamado não tem efeito, em qualquer versão de agente, independentemente de qualquer lógica condicional em torno da chamada. Este é o comportamento esperado.
-
Resolução:
- Se
RunScripteUnmapforem ambos chamados diretamente na expressão de mapeamento do campo de destino, atualize para a versão 12.9 do agente ou posterior. -
Se
Unmapfor chamado de dentro do script invocado porRunScript, mova a chamadaUnmappara fora do script chamado e para a própria expressão de mapeamento do campo de destino, por exemplo:RunScript("<TAG>script:MyScript</TAG>"); If(<condition>, Unmap(), <value>);
- Se
DBExecute: Erro quando auto_commit e transaction são ambos true
- Sintoma: Uma operação usando
DBExecutefalha com um erro relacionado a configurações de transação conflitantes. - Possível causa: Tanto
jitterbit.scripting.db.auto_commitquantojitterbit.scripting.db.transactionestão definidas comotrueno script antes da chamadaDBExecute. Essas duas configurações são mutuamente exclusivas e combiná-las causa um erro. - Resolução: Decida se você precisa de comportamento de auto-commit ou controle de transação explícito e defina apenas a variável apropriada:
- Para auto-commit (cada instrução confirmada imediatamente): defina
$jitterbit.scripting.db.auto_commit = truee deixejitterbit.scripting.db.transactionindefinida oufalse. - Para controle de transação (confirmação ao final da transformação): defina
$jitterbit.scripting.db.transaction = trueejitterbit.scripting.db.auto_commit = false.
- Para auto-commit (cada instrução confirmada imediatamente): defina
CallStoredProcedure: resultSet sempre nulo com drivers ODBC
- Sintoma: Um script usando
CallStoredProcedureretornanullpara o parâmetroresultSetmesmo que o procedimento armazenado retorne dados. - Possível causa: O parâmetro
resultSeté suportado apenas por drivers de banco de dados JDBC. Quando o endpoint de banco de dados usa um driver ODBC,resultSeté semprenullindependentemente do que o procedimento armazenado retorna. - Resolução:
- Se o conjunto de resultados do procedimento armazenado for necessário, mude o endpoint de banco de dados para usar um driver JDBC em vez de ODBC.
- Se a mudança de drivers não for possível, recupere dados de saída por meio de parâmetros de saída em vez do argumento
resultSet.
CallStoredProcedure: "Stored proc or function could not be found" com PostgreSQL JDBC
-
Sintoma: Um script usando
CallStoredProcedureem um banco de dados PostgreSQL falha com:CallStoredProcedure failed to execute call "<function-name>". java.sql.SQLException: Stored proc or function could not be found: <function-name> -
Possível causa: O driver JDBC do PostgreSQL faz distinção entre funções e procedimentos.
CallStoredProceduresempre constrói sua chamada usando um padrão que o driver interpreta como uma busca por um procedimento. Se o objeto do banco de dados for uma função PostgreSQL em vez de um procedimento, o driver não consegue localizá-lo e retorna o erro "not found". - Resolução:
- Determine se o objeto do banco de dados sendo chamado é uma função PostgreSQL (retorna um valor) ou um procedimento (sem valor de retorno).
-
Substitua
CallStoredProcedureporDBExecutee use a sintaxe SQL correta para o tipo de objeto:-
Função: use
SELECT.$result = DBExecute("<TAG>Sources/My DB Connection</TAG>", "SELECT my_function(arg1, arg2)");DBExecuteretorna um conjunto de resultados. Use um loopWhilecomGetpara ler os valores retornados. -
Procedimento: use
CALL.DBExecute("<TAG>Sources/My DB Connection</TAG>", "CALL my_procedure(arg1, arg2)");Procedimentos PostgreSQL não retornam um valor; o valor de retorno de
DBExecutepode ser descartado.
-
DBLoad: Requer um driver de banco de dados JDBC
- Sintoma: Uma operação usando
DBLoadfalha ou não produz saída quando o endpoint de banco de dados usa um driver ODBC. - Possível causa:
DBLoadfunciona apenas com endpoints de banco de dados configurados para usar um driver JDBC. Não é suportado com drivers ODBC. - Resolução: Confirme se o endpoint de banco de dados associado à atividade de destino usa um driver JDBC. Se usar um driver ODBC, mude para JDBC.
AESDecryption falha com dados criptografados no OpenSSL 3
- Sintoma: Uma operação usando
AESDecryptionfalha ou retorna saída corrompida ao descriptografar dados que foram criptografados usando OpenSSL 3. - Possível causa:
AESDecryptionusa um algoritmo AES legado por padrão que não é compatível com criptografia OpenSSL 3. Quando os dados criptografados foram produzidos com OpenSSL 3, a descriptografia falha sem configuração adicional. - Resolução:
- Para agentes privados versão 11.42 ou posterior, defina
jitterbit.scripting.aes.defaultcomotrueem uma etapa de script anterior à chamada deAESDecryptionpara ativar a compatibilidade com OpenSSL 3. - Como alternativa, substitua
AESDecryptionporAESDecryptionEx, que oferece suporte a OpenSSL 3 por padrão em versões de agente 11.42 ou posterior.
- Para agentes privados versão 11.42 ou posterior, defina
Variáveis de projeto retornam valores vazios durante testes de script e transformação
- Sintoma: Ao testar uma etapa de script ou transformação no Studio, uma variável de projeto referenciada no script ou mapeamento retorna um valor vazio em vez do valor configurado. O teste pode falhar com um erro não relacionado à variável em si (por exemplo, um tempo limite de conexão causado por um endereço de servidor em branco).
- Possível causa: Os valores das variáveis de projeto são injetados em tempo de execução pela plataforma Harmony. Durante um teste em tempo de design, nenhum contexto de tempo de execução existe para injetar esse valor, portanto, uma referência de variável de projeto retorna um valor vazio, a menos que a variável tenha um Valor padrão configurado para usar como fallback.
- Resolução:
- Defina um valor padrão na variável de projeto: Na configuração da variável de projeto, insira o valor a ser usado durante o teste no campo Valor padrão. Esta é a correção mais simples para um valor configurado estaticamente. Observe que o padrão é usado sempre que a variável não foi definida em tempo de execução (não apenas durante testes em tempo de design), portanto, em tempo de execução também funciona como um fallback quando a variável não está definida. Consulte Variáveis de projeto para detalhes de configuração.
- Use uma variável global: Substitua a referência da variável de projeto por uma variável global e atribua seu valor dentro do script, antes da linha que a utiliza. Como uma variável global obtém seu valor da execução do script em vez da injeção em tempo de execução, atribuir um valor antes do uso a torna disponível durante um teste em tempo de design. Prefira isso quando o valor é derivado em um script ou quando você não deseja um valor de fallback em tempo de execução. Consulte Variáveis globais para detalhes. Se a variável global for referenciada em um campo de configuração do conector em vez de diretamente em um script, você também deve definir um valor padrão por campo para esse campo (consulte Definir um valor padrão, que aborda tanto o método de pill de variável quanto o método de sintaxe inline para campos que não mostram um pill).
IsNull retorna false para strings vazias de dados de origem JSON
- Sintoma:
IsNullretornafalsepara um campo mapeado de uma origem JSON, mesmo quando o campo parece não ter valor. A lógica downstream que depende da verificação de nulo se comporta de forma inesperada ou produz resultados incorretos. - Possível causa: JSON distingue entre um valor ausente ou explicitamente
nulle uma string vazia (""). Um campo definido como""em JSON é uma string vazia, não nulo, portantoIsNullretorna corretamentefalsepara ele. A partir do agente 11.37, o agente preserva essa distinção com precisão. Scripts ou transformações que anteriormente dependiam deIsNullretornartruepara strings vazias dependiam de um comportamento anterior que não é mais correto. -
Resolução:
-
Use
IfEmptypara lidar com null e strings vazias: A funçãoIfEmptyretorna um valor padrão quando o argumento é nulo ou uma string vazia, e é a substituição recomendada para este cenário:// Retorna "default" se o campo for nulo ou uma string vazia result = IfEmpty($myField, "default"); -
Use
Lengthpara testar strings vazias explicitamente: Se você só precisa verificar se uma string está vazia (não nula), useLength($myField) == 0. - Corrija os dados de origem: Se a origem JSON deve indicar nenhum valor, atualize-a para enviar
"field": nullou omita o campo inteiramente em vez de"field": "".
-
Comparar uma variável string com o número 0 retorna inesperadamente true
- Sintoma: Uma comparação como
$myVar == 0retornatruemesmo quando$myVarcontém uma string não numérica (por exemplo,"test"). CondiçõesIfe outra lógica que verifica zero produzem resultados inesperados. - Possível causa: Quando o Jitterbit Script compara valores de tipos de dados diferentes, ele tenta converter ambos os operandos para doubles como etapa final. Quando aplicado a uma string não numérica, a conversão falha e retorna
0como valor padrão. A comparação então é avaliada como0 == 0, que étrue. - Resolução:
- Certifique-se de que ambos os lados da comparação usem o mesmo tipo de dados. Se a intenção é verificar se uma variável string contém o valor
"0", compare com o literal string"0"em vez do inteiro0:
- Certifique-se de que ambos os lados da comparação usem o mesmo tipo de dados. Se a intenção é verificar se uma variável string contém o valor
// Compares string to integer: non-numeric strings coerce to 0 and match unexpectedly
        If($myVar == 0, ...)

        // Compares string to string: behaves as expected
        If($myVar == "0", ...)
- Se a variável deve conter um valor numérico, atribua-a como um número em vez de uma string antes da comparação.
Aritmética decimal produz resultados inesperados de ponto flutuante
- Sintoma: Uma expressão aritmética envolvendo literais decimais produz um resultado ligeiramente diferente do valor esperado. Por exemplo,
Double(12.01) - Double(12.00)retorna0.00999999999999979em vez de0.01, e(4.9 * 100) - 490avalia para5.6843418860808e-14em vez de0. - Possível causa: O Jitterbit Script armazena números como valores de ponto flutuante. A maioria das frações decimais não pode ser representada exatamente em ponto flutuante binário, portanto a aritmética nelas pode acumular pequenos erros de arredondamento. A subtração que cancela a maior parte de um valor expõe esse resíduo. Converter explicitamente valores como
Doublenão impede isso: especifica o tipo de dados, mas não altera como o valor é armazenado ou calculado. -
Resolução:
-
Aplique
Roundao resultado: UseRoundcom o número de casas decimais necessárias para o cálculo:$a = Round(Double(12.01) - Double(12.00), 2); // returns 0.01 -
Converta literais decimais usando
Float: Envolva o literal decimal emFloatantes do cálculo:$a = (Float(4.9) * 100) - 490; WriteToOperationLog($a);
-
Funções de data retornam meia-noite em vez de um valor somente de data
- Sintoma: Após atualizar para a versão do agente 12.8 ou posterior,
ConvertTimeZone,DateouGeneralDateretorna uma string de data e hora completa (por exemplo,2026-01-01 00:00:00) para uma entrada de exatamente meia-noite, em vez de uma string somente de data (2026-01-01), o que pode quebrar a lógica downstream que espera o formato mais curto.CVTDatenão é afetado. - Possível causa: Com agentes versão 12.8 e posterior, essas funções tratam meia-noite (
00:00:00) como um valor de hora válido e o preservam no valor retornado, da mesma forma que qualquer outra hora. Anteriormente, um valor de exatamente meia-noite era truncado para uma string somente de data, enquanto qualquer outra hora era preservada corretamente. - Resolução: Se a lógica downstream exigir um valor somente de data, use
FormatDatepara formatar explicitamente o resultado em vez de depender do formato de saída padrão da função.
Valor em cache expira mais cedo do que o esperado
- Sintoma: Um valor escrito no cache com uma expiração longa (por exemplo, 24 horas) desaparece bem antes desse tempo decorrer, ou expira após 30 minutos independentemente do que foi definido em
WriteCache. - Possível causa: Cada chamada para
ReadCacheredefine a expiração do item em cache para 30 minutos (1800 segundos), a menos que o parâmetroexpirationSecondsseja explicitamente fornecido. A expiração deWriteCachese aplica apenas no momento da escrita; leituras subsequentes sem uma expiração explícita encurtam silenciosamente o tempo de vida restante. - Resolução:
- Especifique a expiração em
ReadCache: Passe o número desejado de segundos como o parâmetroexpirationSecondspara preservar ou estender o tempo de vida do valor em cache em cada leitura:
- Especifique a expiração em
        // Redefine a expiração para 24 horas a cada leitura
        testVal = ReadCache("CacheTest", 86400, "env");
        ```

    -   **Passe `-1` para preservar a expiração da escrita:** Passar um valor não positivo faz com que `ReadCache` retenha a expiração definida pela chamada `WriteCache` mais recente em vez de aplicar uma nova:

        ```
        testVal = ReadCache("CacheTest", -1, "env");
        ```
<!-- --8<-- [end:readcache-expiration-reset] -->

<!-- Source: JIT-93920 -->

### `RunXSLT` falha com "XML version must be 1.0 or 1.1" {: #runxslt-html-output}

<!-- --8<-- [start:runxslt-html-output] -->
-   **Sintoma:** [`RunXSLT`](/pt/integration-studio/design/functions/xml-functions/#xmlfunctions-runxslt) falha com o erro:

    ```
    Failed to execute xslt. XML version must be 1.0 or 1.1
    ```

    mesmo que o arquivo XML de entrada contenha uma declaração `<?xml version="1.0"?>` válida.

-   **Possível causa:** A folha de estilos XSLT está configurada para produzir saída HTML (por exemplo, `<xsl:output method="html"/>`). `RunXSLT` suporta apenas XML como saída. Quando a folha de estilos produz HTML, a função gera um resultado vazio, o que dispara este erro. A mensagem de erro refere-se à declaração XML ausente na saída (vazia), não no XML de entrada.

-   **Resolução:**

    -   **Atualize o XSLT para produzir saída XML:** Altere a declaração de saída da folha de estilos para `<xsl:output method="xml"/>` ou remova a declaração `xsl:output` completamente (XML é o padrão). Esta é a abordagem recomendada e funciona em agentes na nuvem e privados.

    -   **Use o plugin XSL Transform (apenas agentes privados):** Para grupos de agentes privados, o [plugin XSL Transform](/pt/agent/plugins/xsl-transform/) descontinuado usa o processador XSLT Saxon e suporta formatos de saída não XML, incluindo HTML. Consulte [Plugins disponíveis](/pt/agent/plugins/plugins-available/) para detalhes de instalação.
<!-- --8<-- [end:runxslt-html-output] -->

<!-- Source: JIT-52508 -->

### `SelectSingleNode` retorna o nó errado quando usado com um elemento de array `SelectNodes` {: #selectsinglenode-wrong-node}

<!-- --8<-- [start:selectsinglenode-wrong-node] -->
-   **Sintoma:** [`SelectSingleNode`](/pt/integration-studio/design/functions/xml-functions/#xmlfunctions-selectsinglenode) retorna dados do elemento errado (por exemplo, sempre a primeira correspondência no documento) quando chamado em um elemento recuperado de um array [`SelectNodes`](/pt/integration-studio/design/functions/xml-functions/#xmlfunctions-selectnodes).
-   **Possível causa:** Usar uma expressão XPath absoluta (uma que começa com `//`) como argumento de caminho faz com que `SelectSingleNode` pesquise a partir da raiz do documento XML original em vez de relativo ao nó atual. Uma expressão como `"//Item/ItemName"` corresponde ao primeiro `ItemName` em qualquer lugar do documento, independentemente de qual elemento `Item` foi recuperado do array.
-   **Resolução:**
    -   **Use um caminho relativo:** Omita o `//` inicial e especifique apenas o nome do elemento ou um caminho relativo ao nó atual. Isso limita a pesquisa ao nó passado como primeiro argumento:

        ```
        $itemName = SelectSingleNode($item, "ItemName");
        ```

    -   **Alternativa: envolva o nó em `String`:** Converter o elemento do array em uma string antes de passá-lo para `SelectSingleNode` também produz o resultado correto, embora usar um caminho relativo seja a abordagem preferida:

        ```
        $item = String($items[2]);
        $itemName = SelectSingleNode($item, "//Item/ItemName");
        ```
<!-- --8<-- [end:selectsinglenode-wrong-node] -->

<!-- Source: JIT-100107, SUPPORT-5286 -->

### A saída de `HexToBinary` parece inalterada quando registrada {: #hextobinary-log-display}

<!-- --8<-- [start:hextobinary-log-display] -->
-   **Sintoma:** [`HexToBinary`](/pt/integration-studio/design/functions/conversion-functions/#conversionfunctions-hextobinary) parece não ter efeito: o valor escrito no log de operação parece idêntico à entrada hexadecimal, sugerindo que a conversão não ocorreu.
-   **Possível causa:** [`WriteToOperationLog`](/pt/integration-studio/design/functions/logging-and-error-functions/#logginganderrorfunctions-writetooperationlog) não consegue gerar dados binários brutos. Quando recebe um valor binário, converte-o de volta para hexadecimal para exibição. O mesmo comportamento se aplica na janela de teste de script. A conversão está funcionando corretamente; apenas a exibição é afetada.
-   **Resolução:** Para trabalhar com ou verificar a saída binária, escreva-a em um arquivo usando [`WriteFile`](/pt/integration-studio/design/functions/file-functions/#filefunctions-writefile). Por exemplo:
SortArray ordena nomes de arquivo lexicograficamente, não cronologicamente
- Sintoma:
SortArrayretorna nomes de arquivo em ordem alfabética em vez da ordem cronológica esperada quando os nomes de arquivo contêm strings de data ou hora incorporadas. - Possível causa:
SortArrayrealiza uma ordenação de string (lexicográfica). Para um nome de arquivo comoordall_DDMMYYHHMMSS.txt, a parte do dia precede a parte do ano na string, portanto uma ordenação alfabética não corresponde a uma ordenação baseada em data. - Resolução:
- Se você controlar a convenção de nomenclatura de arquivo, mude para um formato que seja ordenado corretamente quando classificado alfabeticamente, como
YYYY-MM-DD_HHMMSS_filename.txt. Esta é a solução mais simples e confiável. - Se o formato do nome de arquivo não puder mudar, analise a porção de data de cada nome de arquivo em uma chave ordenável (por exemplo,
YYYYMMDDHHMMSS) e ordene pela chave analisada em vez do nome de arquivo bruto.
- Se você controlar a convenção de nomenclatura de arquivo, mude para um formato que seja ordenado corretamente quando classificado alfabeticamente, como
URLEncode não codifica certos caracteres "seguros" ou multibyte
- Sintoma: Um valor passado por
URLEncodeé enviado para o destino com alguns caracteres deixados sem codificação, fazendo com que o sistema receptor rejeite a solicitação ou interprete mal o valor. Isso afeta comumente credenciais ou valores de consulta que contêm caracteres como$,+ou!. - Possíveis causas:
URLEncodesegue RFC 1738 e trata esses caracteres como "seguros", portanto nunca os codifica:$ - _ . + ! * ' ( ) ,. Um destino que espera que esses caracteres sejam codificados em percentual recebe o caractere bruto em vez disso.- O suporte a caracteres multibyte em
URLEncoderequer versão do agente 12.4 ou posterior. Em agentes anteriores, caracteres multibyte podem não ser codificados conforme esperado.
-
Resolução:
-
Quando caracteres "seguros" devem ser codificados (por exemplo, em uma senha OAuth ou um valor que contém
+), use a função JavaScriptencodeURIComponentem uma etapa de script JavaScript em vez deURLEncode:javascript <javascript> $my_username = "$Example+User"; $loginValue = encodeURIComponent($my_username); </javascript>Isso retorna
%24Example%2BUser. -
Para codificar caracteres multibyte com
URLEncode, confirme se o agente está na versão 12.4 ou posterior.
-
JavaScript: erro "Call to Jitterbit Tomcat failed"
-
Sintoma: Uma etapa JavaScript complexa ou de longa duração falha com um erro genérico referenciando Tomcat, mesmo que os serviços Jitterbit Apache e Jitterbit Tomcat no agente estejam em execução. O script pode ter sucesso quando sua complexidade é reduzida (por exemplo, reduzindo contagens de iteração ou profundidade de recursão).
Call to Jitterbit Tomcat failed (null response). Make sure the Jitterbit Apache and Jitterbit Tomcat services are both running. Failed to execute script -
Possível causa: JavaScript profundamente recursivo pode exceder o limite de profundidade de recursão do mecanismo JavaScript do agente, produzindo um estouro de pilha que aparece como esse erro genérico de Tomcat. Esse limite de recursão é intencional. O script normalmente é concluído uma vez que a profundidade de recursão é reduzida.
- Resolução:
- Reduza a profundidade de recursão ou reescreva a lógica recursiva como um loop iterativo.
- Se o algoritmo não puder evitar recursão profunda, use uma abordagem que não dependa dela.
- Observe que o limite de iteração de loop separado por script (
JavaScriptMaxIterations, consulte Limite de iteração de loop de script excedido) não aumenta o teto de recursão, que não é exposto como uma configuração configurável.
JavaScript: Alterações de variáveis globais perdidas em caso de falha de script
- Sintoma: Um script JavaScript que modifica variáveis globais é executado sem erro aparente em alguns casos, mas as alterações nessas variáveis globais estão ausentes em scripts ou operações subsequentes.
- Possíveis causas:
- Em JavaScript, as alterações em variáveis globais são confirmadas apenas quando o script é concluído com sucesso. Se o script falhar em qualquer ponto, todas as alterações de variáveis globais feitas durante essa execução serão descartadas.
- Misturar a sintaxe
$variablecomJitterbit.SetVar/Jitterbit.GetVarpara a mesma variável dentro de um script JavaScript pode causar comportamento de tempo de execução imprevisível.
- Resolução:
- Estruture scripts JavaScript para que todas as atribuições de variáveis globais ocorram após a lógica que pode falhar, ou use tratamento de erros para evitar falhas no meio do script.
- Para qualquer variável em um script JavaScript, use a sintaxe
$variableouJitterbit.SetVar/Jitterbit.GetVar, nunca ambas. Escolha uma e use-a consistentemente em todo o script. - Para confirmar quais variáveis estão sendo definidas, adicione chamadas
WriteToOperationLogpara registrar valores de variáveis em pontos-chave durante a execução.
JavaScript: GetVar retorna null para variáveis de projeto definidas pelo usuário
- Sintoma: Chamar
Jitterbit.GetVarem uma variável de projeto definida pelo usuário em uma etapa de script JavaScript retornanullem vez do valor da variável, sem mensagem de erro. - Possível causa:
Jitterbit.GetVareJitterbit.SetVarsão destinados a variáveis do sistema Jitterbit (por exemplo,jitterbit.operation.name) e a nomes de variáveis que contêm um ponto, que a notação de ponto do JavaScript não consegue referenciar diretamente. Elas não leem variáveis de projeto ordinárias definidas pelo usuário cujos nomes não contêm um ponto; passar tal nome paraGetVarretornanull. Referencie essas variáveis diretamente com$name. Essas funções também convertem todos os valores em strings, portanto não são adequadas para arrays ou objetos, e um valor definido comSetVarpode ser lido novamente comGetVardentro do mesmo script, mas não persiste em scripts posteriores. -
Resolução: Use a sintaxe
$variableNamediretamente em JavaScript para acessar variáveis de projeto e globais definidas pelo usuário cujos nomes não contêm um ponto. ReserveGetVareSetVarpara variáveis do sistema Jitterbit e para variáveis cujos nomes contêm um ponto (por exemplo,$hello.world), que a notação de ponto do JavaScript não consegue acessar diretamente. Para uma determinada variável, use prefixação com$ouGetVar/SetVar, não ambas. Consulte também JavaScript: Alterações de variáveis globais perdidas em caso de falha de script.```javascript // Correct: access a user-defined project variable directly var value = $myProjectVar;
// Incorrect for user-defined variables without periods: var value = Jitterbit.GetVar("$myProjectVar"); // returns null ```
Erros HTTP e API
504 Gateway Timeout
- Sintoma: Chamadas de API através do gateway de API na nuvem ou privado retornam
504 Gateway Timeout, normalmente após a janela de tempo limite do gateway (30 a 180 segundos). - Causa e resolução: A operação de suporte está excedendo o tempo limite do gateway de API, ou a solicitação não pode ser atribuída a um agente disponível. Consulte HTTP 504 Gateway Timeout no guia de solução de problemas do API Manager para obter as causas completas e a resolução.
507 Insufficient Storage
-
Sintoma: Uma chamada de API retorna:
507 Insufficient Storage -
Possíveis causas:
- O agente ou host do gateway está sem espaço em disco.
- Em um gateway de API privada, o gateway não consegue abrir seu arquivo de payload ou resposta hospedado e retorna um 507 mesmo quando há espaço em disco disponível. Isso geralmente indica um problema de registro de domínio privado ou configuração do gateway.
-
Resolução:
- Confirme que o agente ou host do gateway tem espaço em disco livre suficiente.
- Se o espaço em disco é suficiente e a API é servida através de um gateway de API privada, consulte Gateway privado retorna HTTP 507 ou "No such file or directory" para a causa e resolução.
502 Bad Gateway
-
Sintoma: Uma operação que usa Jitterbit Message Queue (JBMQ) falha com:
502 Bad GatewayO servidor retornou uma resposta inválida ou incompleta.
-
Possível causa: O serviço JBMQ não retornou uma resposta completa à solicitação, produzindo um 502. Esse erro é geralmente transitório e pode não ser reproduzível.
- Resolução:
- Tente novamente a operação.
- Se o erro persistir, entre em contato com o suporte Jitterbit.
Erros em tempo de design
Esses problemas aparecem ao construir, validar ou implantar um projeto no Studio, em vez de quando uma operação é executada.
Erros comuns de validação de operação
Operações com erros de validação exibem um ícone inválido na tela de design e no painel de projeto. Clique no ícone para visualizar a mensagem de erro específica.
A tabela a seguir lista erros de validação comuns e suas resoluções:
| Erro | Resolução |
|---|---|
| Operation is empty. | A operação deve ter pelo menos uma etapa de operação. |
| Operation does not conform to any valid pattern. Operation rules and patterns can be found here. |
A operação deve atender aos padrões de operação estabelecidos que o agente suporta e espera. Esses padrões são cobertos em Padrões de validação. |
| The transformation [source / target] schema does not match the schema structure provided by ["Activity Name"] activity. Open transformation ["Transformation Name"] in ["Operation Name"] operation and refresh the target schema. | Em uma operação que contém uma transformação com um esquema fornecido por atividade, o esquema fornecido pela atividade deve corresponder à estrutura de esquema fornecida por uma atividade adjacente. |
| Transformation ["Transformation Name"] has a source schema but no source activity. Remove the source schema from the transformation or add a source activity before the transformation. | Se a operação contiver uma transformação com um esquema de origem fornecido por atividade ou fornecido por transformação, deve haver uma atividade de origem precedendo a transformação. |
| HTTP target activities that send their response to a second target activity can only send responses to one target activity throughout the project. The HTTP activity ["Target 1 Activity Name"] in this operation is sending its response to multiple target activities throughout the project. In this operation its target is ["Target 2A Activity Name"]. In operation ["Operation 2"] its target is ["Target 2B Activity Name"]. Replace the ["Target 1 Activity Name"] activity with a duplicate activity in one of the operations. You can do this by finding the ["Target 1 Activity Name"] activity in the Components Tab, open the menu, and duplicate. Drag the duplicated activity to the operation. |
Em uma operação que usa o padrão de arquivo de dois destinos e contém uma atividade de destino HTTP que escreve uma resposta em uma segunda atividade de destino, a atividade de destino HTTP também sendo usada em outra operação padrão de arquivo de dois destinos deve escrever para a mesma atividade de destino. Nota: Essa regra de validação pode ser desabilitada, embora não seja recomendado. Para mais informações, consulte Erros de regra de validação HTTP abaixo. |
| "Operation ["Operation Name"] cannot have more than one listener or event-based activity: ["Activity Names"]." | Uma operação pode conter apenas uma atividade de escuta por operação. |
| "Operation ["Operation Name"] has ["Activity Name"] as a listener or event-based activity -- such activities needs to be the first in the operation. | A operação deve atender aos padrões de operação estabelecidos para a atividade de escuta. Os padrões de operação que cada atividade de escuta pode ser usada estão listados na documentação de cada atividade. |
| "Operation ["Operation Name"] cannot have ["On Success" / "On Fail" / "On SOAP Fault"] outcome to ["Operation Name 2"] target operation which is has a listener or event-based as first activity." | Uma operação não pode usar ações de operação para invocar outra operação que contém uma atividade de escuta. |
| "Operation ["Operation Name"] starts with a listener or event-based activity ["Activity Name"] and cannot have schedule attached to." | Uma operação que contém uma atividade de escuta não pode ser executada em um cronograma. |
| "["Script Name"] script in ["Operation Name"] operation cannot use RunOperation() to invoke ["Operation Name 2"] operation that has a listener or event-based activity. | Uma operação não pode usar a função RunOperation para invocar outra operação que contém uma atividade de escuta. |
Erros de regra de validação HTTP
Uma das regras de validação HTTP se aplica a operações que usam o padrão de arquivo com dois destinos onde uma atividade HTTP na posição Destino 1 escreve uma resposta para uma segunda atividade de destino (Destino 2). Nesse cenário, a regra de validação exige que uma atividade HTTP Destino 1 não seja usada em nenhuma outra operação do padrão de arquivo com dois destinos onde a atividade HTTP Destino 1 escreve para uma segunda atividade de destino diferente.
Operações que violam essa regra de validação aparecem como inválidas com uma mensagem de erro semelhante ao seguinte exemplo:
Texto da caixa de diálogo
Erros de Validação
operationName
Atividades de destino HTTP que enviam sua resposta para uma segunda atividade de destino só podem enviar respostas para uma atividade de destino em todo o projeto. A atividade HTTP activityName nesta operação está enviando sua resposta para múltiplas atividades de destino em todo o projeto.
Nesta operação seu destino é targetName. Na operação otherOperation seu destino é otherTarget.
Substitua a atividade activityName por uma atividade duplicada em uma das operações. Você pode fazer isso encontrando a atividade activityName na Aba de Componentes, abrindo o menu e duplicando. Arraste a atividade duplicada para a operação.
Resolver erros de validação HTTP
Siga as instruções na mensagem de erro para corrigir as operações e torná-las válidas. Para resolver esses erros, complete as seguintes etapas:
-
Duplique a atividade de destino HTTP na posição Destino 1 de uma das operações que usa o padrão de arquivo HTTP com dois destinos.
-
Substitua a atividade de destino HTTP na posição Destino 1 das operações identificadas pela cópia duplicada.
-
Repita para qualquer operação inválida adicional. Depois de resolver os erros de validação, reimplante as operações.
Desabilitar a regra de validação HTTP
Em certas situações, você pode querer desabilitar essa regra de validação HTTP. Para desabilitar a regra, complete as seguintes etapas:
-
Abra as configurações do projeto:
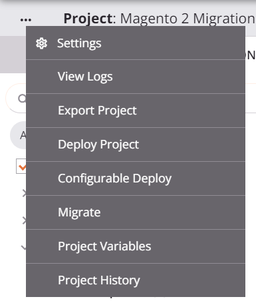
-
Na aba Deploy, desabilite HTTP Validation Rule:
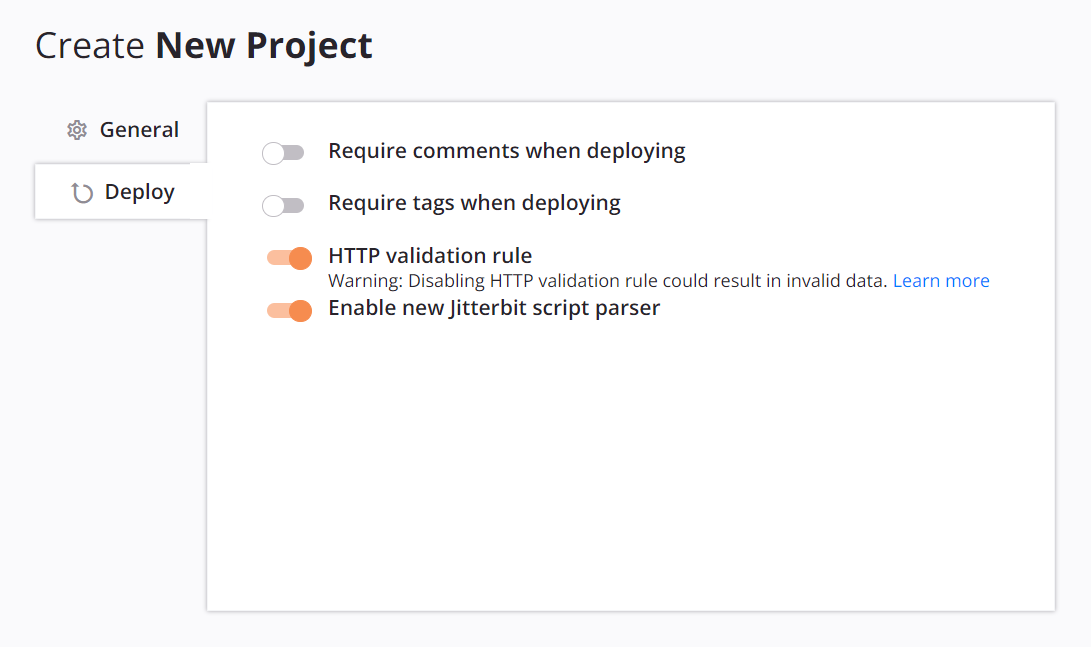
-
Clique em Save.
Depois de desabilitar e salvar a configuração, os erros de validação de operação dessa regra devem ser resolvidos. No entanto, qualquer atividade HTTP Destino 1 usada em uma operação do padrão de arquivo com dois destinos escreve para a atividade Destino 2 da última operação implantada. Esse comportamento pode causar a escrita de dados inválidos.
Cuidado
Desabilitar a regra de validação HTTP não é recomendado e pode resultar na escrita não intencional de dados inválidos para atividades de destino em operações que usam o padrão de arquivo com dois destinos.
Reabilitar a regra de validação HTTP
Se você desabilitou anteriormente a regra de validação HTTP e deseja reabilitá-la, complete as seguintes etapas:
-
Abra as configurações do projeto.
-
Na aba Deploy, habilite HTTP Validation Rule.
-
Clique em Save. Essa alteração é uma alteração em tempo de design e não implanta nenhuma alteração na nuvem Harmony.
-
Resolva quaisquer erros de validação HTTP (consulte Resolver erros de validação HTTP).
-
Reimplante o projeto (consulte Implantação de projeto).
Nota
Antes da reimplantação, o Harmony permite a execução de qualquer operação agora inválida porque o Harmony executa as operações atualmente implantadas. A reimplantação das operações afetadas é necessária para que as alterações se propaguem para o Harmony.
Os nomes dos componentes devem ser exclusivos após a importação do projeto
-
Sintoma: Após importar um projeto de um arquivo de exportação JSON, um ou mais componentes aparecem como inválidos e a implantação falha com uma mensagem semelhante a:
[Operation / Connection / Activity / Transformation / Script / Tool / Email / Variable] names must be unique. -
Possível causa: O projeto importado contém vários componentes do mesmo tipo com nomes idênticos. O Studio impede a criação de nomes duplicados ao configurar componentes diretamente na interface, mas uma importação completa do projeto não aplica essa verificação.
- Resolução:
- No painel do projeto, identifique os componentes inválidos, mostrados em itálico vermelho com um ícone de erro .
- Clique no ícone de erro para visualizar o nome duplicado específico que causa o conflito.
- Renomeie um dos componentes duplicados para que cada nome seja exclusivo dentro de seu tipo.
- Reimplante o projeto após resolver todos os erros de nome duplicado.
- Para trazer apenas componentes selecionados para um projeto existente, use importação seletiva, que sinaliza conflitos com componentes de mesmo nome já no projeto de destino e permite substituí-los ou manter ambos.
O conector exclusivo de agente privado bloqueia a importação para um ambiente de agente na nuvem
-
Sintoma: A importação ou migração de um projeto para um ambiente associado a um grupo de agentes na nuvem é bloqueada porque o projeto usa um conector exclusivo de agente privado. A mensagem lista os conectores exclusivos de agente privado responsáveis. Uma importação completa do projeto exibe:
The project you are importing uses private agent only connectors and cannot be imported into a cloud environment.Uma importação seletiva exibe um diálogo Component import not allowed:
The components you are importing uses private agent only connectors and cannot be imported into a cloud environment. -
Possível causa: O projeto usa um ou mais conectores disponíveis apenas em agentes privados. A coluna Agent availability na lista de Conectores mostra quais conectores são exclusivos de agente privado. Os agentes na nuvem não suportam esses conectores, portanto o Studio impede que o projeto seja importado ou migrado para um ambiente de agente na nuvem.
- Resolução:
- Importe ou migre o projeto para um ambiente associado a um grupo de agentes privados que tenha o conector necessário instalado.
- Se o projeto deve ser executado em agentes na nuvem, substitua as atividades do conector exclusivo de agente privado por conectores compatíveis com a nuvem (como HTTP v2 para APIs REST ou o conector de Banco de Dados com um endpoint acessível na nuvem) antes de importar.
Fazer upload de um arquivo de schema o substitui em todo o projeto
- Sintoma: Após fazer upload de um novo arquivo de schema durante a configuração de transformação, outras transformações no projeto que usavam o mesmo schema agora se comportam de forma inesperada ou produzem erros.
- Possível causa: Ao fazer upload de um arquivo com o mesmo nome de um arquivo de schema existente já definido no projeto, o Studio exibe um diálogo Sobrescrever arquivo?. Se você clicar em Continuar, o arquivo existente é substituído em todos os locais onde é usado. Essa substituição é em todo o projeto, não limitada à transformação atual.
- Resolução:
- Antes de fazer upload de um arquivo de schema de substituição, confirme se o schema existente é compartilhado: abra o schema para edição e, se ele for referenciado por mais de um componente, o Studio exibe um diálogo Schema usado por múltiplos componentes listando-os (consulte Atualizar schemas definidos por transformação). Avalie o impacto em todos os componentes listados antes de prosseguir.
- Se apenas uma transformação deve usar o schema atualizado, clique em Cancelar no diálogo Sobrescrever arquivo? (ou renomeie o novo arquivo antes de fazer upload) para que não sobrescreva o arquivo compartilhado.
A implantação do template de processo do Marketplace falha devido a incompatibilidade de schema
- Sintoma: Um projeto importado de um template de processo do Marketplace falha ao ser implantado ou produz erros em tempo de execução porque campos estão faltando em uma transformação ou a validação da atividade de origem e destino falha.
- Possível causa: Os templates de processo são desenvolvidos para uma instância de endpoint específica. Se sua instância for diferente (por exemplo, se sua organização Salesforce ou NetSuite tiver campos personalizados ou padrão diferentes), os schemas incorporados nas transformações do template podem não corresponder ao seu endpoint.
- Resolução:
- Na transformação afetada, abra as configurações de schema e clique no ícone de atualização (ou na palavra Atualizar) para regenerar o schema do seu endpoint conectado.
- Se o schema ainda não corresponder após a atualização, limpe o schema existente e espelhe-o novamente a partir de um arquivo de amostra atual ou diretamente do endpoint.
- Remapeie todos os campos que foram adicionados ou removidos durante a regeneração do schema.
- Reimplante o projeto e execute novamente a operação para confirmar que o problema foi resolvido.
O Studio fica lento ou não responde com projetos muito grandes
- Sintoma: O Studio responde lentamente quando um único workflow contém um número muito grande de operações ou ao salvar um script muito grande.
- Possível causa: A tela de design renderiza todas as operações no workflow ativo de uma vez, portanto um workflow com um número muito grande de operações coloca altas demandas de memória no navegador.
- Resolução:
- Divida workflows grandes em sub-workflows menores e vinculados. O Studio renderiza apenas a tela do workflow ativo, portanto menos operações por workflow melhora a responsividade. Use ações de operação para encadear sub-workflows.
- Se a lentidão ocorrer especificamente ao salvar um script grande, divida o script em scripts menores e chame-os usando
RunScript.
Erros de sistema e recursos
Divisão em lotes não respeitada quando a origem é um conector baseado em SDK
- Sintoma: Uma operação com divisão em lotes ativada envia todos os registros para o destino em um único lote em vez de respeitar o tamanho de lote configurado. Erros do destino indicam que o limite de lote foi excedido (por exemplo, o Salesforce retorna
EXCEEDED_ID_LIMIT: record limit reached. cannot submit more than 200 records into this call). - Possível causa: A divisão em lotes não é suportada quando a origem é um conector baseado em Connector SDK (conforme listado na coluna Connector type da lista de conectores). Operações que usam origens não-SDK, como HTTP, Database, Variable e Local Storage, respeitam a divisão em lotes normalmente.
- Resolução:
- Se a divisão em lotes não for necessária, desative-a nas opções de operação.
- Se a divisão em lotes for necessária, divida a operação em duas:
- Na primeira operação, leia da origem baseada em SDK e escreva em uma atividade Variable Write.
- Na segunda operação, leia de uma atividade Variable Read e escreva no destino original com a divisão em lotes ativada. Como o conector Variable não é baseado em SDK, a divisão em lotes funciona corretamente nesta operação. Para as etapas de configuração de divisão em lotes, consulte Configurar divisão em lotes de operação.
Atualizações de variáveis perdidas em operações multi-thread com divisão em lotes
- Sintoma: Quando uma operação é executada com divisão em lotes ativada e Max Number of Threads definido como mais de 1, as atualizações de variáveis globais ou de projeto feitas durante a operação não são totalmente preservadas após sua conclusão. Um caso possível é preencher uma variável de dicionário ou array a partir de cada registro de origem e descobrir que ela contém apenas parte dos dados depois (por exemplo, aproximadamente metade dos registros quando dois threads são executados). Isso pode ocorrer com conectores cuja configuração padrão usa mais de um thread, como atividades do Salesforce, que usam 2 threads por padrão.
- Possível causa: Cada thread recebe sua própria cópia das variáveis globais e de projeto no início do processamento. As alterações locais do thread não são mescladas novamente no estado compartilhado. Apenas as alterações feitas pelo primeiro thread são preservadas quando a operação é concluída; as alterações de todos os outros threads são descartadas.
- Resolução:
- Se a correção for mais importante do que a taxa de transferência por operação, defina Max Number of Threads como
1. Cada lote é processado sequencialmente, portanto, as atualizações de variáveis não são divididas entre threads. - Se a taxa de transferência multi-thread for necessária, não acumule estado por registro em uma variável global ou de projeto. Em vez disso, coloque a saída de cada thread em um arquivo Temporary Storage exclusivo ou em uma tabela de banco de dados de preparo e consolide os resultados em uma operação subsequente com um único thread. Para um exemplo prático do padrão de preparo, consulte Escopo de variáveis com divisão em lotes.
- De forma mais geral, não confie em atualizações de variáveis globais ou de projeto de operações com divisão em lotes e multi-thread em scripts ou operações posteriores. Se o estado da variável deve ser preservado, defina essas variáveis em uma etapa de operação sem divisão em lotes que seja executada antes ou depois da transformação com divisão em lotes. Para detalhes sobre o comportamento de divisão em lotes com variáveis, consulte Usar variáveis com divisão em lotes.
- Se a correção for mais importante do que a taxa de transferência por operação, defina Max Number of Threads como
Falha ao criar diretório temporário
-
Sintoma: Uma operação falha ao criar um diretório temporário, com um erro como:
Failed to create the directory '/tmp/jitterbit/...'. Reason: boost::filesystem::create_directories: Permission deniedEm um grupo de agentes na nuvem, pode aparecer
No space left on device. -
Possíveis causas:
- Em um agente privado, a conta de serviço do Jitterbit Agent não possui permissões no nível do SO no caminho dos arquivos temporários, ou o disco está cheio.
- Em um grupo de agentes na nuvem, a causa está no lado do agente gerenciado pela Jitterbit, não no seu projeto ou configuração.
-
Resolução:
- Para agentes privados, confirme que a conta de serviço do agente possui permissões suficientes no caminho dos arquivos temporários (
/tmpouTemporaryFiles), e verifique se o host do agente possui espaço em disco livre adequado. - Para grupos de agentes na nuvem, isso indica um problema no lado do agente que a Jitterbit resolve. Entre em contato com o suporte Jitterbit e inclua a mensagem de erro e a hora em que as falhas ocorreram.
- Para agentes privados, confirme que a conta de serviço do agente possui permissões suficientes no caminho dos arquivos temporários (
Mensagens de log de operação truncadas em aproximadamente 100 KB
- Sintoma: Uma mensagem de log de operação aparece cortada, terminando com
message truncated. Isso pode aparecer nos logs de operação ou ao visualizar uma entrada de log de Operação na página API Logs do API Manager. - Possível causa: Mensagens de log de operação que excedem aproximadamente 100 KB (aproximadamente 99.000 caracteres) são truncadas. O ponto de truncamento é marcado com
message truncatedno final da mensagem. - Resolução: Se você precisar do conteúdo completo do log, reduza a verbosidade do log da operação ou divida a operação em unidades menores que produzam mensagens de log mais curtas.
O log de depuração de operação expõe PII e credenciais em texto simples
- Sintoma: Dados sensíveis, credenciais ou informações de identificação pessoal (PII) aparecem nos logs da nuvem Harmony.
- Possível causa: Quando o log de depuração de operação está ativado para uma operação, todos os dados de solicitação e resposta são armazenados na nuvem Harmony em texto simples por 30 dias.
- Resolução:
- Use o log de depuração de operação apenas em ambientes controlados, não produtivos, ou por um período de diagnóstico limitado.
- Para desativar a geração de dados de entrada e saída de componentes para um grupo de agentes privados, defina
verbose.logging.enable=falsena seção[VerboseLogging]do arquivo de configuração do agente.