Dividir um arquivo em registros individuais usando SCOPE_CHUNK no Jitterbit Studio
Introdução
Este padrão de design pode ser usado para dividir os dados em um arquivo com múltiplos registros em vários arquivos, cada um contendo um único registro, usando a sintaxe do prefixo SCOPE_CHUNK da função Set.
Dica
Este padrão é recomendado quando os dados de origem são simples (não hierárquicos) e a operação não contém uma transformação que usa lógica condicional. Para dados de origem complexos (hierárquicos), consulte Dividir um arquivo em registros individuais usando SourceInstanceCount.
Caso de uso
Neste cenário, os dados de origem contêm múltiplos registros, e o processo de negócio ou o endpoint de destino exigem que os registros sejam processados individualmente.
Padrão de design
Este padrão de design consiste em ler o arquivo usando uma operação em que a transformação utiliza o mesmo esquema de origem e destino. Este padrão tem estas características principais:
- No primeiro campo da transformação que processa os dados, a função
Seté usada para definir uma variável que começa comSCOPE_CHUNKseguida de texto adicional para construir o nome da variável. O primeiro argumento constrói o nome do arquivo de saída, normalmente usando um identificador de registro dos dados de origem. Os nomes de arquivo devem ser únicos para evitar serem sobrescritos, portanto um contador de registros ou um GUID pode ser usado como parte do nome do arquivo. - Um destino de armazenamento de arquivo, como Armazenamento Temporário ou Armazenamento Local, deve ser usado. (Usar uma Variável não é suportado.) Recomenda-se definir um caminho. O nome do arquivo deve ser configurado com o nome da variável global usado na função
Set. - As opções de operação devem ser configuradas com Ativar Chunking selecionado, com um Tamanho de Chunk de
1, Número de Registros por Arquivo de1e Número Máximo de Threads de1. - Durante a execução, cada registro será lido e atribuído a um nome de arquivo único, e escrito individualmente no destino.
Após usar este padrão, normalmente a próxima etapa é usar a função FileList para obter o array de nomes de arquivo no diretório (configure a atividade Leitura do diretório de arquivo com o curinga *), depois percorra o array e leia cada arquivo na origem para a próxima operação.
Exemplos
Exemplos usando o padrão de design descrito acima são fornecidos para dois tipos diferentes de dados de origem: um arquivo CSV simples e um arquivo JSON hierárquico.
CSV simples
Esta cadeia de operações de exemplo aplica o padrão de design descrito acima para dividir dados CSV simples em um arquivo para cada registro. Cada número corresponde a uma descrição da etapa de operação abaixo. Para mais detalhes, consulte as capturas de tela do exemplo JSON Hierárquico.
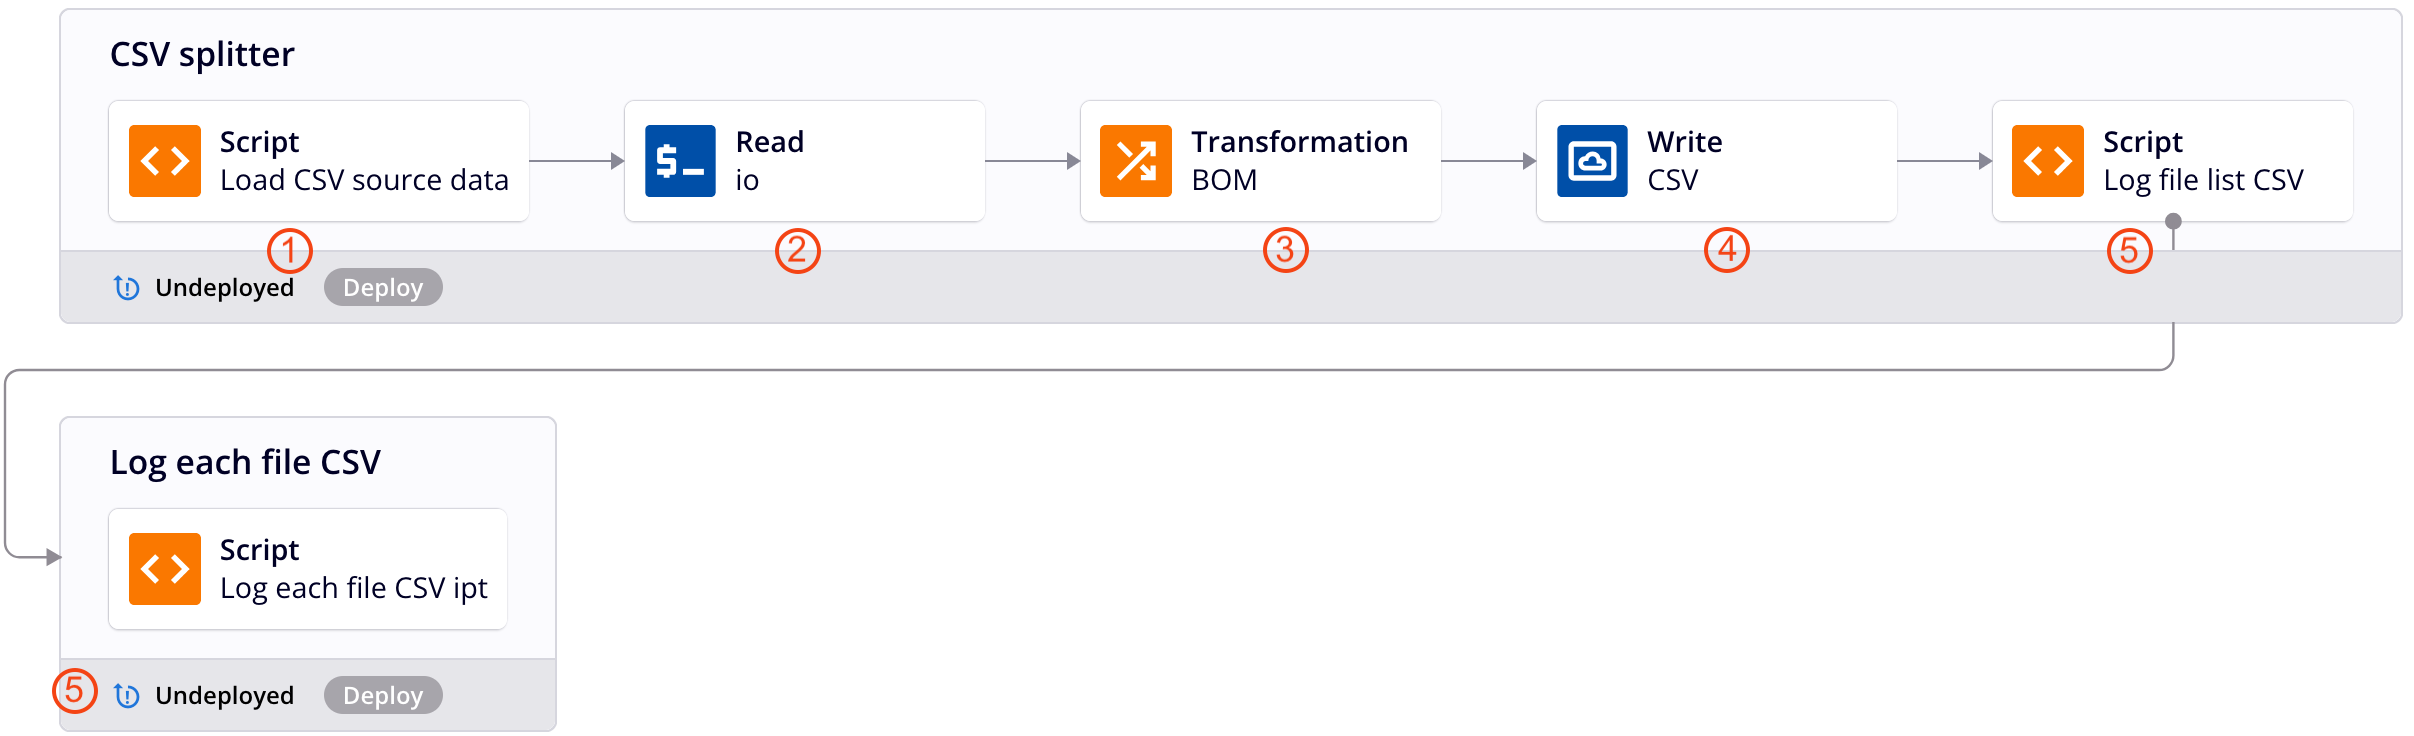
- O script atribui os dados de origem a uma variável global chamada
io(entrada/saída). (Um script é usado para fins de demonstração; os dados de origem também poderiam vir de um endpoint configurado.)
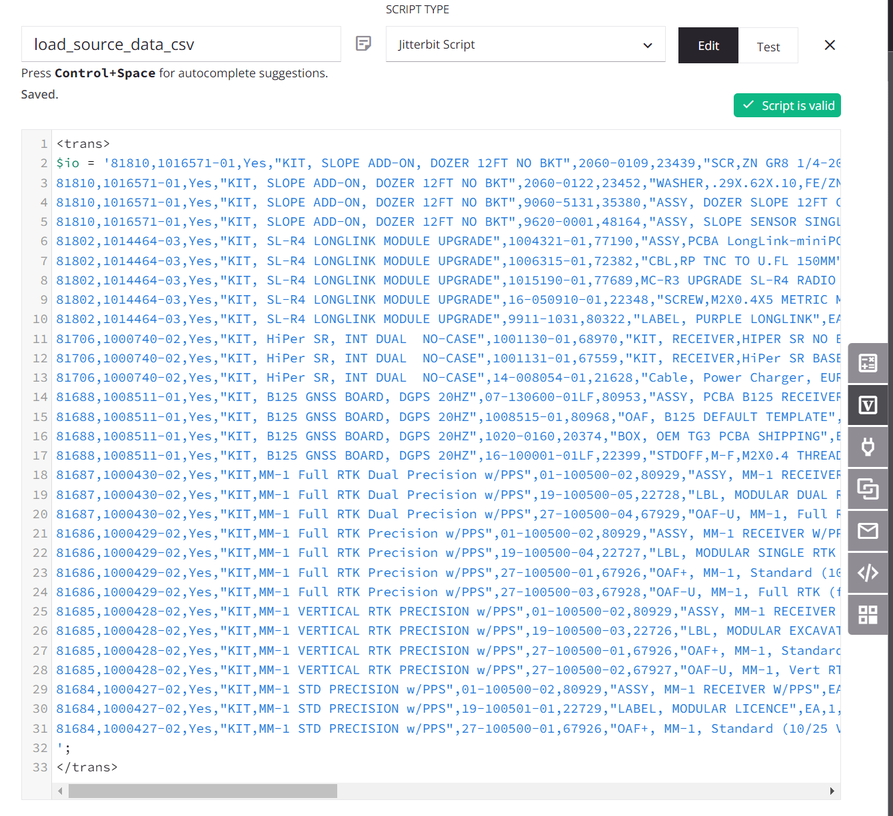
-
A variável global
ioé usada para configurar um endpoint de Variável, e uma atividade de Leitura de Variável associada é usada pela operação como fonte da transformação. -
Dentro da transformação, a origem e os destinos usam o mesmo esquema, e todos os campos são mapeados. O primeiro campo de dados no script de mapeamento da transformação é configurado para usar
SCOPE_CHUNK. A funçãoSeté usada para construir uma variável começando com a fraseSCOPE_CHUNKe é concatenada com o ID de registro único da origem, bem como um contador de registros e um sufixo.csv: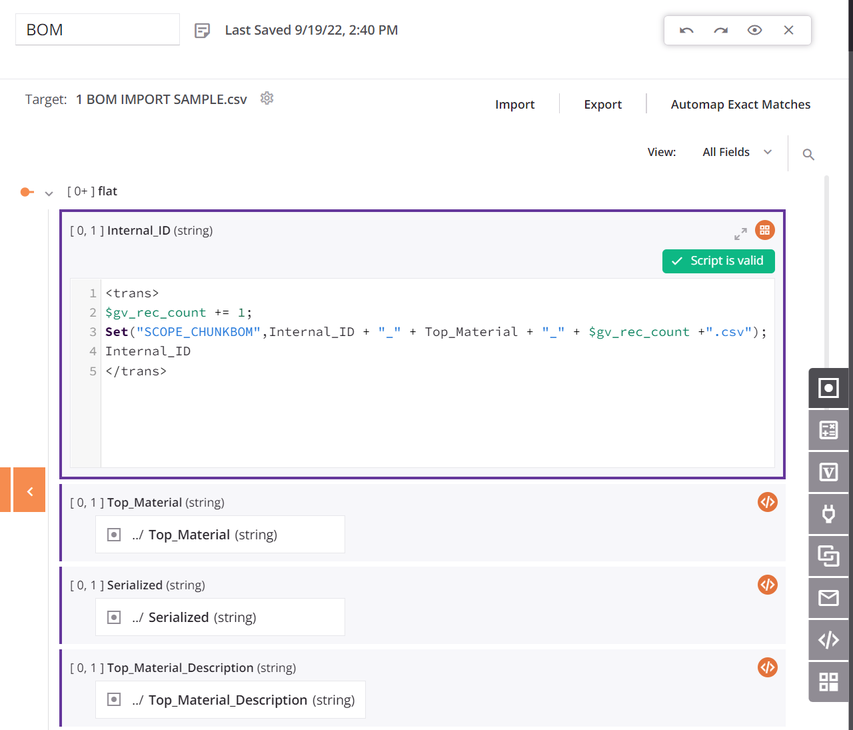
-
O destino é uma atividade de Escrita de Armazenamento Temporário configurada com um caminho padrão e a variável global de nome de arquivo definida anteriormente.
-
Os scripts são para registrar a saída e são opcionais. O primeiro script obtém uma lista dos arquivos do diretório e faz um loop sobre a lista, registrando o nome do arquivo e o tamanho, e então passa o nome do arquivo para uma operação com outro script que registra o conteúdo do arquivo. (Veja as capturas de tela do exemplo JSON Hierárquico acima.)
-
As opções de operação devem ser configuradas com Ativar Chunking selecionado, com um Tamanho do Chunk de
1, Número de Registros por Arquivo de1e Número Máximo de Threads de1.
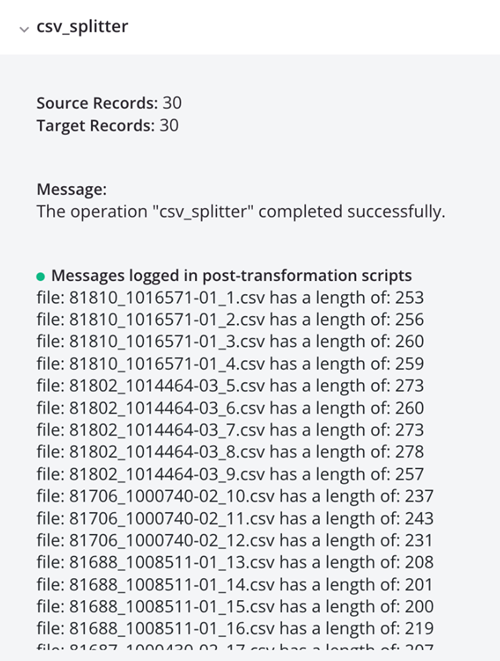
A execução da operação resulta em registros CSV individuais, mostrados na saída do log:
JSON Hierárquico
Esta cadeia de operações de exemplo aplica o padrão de design descrito acima para dividir dados JSON hierárquicos em um arquivo para cada registro. Cada número corresponde a uma descrição da etapa de operação abaixo.
Nota
Este padrão de design não é mais o método recomendado para dividir dados JSON hierárquicos. Para o método recomendado, consulte Dividir um arquivo em registros individuais usando SourceInstanceCount.
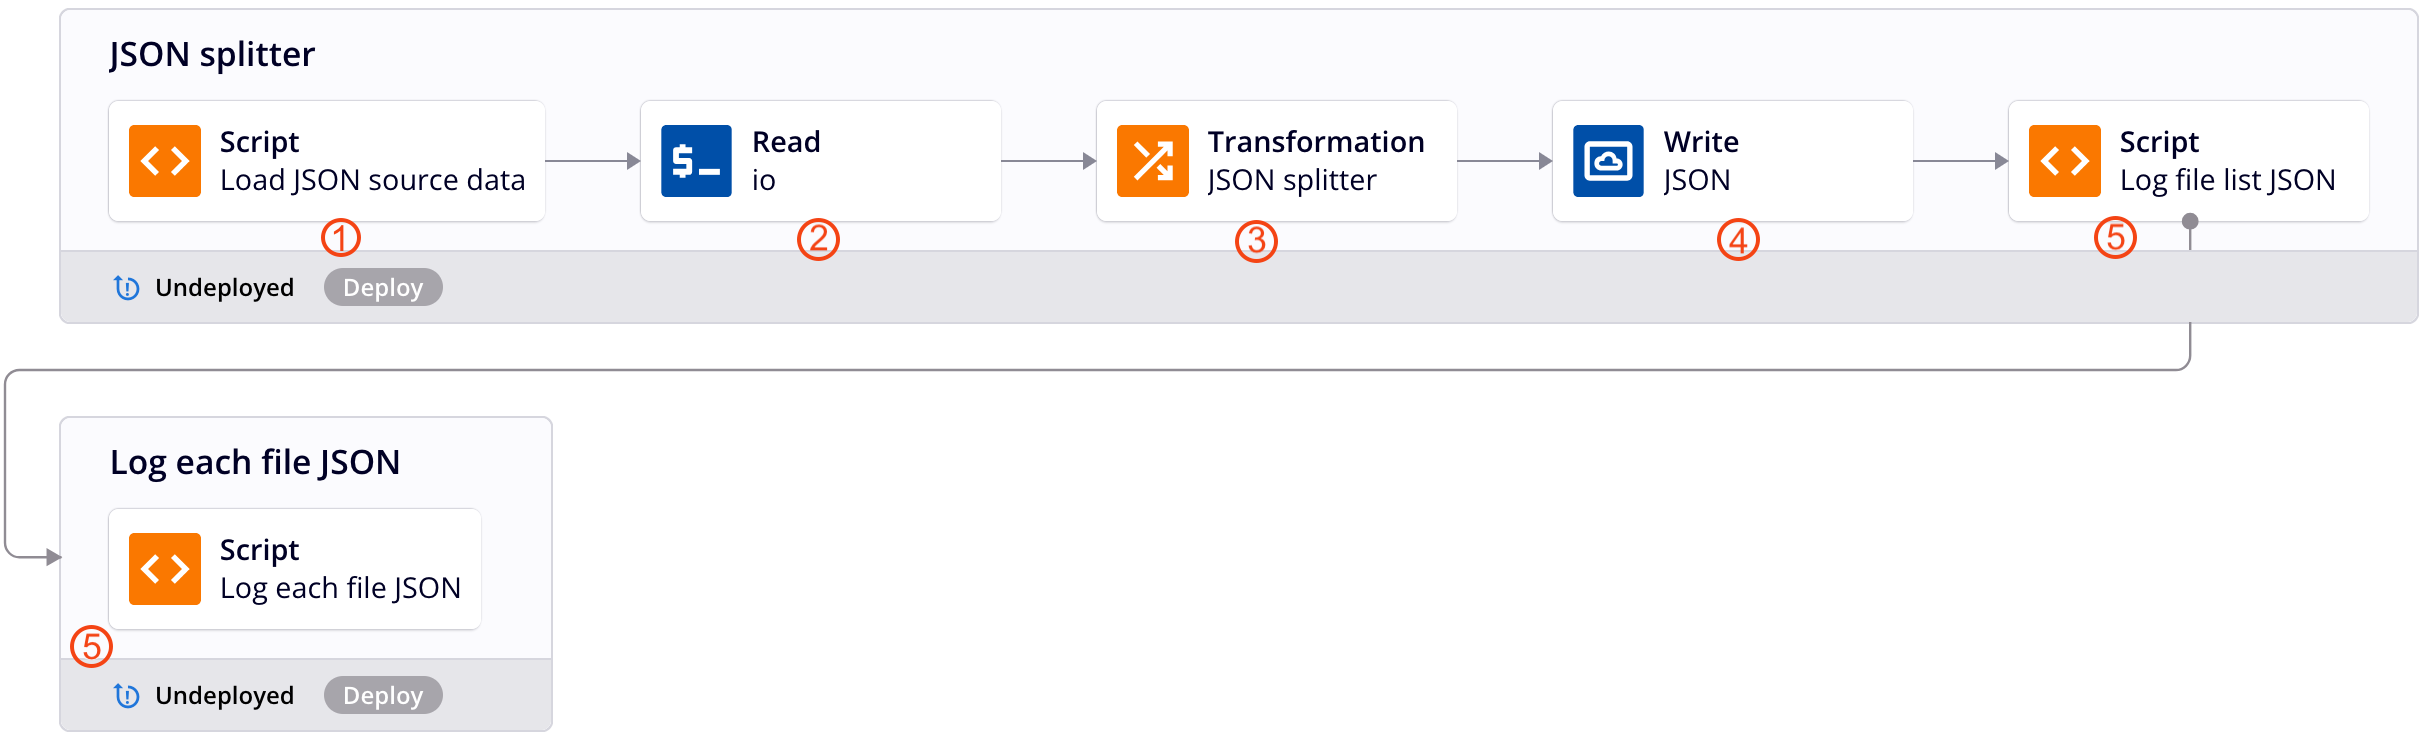
-
O script atribui os dados de origem a uma variável global chamada
io(entrada/saída). (Um script é usado para fins de demonstração; os dados de origem também poderiam vir de um endpoint configurado.)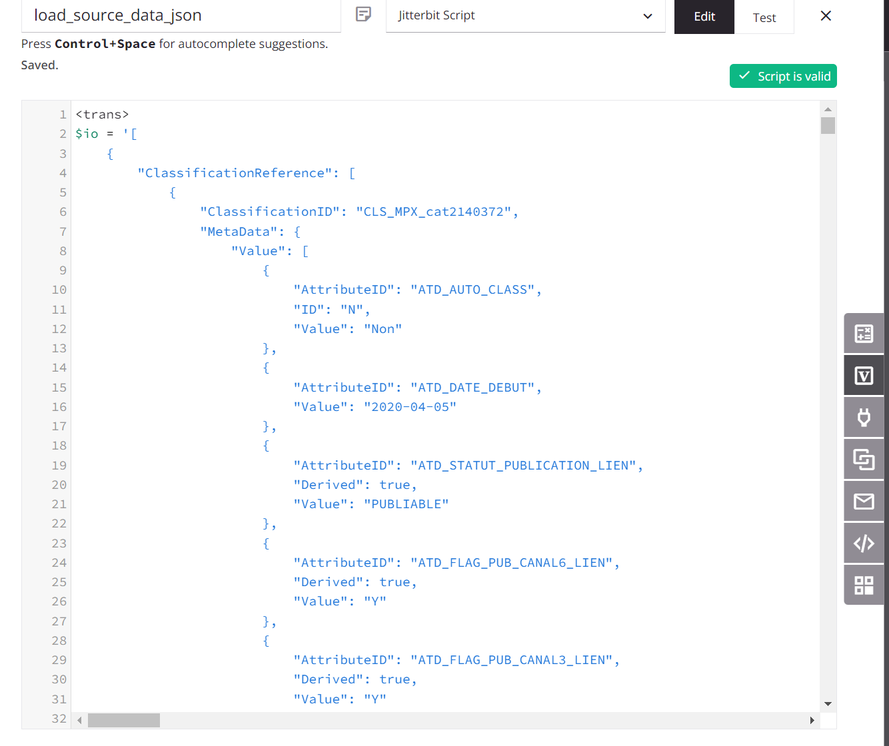
-
A variável global
ioé usada para configurar um endpoint de Variável, e uma atividade de Leitura de Variável associada é usada pela operação como fonte da transformação: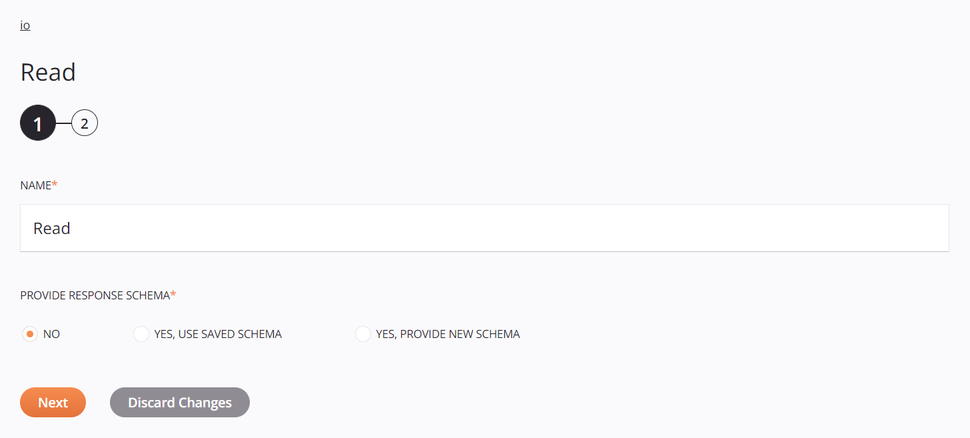
-
Dentro da transformação, a origem e o destino usam o mesmo esquema, e todos os campos são mapeados:
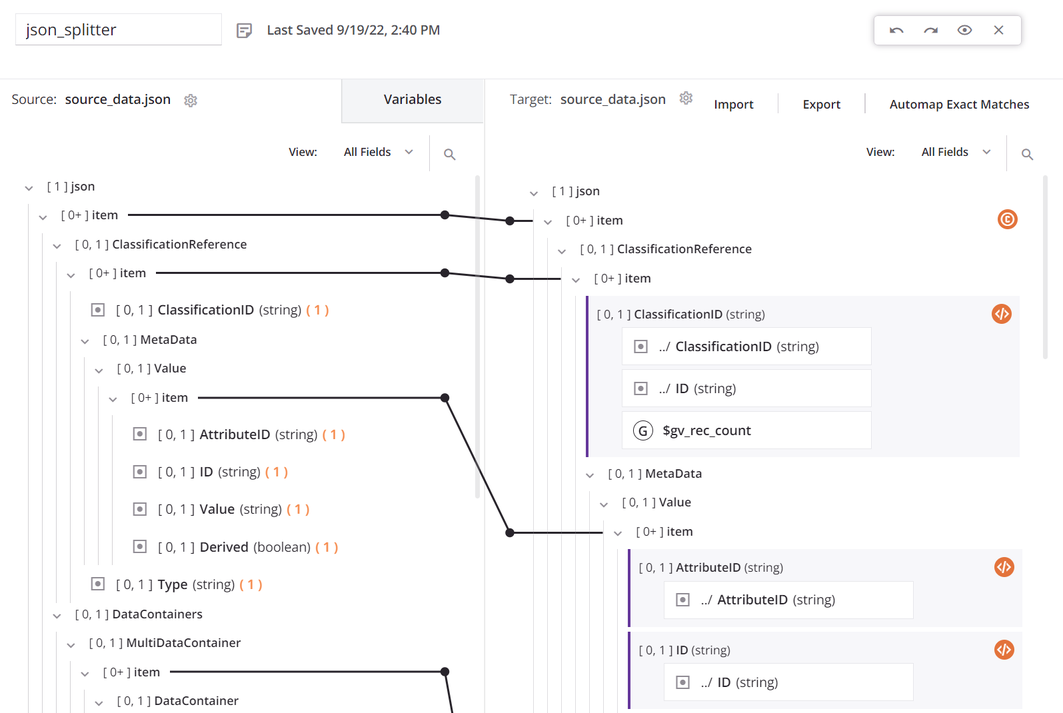
O nó
itemsuperior tem uma condição para gerar a contagem de registros. O primeiro campo de dados no mapeamento da transformação é configurado para usarSCOPE_CHUNK. A funçãoSeté usada para construir uma variável começando com a fraseSCOPE_CHUNKe é concatenada com o ID de registro único da origem, bem como um contador de registros e um sufixo.json: -
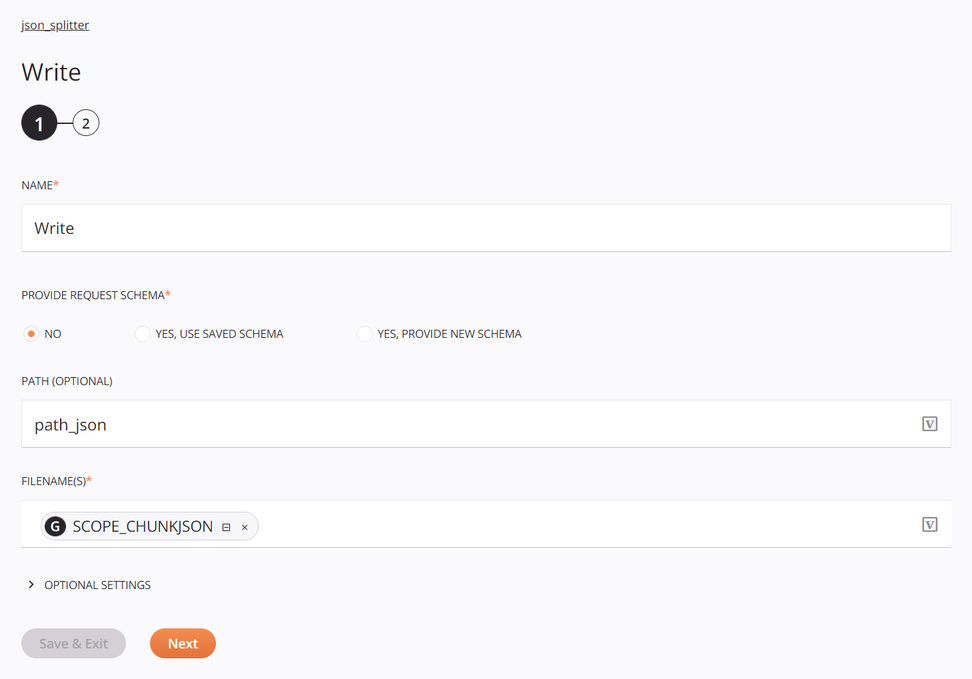
O destino é uma atividade de Escrita de Armazenamento Temporário configurada com um caminho padrão e a variável global de nome de arquivo definida anteriormente:
-
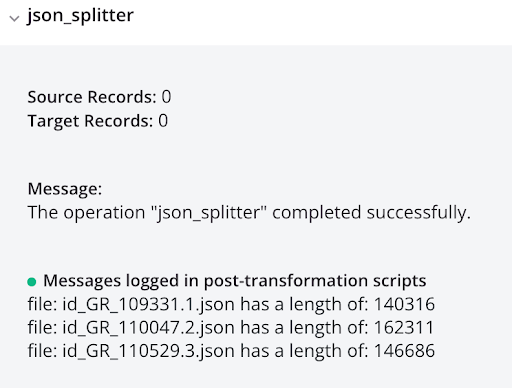
Os scripts são para registrar a saída e são opcionais. O primeiro script obtém uma lista de arquivos do diretório e faz um loop sobre a lista, registrando o nome e o tamanho do arquivo, e então passa o nome do arquivo para uma operação com outro script que registra o conteúdo do arquivo:
log_file_list_json<trans> arr = Array(); arr = FileList("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>"); cnt = Length(arr); i = 0; While(i < cnt, filename = arr[i]; file = ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",filename); WriteToOperationLog("file: " + filename + " has a length of: " + Length(file)); $gv_file_filter = filename; RunOperation("<TAG>operation:log_each_file_json</TAG>"); i++ ); </trans>log_each_file_json<trans> WriteToOperationLog(ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",$gv_file_filter)); </trans>Este script de registro opcional chama
RunOperationuma vez por arquivo dividido. Se mais de 50 arquivos forem produzidos, este loop atinge o limite no nível do agente para chamadas síncronas deRunOperationfeitas dentro de um único loopWhile(50por padrão); consulte a nota emRunOperationpara obter detalhes. -
As opções de operação devem ser configuradas com Enable Chunking selecionado, com um Chunk Size de
1, Number of Records per File de1e Max Number of Threads de1: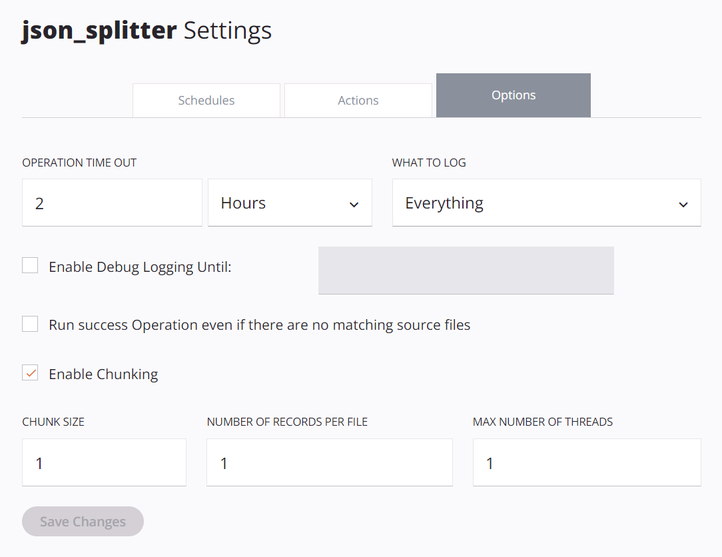
A execução da operação resulta em registros JSON individuais, mostrados na saída do log:
Após dividir e processar registros individuais, uma próxima etapa comum é enviar um email de resumo ou log de registros processados. Consulte Generate a summary log after processing records. Para considerações sobre a execução de operações por registro de forma concorrente, consulte Manage asynchronous operations.