Conceitos-chave para transformações no Jitterbit Studio
Esta página explica os conceitos fundamentais para entender ao projetar transformações e solucionar problemas.
Schemas
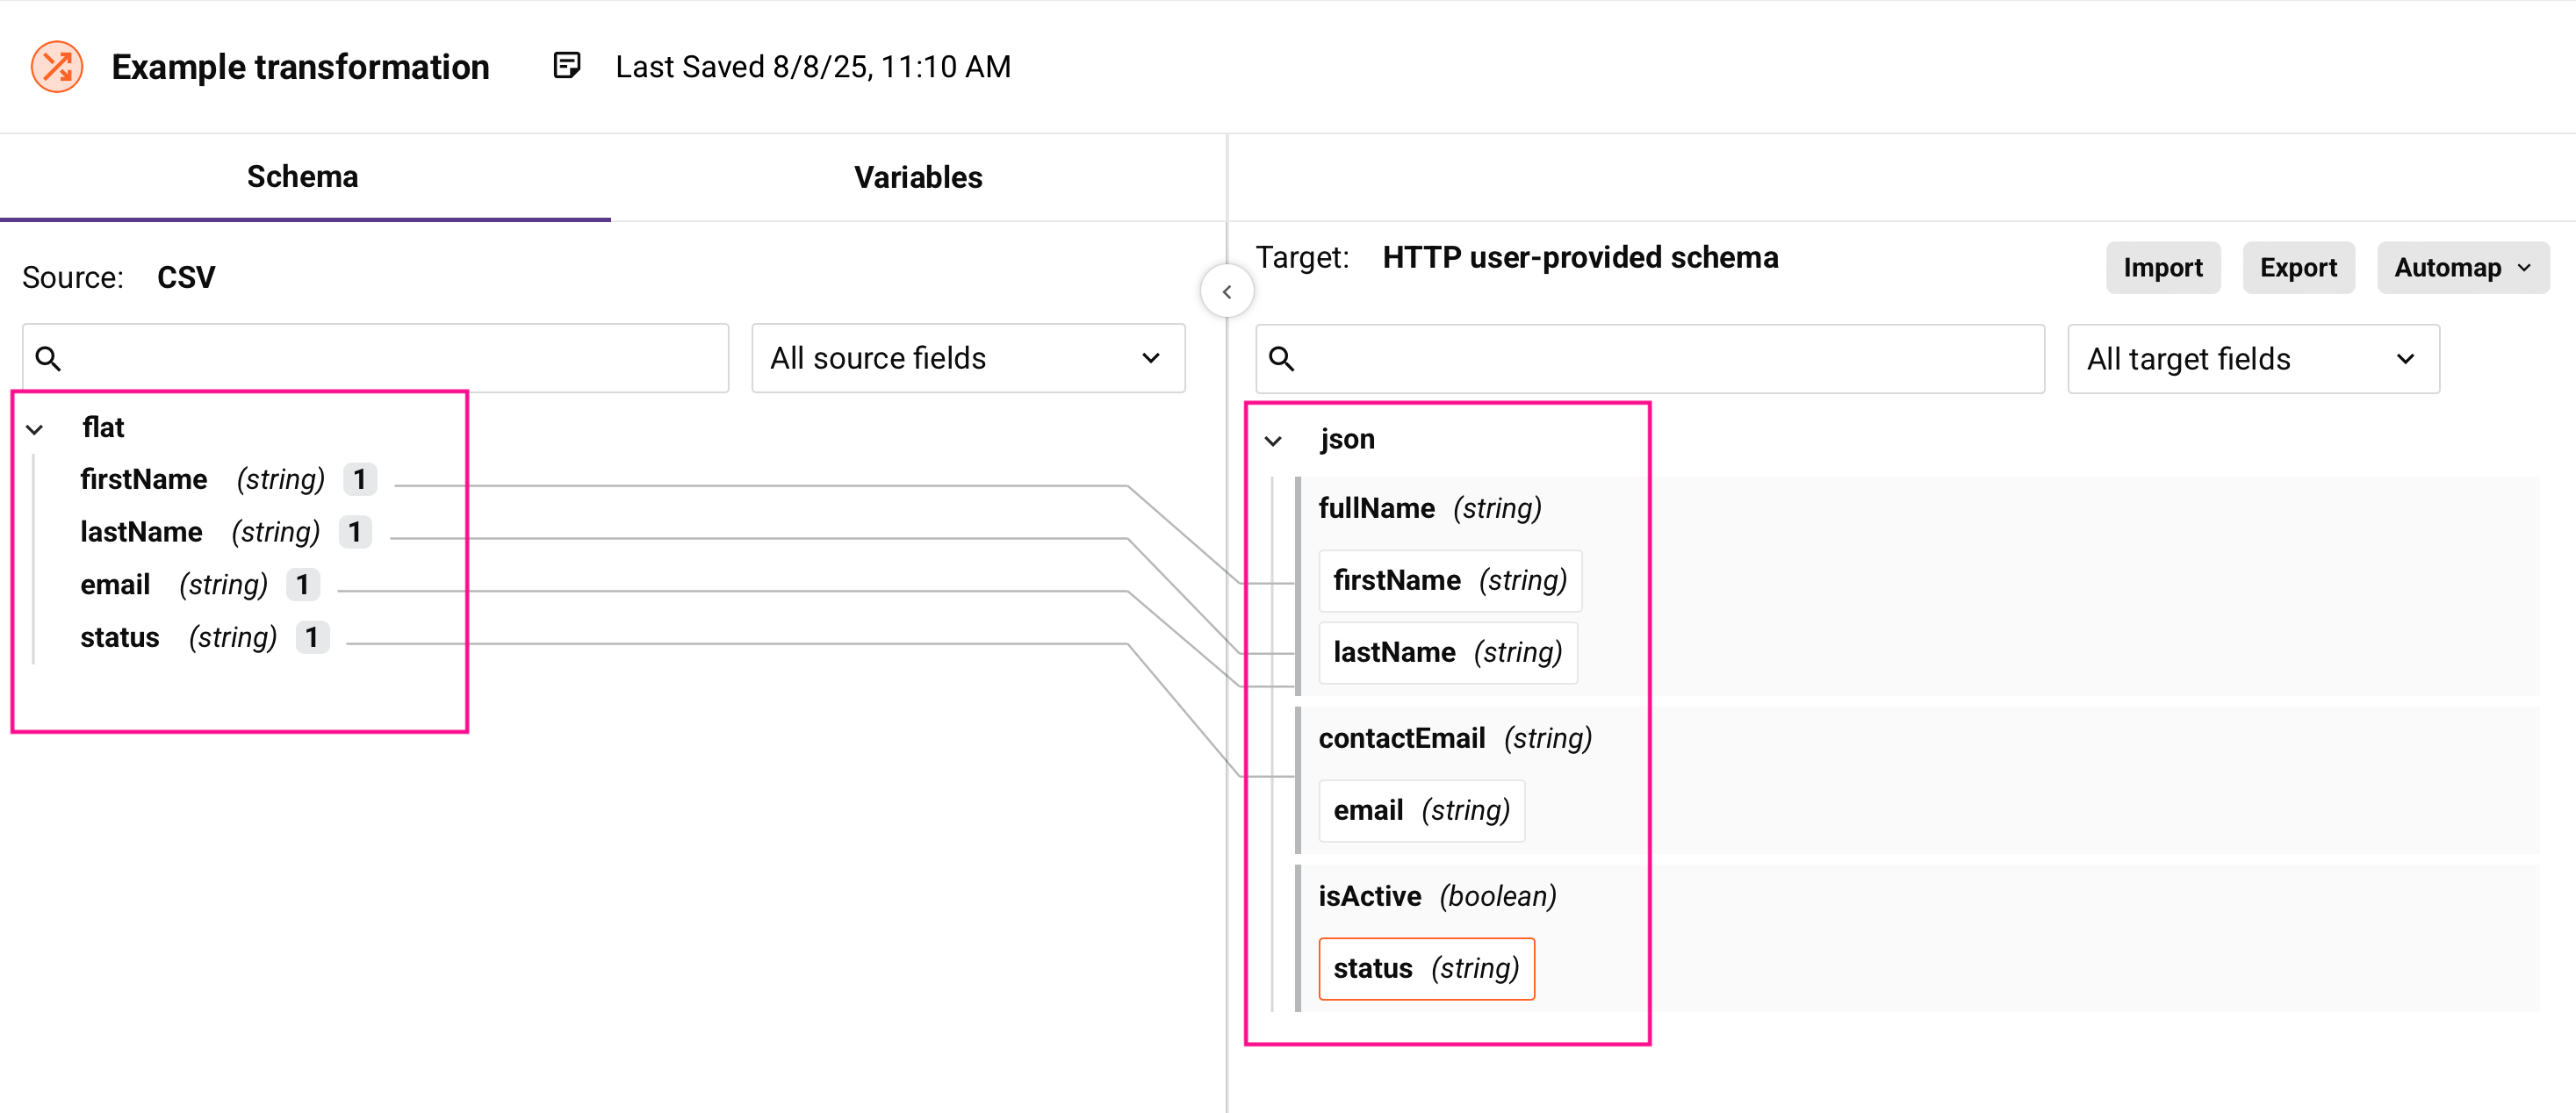
Um schema define a estrutura e os tipos de dados dos seus dados de entrada ou saída. Os schemas especificam quais campos estão disponíveis, seus tipos de dados e como os campos são organizados:
Schemas de origem
O schema de origem descreve a estrutura dos dados que entram na sua transformação. Os schemas de origem podem vir destas fontes:
-
Schemas gerados por atividades: Criados automaticamente por atividades de conectores, como consultas de banco de dados ou chamadas de API.
-
Schemas definidos pelo usuário: Schemas personalizados que você cria ou carrega.
Os schemas de origem são opcionais. Você não precisa de um schema de origem se estiver usando apenas variáveis, valores personalizados ou lógica com script nos seus mapeamentos.
Para mais informações, consulte Escolher fontes de schema.
Schemas de destino
O schema de destino descreve a estrutura dos dados que saem da sua transformação. Como os schemas de origem, os schemas de destino podem ser gerados por atividades ou definidos pelo usuário.
Os schemas de destino são sempre obrigatórios. Toda transformação deve ter um schema de destino que defina a estrutura de saída.
Para orientações detalhadas sobre como criar e configurar schemas, consulte Criar uma transformação e configurar schemas.
Estruturas de dados
As estruturas de dados definem como as informações são organizadas dentro dos schemas.
Estruturas simples
As estruturas simples contêm campos em um único nível sem aninhamento. Os exemplos incluem estes formatos:
- Arquivos CSV com colunas
- Tabelas de banco de dados únicas
- Arquivos XML simples sem elementos aninhados
Exemplo
<customer>
    <id>10123</id>
    <fullname>ABC Co.</fullname>
    <street>1 Main St.</street>
    <city>Anytown</city>
    <state>NY</state>
    <zip>12345</zip>
</customer>
Estruturas hierárquicas
As estruturas hierárquicas contêm relacionamentos aninhados entre campos e registros. Os exemplos incluem estes formatos:
- Arquivos XML complexos com elementos aninhados
- Objetos JSON com propriedades aninhadas
- Junções de banco de dados em várias tabelas
Exemplo
<customer>
    <id>10123</id>
    <name>ABC Co.</name>
    <addresses>
        <address>
            <street>1 Main St.</street>
            <city>Anytown</city>
            <state>NY</state>
            <zip>12345</zip>
        </address>
        <address>
            <street>1 Time Square</street>
            <city>New York City</city>
            <state>NY</state>
            <zip>54321</zip>
        </address>
    </addresses>
</customer>
Para mais informações sobre como trabalhar com estruturas de dados, consulte Mapear dados.
Para cenários de dados hierárquicos complexos, consulte Trabalhar com dados hierárquicos.
Nós e campos
Os schemas são exibidos como estruturas de árvore contendo nós e campos. Os nós são contêineres que organizam campos em estruturas hierárquicas. Os campos contêm os valores de dados reais.
Cada nó e campo mostra estes indicadores visuais:

- Chave de cardinalidade: Mostra regras de ocorrência entre colchetes.
- Nome: O identificador do elemento do schema
- Tipo de dados: Apenas para campos (string, integer, boolean, etc.)
-
Indicadores de atributo/valor: Algumas estruturas XML incluem símbolos adicionais:
Símbolo Significado @Dados de atributo do elemento, por exemplo @image#Dados de texto do elemento, por exemplo #text
Nós
Os nós são contêineres que organizam campos em estruturas hierárquicas:
- Setas: Expandem e recolhem nós.
- Nomes em negrito: Indicam nós contendo mapeamentos quando recolhidos.
- Expansão padrão: 8 níveis de profundidade para schemas com menos de 750 nós, 5 níveis de profundidade para schemas de 750 até 5.000 nós e 2 níveis de profundidade para schemas com 5.000 nós ou mais. Expandir ou recolher um nó além deste padrão é preservado quando você reabre a transformação.
Você não pode mapear dados diretamente para nós. Em vez disso, você mapeia dados para os campos que os nós contêm.
Campos
Campos armazenam os valores de dados reais e possuem estas propriedades:
- Nome: O identificador do campo.
- Tipo de dados: O tipo de dados, como string, inteiro, booleano, data e outros.
- Formato: Formatação opcional para datas ou moeda.
-
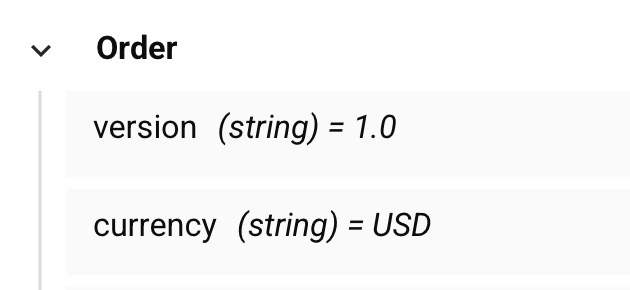
Valores padrão: Quando um esquema XSD ou WSDL especifica um valor padrão para um elemento ou atributo, o valor aparece ao lado do nome do campo na interface de transformação:
Notação de cardinalidade
As chaves de cardinalidade indicam regras de ocorrência usando notação estilo UML:
| Chave de cardinalidade | Definição |
|---|---|
[1] |
Exatamente um elemento (obrigatório) |
[1+] |
Um ou mais elementos (obrigatório, repetível) |
[0,1] |
Zero ou um elemento (opcional) |
[0+] |
Zero ou mais elementos (opcional, repetível) |
Mapeamentos
Um mapeamento conecta dados de origem aos campos de destino e define como os dados devem ser transformados.
Tipos de mapeamentos
-
Mapeamentos de campo direto: Conectam campos de origem diretamente aos campos de destino. Consulte Mapear campos manualmente.
-
Mapeamentos de valor personalizado: Atribuem valores estáticos ou expressões. Consulte Usar valores personalizados.
-
Mapeamentos de variável: Fazem referência a variáveis de projeto ou globais. Consulte Mapear variáveis.
-
Mapeamentos de script: Usam funções e lógica para transformar dados. Consulte Mapeamento com scripts.
-
Lógica condicional: Aplicam lógica diferente com base em condições. Consulte Lógica condicional.
Scripts de mapeamento
Todos os mapeamentos são implementados como scripts nos campos de destino. Até mesmo mapeamentos visuais como arrastar e soltar criam scripts subjacentes. É possível editar esses scripts diretamente para transformações complexas.
Para mapeamento automático de estruturas semelhantes, consulte Mapear estruturas idênticas.
Nós de loop
Nós de loop lidam com dados repetidos, como múltiplos registros ou arrays. Ao mapear campos dentro de nós de loop, a transformação processa cada iteração dos dados.
Geração automática de loop
Nós de loop são gerados automaticamente ao mapear campos de dados de origem repetidos para estruturas de destino repetidas. Uma linha iteradora aparece mostrando como a transformação fará loop pelos dados.
Definição manual de loop
É possível definir manualmente nós de loop quando a geração automática não corresponde às necessidades de processamento de dados. Isso é útil quando há múltiplos níveis de dados repetidos e é necessário controlar qual nível conduz a iteração.
Para orientação abrangente sobre como trabalhar com dados repetidos, consulte Controlar loops de dados.
Variáveis
Variáveis são projetadas para passar valores, configurações e pequenas quantidades de dados entre diferentes componentes na integração. Variáveis são úteis quando é necessário compartilhar informações como IDs de sessão, parâmetros de configuração ou valores calculados entre scripts, transformações e operações. Estes tipos de variável estão disponíveis para uso:
| Tipo | Escopo | Melhor para |
|---|---|---|
| Local | Script único | Cálculos e valores temporários |
| Global | Cadeia de operação | Passar dados entre operações |
| Project | Projeto inteiro | Configuração e credenciais |
| Jitterbit | Definido pelo sistema | Informações de tempo de execução |
Para exemplos e informações detalhadas sobre cada tipo de variável, consulte suas páginas de documentação individual.
Para exemplos práticos de uso de variáveis em transformações, consulte Mapear variáveis.
Fluxo de dados
Os dados fluem através das transformações nesta sequência:
-
Entrada: Uma atividade de origem fornece dados correspondentes ao esquema de origem.
-
Processamento: Uma transformação aplica mapeamentos, funções e lógica de negócios.
-
Saída: Os dados transformados correspondentes ao esquema de destino vão para a atividade de destino.
Compreender esse fluxo ajuda você a projetar mapeamentos que lidam com dados corretamente e a solucionar problemas quando os dados não se transformam conforme esperado.
Para orientação sobre validação e solução de problemas, consulte Testar e validar transformações e Resolver conflitos e erros de mapeamento de transformação.