Opções de operação no Jitterbit Studio
Introdução
Configure as opções de operação para controlar tempos limite, registros em log e processamento de dados. A maioria das operações funciona bem com as configurações padrão, mas você pode personalizá-las conforme necessário.
Acessar opções de operação
Você pode acessar a opção Configurações para operações nestes locais:
- A aba Workflows do painel de projeto (consulte Menu de ações de componente em Aba Workflows do painel de projeto).
- A aba Componentes do painel de projeto (consulte Menu de ações de componente em Aba Componentes do painel de projeto).
- A tela de design (consulte Menu de ações de componente em Tela de design).
- A tela de design clicando duas vezes na operação (isso abre Configurações diretamente).
Após a tela de configurações da operação estar aberta, selecione a aba Opções:
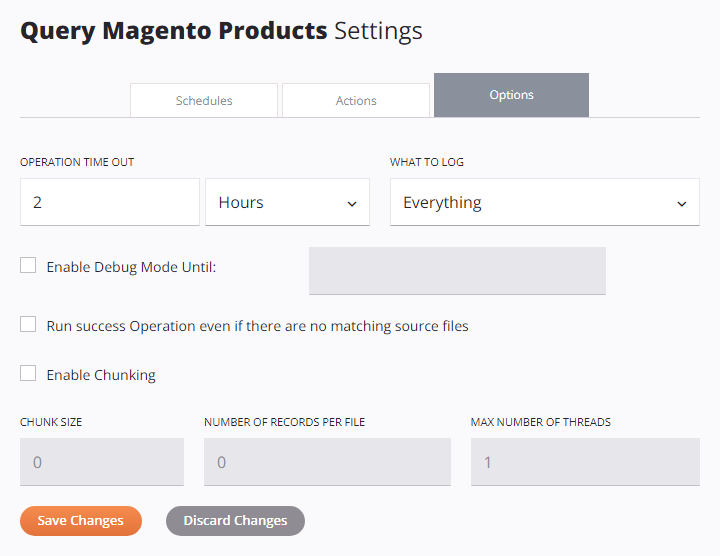
Configurar opções de operação
As seções a seguir descrevem cada opção de operação:
- Tempo limite da operação
- O que registrar em log
- Executar em agente dedicado
- Ativar modo de debug até
- Executar operação bem-sucedida mesmo se não houver arquivos de origem correspondentes
- Ativar fragmentação
- Opções de operação em massa do Salesforce
Tempo limite da operação
Defina por quanto tempo a operação é executada antes de ser cancelada. O padrão é 2 horas, o que funciona para a maioria das operações.
Você pode querer ajustar essa configuração por estes motivos:
-
Aumente o tempo limite para grandes conjuntos de dados que levam mais tempo para processar. Operações agendadas que processam grandes volumes de dados podem precisar de tempos limite mais longos. Se seus conjuntos de dados excederem os limites de tempo limite, consulte Ativar fragmentação para opções que dividem grandes conjuntos de dados em lotes menores e controlam o número de registros gravados por arquivo de saída.
-
Diminua o tempo limite para operações sensíveis ao tempo que devem ser concluídas rapidamente.
Digite um número de 1 a 10000 e selecione Segundos, Minutos ou Horas na lista suspensa.
Nota
Operações acionadas por APIs do API Manager ignoram essa configuração em agentes na nuvem. Para agentes privados, ative EnableAPITimeout no arquivo de configuração do agente privado para que a configuração Tempo limite da operação se aplique a operações acionadas por APIs.
O que registrar em log
Escolha quais informações aparecem nos registros de operação:
- Tudo: Registra toda a atividade da operação (recomendado).
- Apenas erros: Registra apenas operações com status de tipo erro (como Erro, Falha SOAP ou Sucesso com erro filho). Use essa configuração se você tiver problemas de desempenho e não precisar de registros detalhados. Operações filhas bem-sucedidas não são registradas. Operações pai (nível raiz) são sempre registradas, pois exigem registro para funcionar corretamente.
Depuração
A seção Depuração inclui opções para executar uma operação em um agente dedicado e ativar modo de depuração.
Executar em agente dedicado
Direcione essa operação para ser executada em um agente específico como medida temporária de solução de problemas. Essa opção se aplica apenas a grupos de agentes privados configurados com uma classe de grupo de agentes de Alta disponibilidade (HA). Use-a para reproduzir falhas em um agente específico ou para contornar um agente problemático mantendo o resto do grupo operacional.
Para ativar essa opção, marque a caixa de seleção Executar em agente dedicado e configure o seguinte:
-
Selecionar um agente: Selecione o agente específico dentro do grupo HA a ser usado para a execução dessa operação. Se o agente selecionado for deletado enquanto essa opção estiver ativa, a execução em agente dedicado será automaticamente desativada e a operação reverterá para a execução padrão do grupo de agentes.
-
Até: Selecione uma data de até duas semanas a partir de hoje. A execução em agente dedicado se desativa automaticamente nessa data e a operação reverte para o comportamento padrão de execução do grupo de agentes.
-
Aplicar a operações filhas: Se a operação tiver operações filhas, essa caixa de seleção aparece. Marque-a para direcionar todas as operações filhas a serem executadas no mesmo agente que a operação pai.
Quando Executar em agente dedicado está ativado, um aviso aparece.
Dialog
Executar essa operação em um único agente ignora sua configuração de Alta Disponibilidade (HA). Se esse agente falhar ou atingir a capacidade, a operação travará sem um failover.
Ativar modo de depuração até
Ative o registro detalhado para solução de problemas. Selecione uma data de até duas semanas a partir de hoje. O modo de depuração se desativa automaticamente nessa data.
Aviso
Em grupos de agentes na nuvem, a duração dessa configuração é pouco confiável. Os registros podem parar de ser gerados antes do final do período de tempo selecionado.
Ao ativar o modo de depuração para operações com operações filhas, você pode aplicar a mesma configuração a todas as operações filhas usando a caixa de seleção Aplicar também a operações filhas.
O registro de depuração gera diferentes tipos de registros com base no tipo de agente:
| Tipo de registro | Descrição do registro | Tipo de agente |
|---|---|---|
| Arquivos de registro de depuração | Arquivos de registro de depuração para solução de problemas detalhada. Você pode acessar esses arquivos diretamente no agente ou baixá-los através do Console de Gerenciamento. O registro de depuração também pode ser ativado para todo o projeto a partir do próprio agente privado (consulte Registro de depuração de operação). Os arquivos de registro de depuração são acessíveis diretamente em agentes privados e podem ser baixados através das páginas Agentes e Runtime do Console de Gerenciamento. Aviso O modo de depuração cria arquivos de registro grandes. Use apenas durante testes, não em produção. |
Apenas agentes privados |
| Entrada e saída do componente | Dados de solicitação e resposta (mantidos por 30 dias). Acessados através da página Runtime do Console de Gerenciamento. Cuidado Os dados de entrada e saída do componente sempre são registrados na nuvem do Harmony, mesmo se o registro em nuvem estiver desativado. Para interromper isso em agentes privados, defina Os registros de depuração contêm todos os dados de solicitação e resposta, incluindo informações confidenciais como senhas e informações de identificação pessoal (PII). Esses dados aparecem em texto simples nos registros da nuvem do Harmony por 30 dias. |
Agentes na nuvem e privados |
| Registros de operação de API | Registros de operações de API bem-sucedidas (configuradas para APIs personalizadas ou APIs OData). Por padrão, apenas operações de API com erros são registradas nos registros de operação. |
Agentes na nuvem e privados |
Executar operação com sucesso mesmo sem arquivos de origem correspondentes
Esta opção força uma operação a ter sucesso mesmo quando seu gatilho falha. Isso permite que outras operações configuradas para executar Ao Sucesso desta operação sejam executadas independentemente do resultado da operação inicial. Aplica-se apenas quando a operação inicial contém uma atividade de origem de um destes conectores:
- API
- Compartilhamento de Arquivos
- FTP
- HTTP
- Armazenamento Local
- SOAP
- Armazenamento Temporário
- Atividade de Variável
Por padrão, qualquer operação Ao Sucesso é executada apenas se houver um arquivo de origem correspondente para processar. Esta opção pode ser útil para configurar partes posteriores de um projeto sem exigir o sucesso de uma operação dependente.
Nota
A configuração AlwaysRunSuccessOperation no arquivo de configuração do agente privado substitui esta opção.
Ativar Fragmentação
A fragmentação divide grandes conjuntos de dados em fragmentos menores (lotes). Isso torna o processamento mais rápido e ajuda a atender aos limites de registros da API. Para um guia orientado por tarefas que aborda seleção de tamanho de fragmento, processamento paralelo e escopo de variáveis, consulte Configurar fragmentação de operação para grandes conjuntos de dados.
Para ativar a fragmentação, sua operação deve conter uma transformação ou uma atividade de um destes conectores:
Nota
A fragmentação é respeitada apenas quando a origem é um conector nativo. Se sua origem for outro conector, divida a operação em duas: use uma atividade Gravação de Variável como destino da primeira operação e, em seguida, use uma atividade Leitura de Variável como origem na segunda operação com fragmentação ativada.
Use fragmentação nestas situações:
- Você processa grandes conjuntos de dados com milhares de registros.
- Você usa serviços web com limites de registros. Por exemplo, o Salesforce permite apenas 200 registros por chamada.
- Você deseja usar múltiplos núcleos de CPU para processamento paralelo.
Dica
Para orientação sobre quando usar processamento em lote versus orientado por eventos em projetos de integração, consulte Processamento em lote e orientado por eventos.
Quando uma atividade Salesforce, Salesforce Service Cloud ou ServiceMax está na operação, a fragmentação é ativada automaticamente.
Quando esta configuração está ativada, configure estes campos:
-
Tamanho do Fragmento: O número de registros em cada fragmento. O padrão é
1para a maioria das operações e200para operações do Salesforce.Nota
Quando você usa uma atividade em massa (Salesforce, Salesforce Service Cloud ou ServiceMax), altere este padrão para um número muito maior, como
10.000. -
Número de Registros por Arquivo: O número de registros a serem gravados em cada arquivo de destino (lote). O padrão é
0, o que significa sem limite. -
Número Máximo de Threads: O número de threads de processamento que são executadas simultaneamente. O padrão é
1para a maioria das operações e2para operações do Salesforce.
Aviso
O chunking afeta como variáveis globais e de projeto funcionam. Apenas as alterações do primeiro thread são preservadas. Consulte informações detalhadas sobre chunking abaixo.
Opções de operação em massa do Salesforce
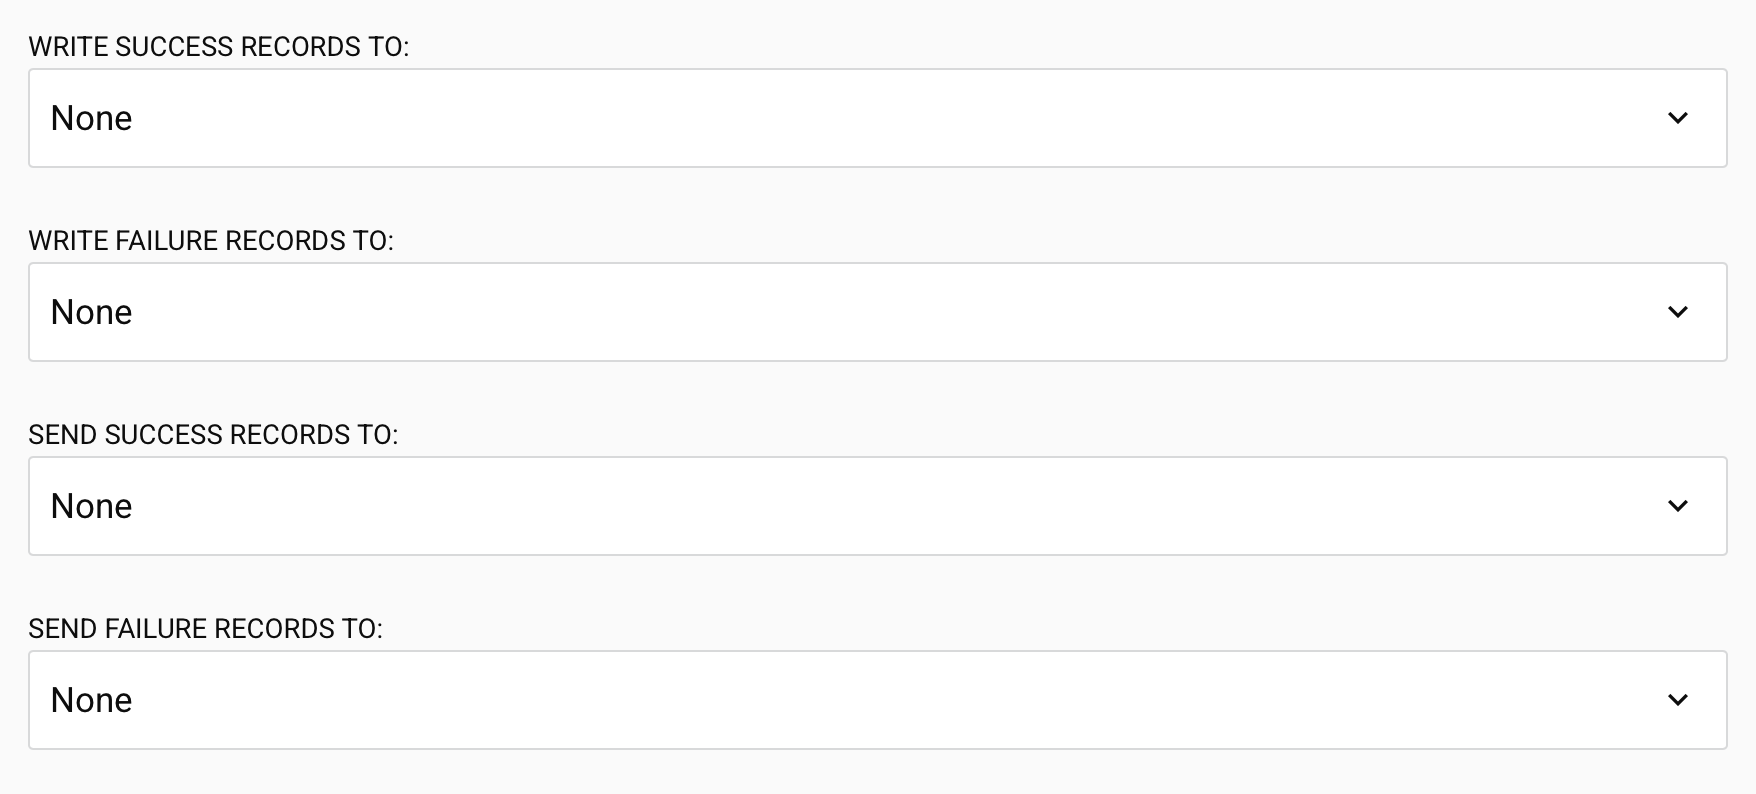
As opções a seguir aparecem apenas para operações em massa do Salesforce, Salesforce Service Cloud e ServiceMax (exceto operações de Bulk Query):
-
Gravar registros bem-sucedidos em: Escolha para onde enviar os registros bem-sucedidos após a conclusão da operação em massa. Selecione entre atividades baseadas em arquivo configuradas: HTTP, API, FTP, Compartilhamento de Arquivo, Armazenamento Local, Armazenamento Temporário ou Variável. Padrão: Nenhum.
-
Gravar registros com falha em: Escolha para onde enviar os registros com falha após a conclusão da operação em massa. HTTP, API, FTP, Compartilhamento de Arquivo, Armazenamento Local, Armazenamento Temporário ou Variável. Padrão: Nenhum.
Importante
Ao usar atividades de Variável, apenas operações na mesma cadeia de operações podem acessar o valor da variável durante a execução.
-
Enviar registros bem-sucedidos para: Escolha uma notificação por email para receber registros bem-sucedidos. Selecione entre notificações por email configuradas. Padrão: Nenhum.
-
Enviar registros com falha para: Escolha uma notificação por email para receber registros com falha. Selecione entre notificações por email configuradas. Padrão: Nenhum.
Nota
As atividades baseadas em arquivo e notificações por email selecionadas nessas opções não precisam fazer parte de uma operação já implantada. O Studio implantará e gerenciará automaticamente esses componentes quando selecionados.
Informações detalhadas sobre chunking
O chunking é usado para dividir os dados de origem em vários chunks (lotes) com base no tamanho de chunk configurado. O tamanho do chunk é o número de registros de origem (nós) para cada chunk. A transformação é então executada em cada chunk separadamente, com cada chunk de origem produzindo um chunk de destino. Os chunks de destino resultantes se combinam para produzir o destino final.
O chunking pode ser usado apenas se os registros forem independentes e de uma origem não-LDAP. Recomendamos usar um tamanho de chunk o maior possível, garantindo que os dados de um chunk caibam na memória disponível. Para métodos adicionais de limitação da quantidade de memória que uma transformação usa, consulte Processamento de transformação.
Aviso
O uso de chunking afeta o comportamento de variáveis globais e de projeto. Consulte Usar variáveis com chunking abaixo.
Limitações de API
Muitas APIs de serviços web (SOAP/REST) têm limitações de tamanho. Por exemplo, um upsert baseado em Salesforce aceita apenas 200 registros para cada chamada. Com memória suficiente, você pode configurar uma operação para usar um tamanho de chunk de 200. A origem seria dividida em chunks de 200 registros cada, e cada transformação chamaria o serviço web uma vez com um chunk de 200 registros. Isso se repetiria até que todos os registros fossem processados. Os arquivos de destino resultantes seriam então combinados. (Observe que você também poderia usar atividades em massa baseadas em Salesforce para evitar o uso de chunking.)
Processamento paralelo
Se você tiver uma origem grande e um computador com múltiplas CPUs, o chunking pode ser usado para dividir a origem para processamento paralelo. Como cada chunk é processado isoladamente, vários chunks podem ser processados em paralelo. Isso se aplica apenas se os registros de origem forem independentes uns dos outros no nível do nó de chunk. Serviços web podem ser chamados em paralelo usando chunking, melhorando o desempenho.
Ao usar chunking em uma operação em que o destino é um banco de dados, observe que os dados de destino são primeiro gravados em vários arquivos temporários (um para cada chunk). Esses arquivos são então combinados em um arquivo de destino, que é enviado ao banco de dados para inserção/atualização. Se você definir a variável Jitterbit jitterbit.target.db.commit_chunks como 1 ou true quando o chunking estiver ativado, cada chunk será confirmado no banco de dados conforme fica disponível. Isso pode melhorar significativamente o desempenho, pois as inserções/atualizações do banco de dados são executadas em paralelo.
Usar variáveis com chunking
Como o chunking pode invocar multi-threading, seu uso pode afetar o comportamento de variáveis que não são compartilhadas entre as threads.
Variáveis globais e variáveis de projeto são segregadas entre as instâncias de chunking, e embora os dados sejam combinados, as alterações nessas variáveis não são. Apenas as alterações feitas na thread inicial são preservadas ao final da transformação.
Por exemplo, se uma operação — com chunking e múltiplas threads — tiver uma transformação que altera uma variável global, o valor da variável global após o término da operação é o da primeira thread. Qualquer alteração na variável em outras threads é independente e é descartada quando a operação é concluída.
Essas variáveis globais são passadas para as outras threads por valor em vez de por referência, garantindo que qualquer alteração nas variáveis não seja refletida em outras threads ou operações. Isso é semelhante à função RunOperation quando em modo assíncrono.