Dividir un archivo en registros individuales usando SCOPE_CHUNK en Jitterbit Studio
Introducción
Este patrón de diseño se puede utilizar para dividir los datos en un archivo con múltiples registros en varios archivos, cada uno conteniendo un solo registro, usando la sintaxis del prefijo SCOPE_CHUNK de la función Set.
Consejo
Este patrón se recomienda cuando los datos de origen son planos (no jerárquicos) y la operación no contiene una transformación que utilice lógica condicional. Para datos de origen complejos (jerárquicos), consulta Dividir un archivo en registros individuales usando SourceInstanceCount.
Caso de uso
En este escenario, los datos de origen contienen múltiples registros, y el proceso empresarial o el punto final de destino requiere que los registros se procesen individualmente.
Patrón de diseño
Este patrón de diseño consiste en leer el archivo usando una operación donde la transformación utiliza el mismo esquema de origen y destino. Este patrón tiene estas características clave:
- En el primer campo de la transformación que procesa los datos, se utiliza la función
Setpara establecer una variable que comienza conSCOPE_CHUNKseguida de texto adicional para construir el nombre de la variable. El primer argumento construye el nombre del archivo de salida, típicamente usando un identificador de registro de los datos de origen. Los nombres de archivo deben ser únicos para evitar ser sobrescritos, por lo que se puede usar un contador de registros o un GUID como parte del nombre de archivo. - Se debe utilizar un destino de almacenamiento de archivos como Almacenamiento temporal o Almacenamiento local. (No se admite usar una Variable.) Se recomienda definir una ruta. El nombre de archivo debe configurarse con el nombre de variable global utilizado en la función
Set. - Las opciones de operación deben configurarse con Enable Chunking seleccionado, con un Chunk Size de
1, Number of Records per File de1y Max Number of Threads de1. - Durante la ejecución, cada registro se leerá y se le asignará un nombre de archivo único, y se escribirá individualmente en el destino.
Después de usar este patrón, típicamente el siguiente paso es usar la función FileList para obtener el array de nombres de archivo en el directorio (configura la actividad Read del directorio de archivos con el comodín *), luego recorre el array y lee cada archivo en el origen para la siguiente operación.
Ejemplos
Se proporcionan ejemplos usando el patrón de diseño descrito anteriormente para dos tipos diferentes de datos de origen: un archivo CSV plano y un archivo JSON jerárquico.
CSV plano
Esta cadena de operaciones de ejemplo aplica el patrón de diseño descrito anteriormente para dividir datos CSV planos en un archivo para cada registro. Cada número corresponde con una descripción del paso de operación a continuación. Para obtener detalles adicionales, consulta las capturas de pantalla del ejemplo JSON jerárquico.
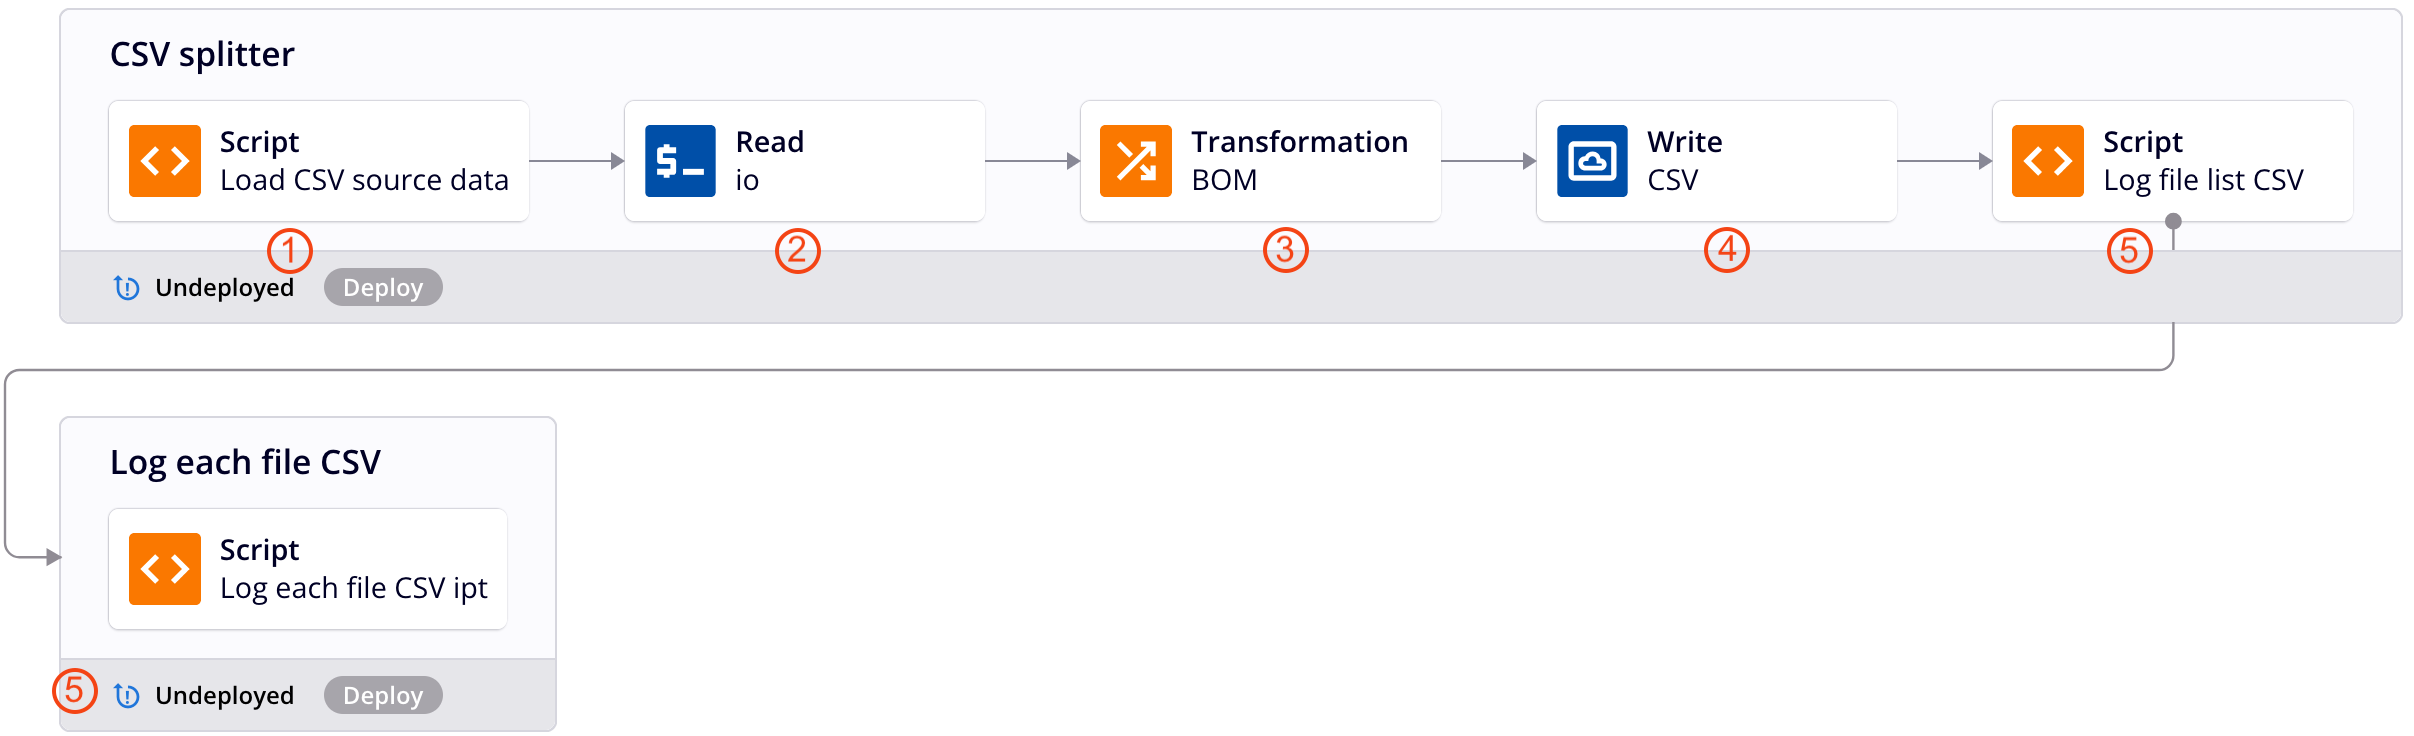
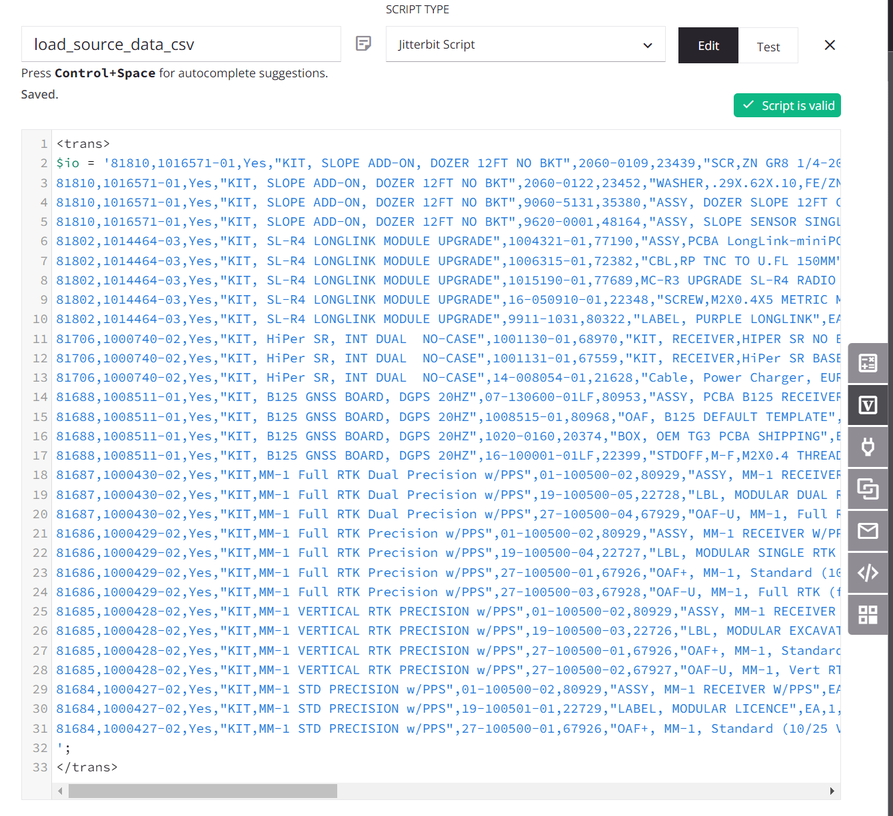
- El script asigna los datos de origen a una variable global denominada
io(entrada/salida). (Se utiliza un script con fines de demostración; los datos de origen también podrían provenir de un punto final configurado.)
-
La variable global
iose utiliza para configurar un endpoint de Variable, y una actividad Variable Read asociada se utiliza por la operación como fuente de la transformación. -
Dentro de la transformación, el origen y los destinos utilizan el mismo esquema, y todos los campos están asignados. El primer campo de datos en el script de asignación de la transformación se configura para utilizar
SCOPE_CHUNK. La funciónSetse utiliza para construir una variable que comienza con la fraseSCOPE_CHUNKy se concatena con el ID de registro único del origen, así como un contador de registros y un sufijo de.csv: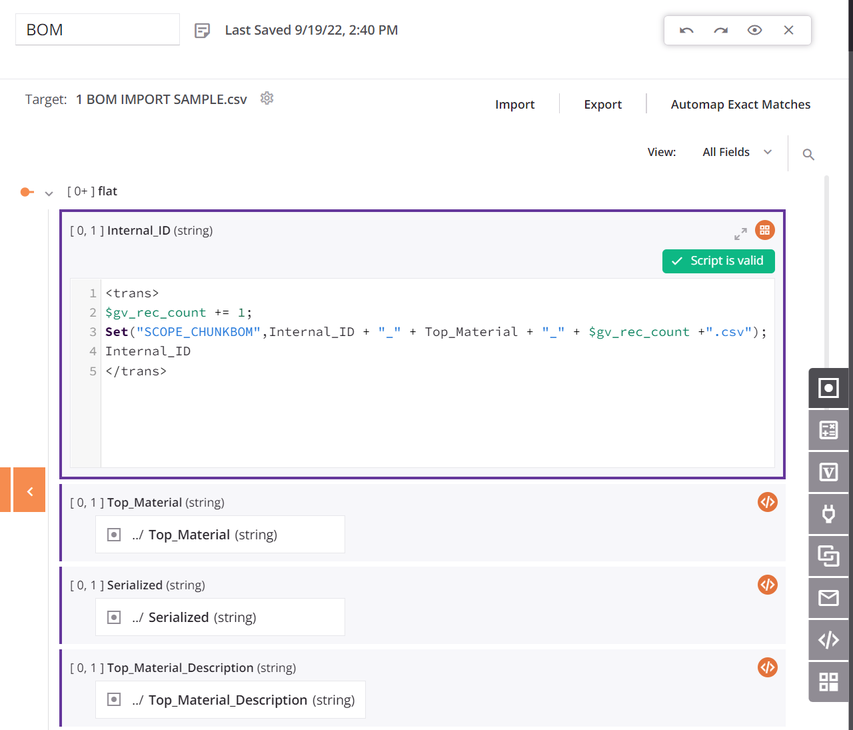
-
El destino es una actividad Write de Almacenamiento Temporal configurada con una ruta predeterminada y la variable global de nombre de archivo definida anteriormente.
-
Los scripts son para registrar la salida y son opcionales. El primer script obtiene una lista de los archivos del directorio e itera sobre la lista, registrando el nombre de archivo y el tamaño, y luego pasa el nombre de archivo a una operación con otro script que registra el contenido del archivo. (Consulta las capturas de pantalla del ejemplo JSON Jerárquico anterior).
-
Las opciones de operación deben configurarse con Enable Chunking seleccionado, con un Chunk Size de
1, Number of Records per File de1y Max Number of Threads de1.
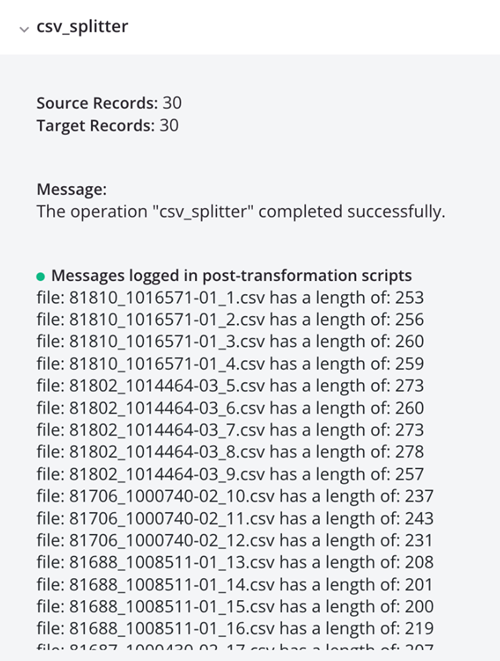
La ejecución de la operación genera registros CSV individuales, que se muestran en la salida del registro:
JSON Jerárquico
Esta cadena de operaciones de ejemplo aplica el patrón de diseño descrito anteriormente para dividir datos JSON jerárquicos en un archivo para cada registro. Cada número corresponde con una descripción del paso de operación a continuación.
Nota
Este patrón de diseño ya no es el método recomendado para dividir datos JSON jerárquicos. Para el método recomendado, consulta Dividir un archivo en registros individuales usando SourceInstanceCount.
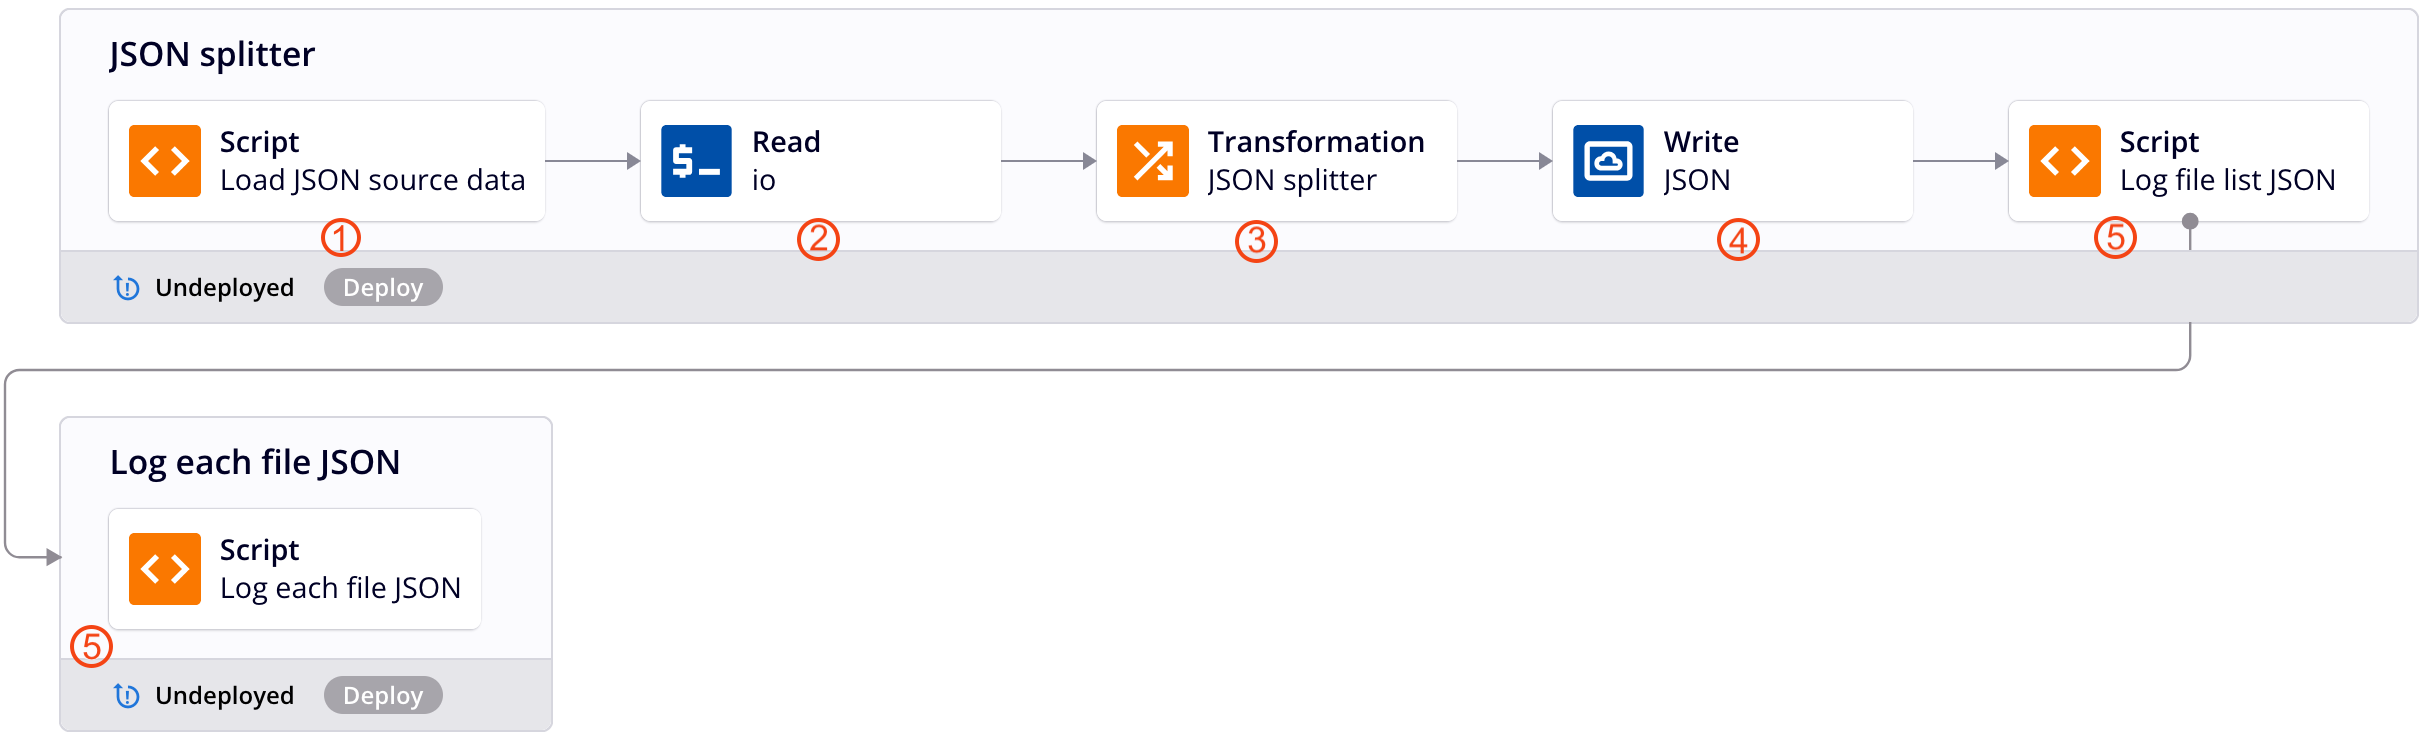
-
El script asigna los datos de origen a una variable global denominada
io(entrada/salida). (Se utiliza un script con fines de demostración; los datos de origen también podrían provenir de un endpoint configurado).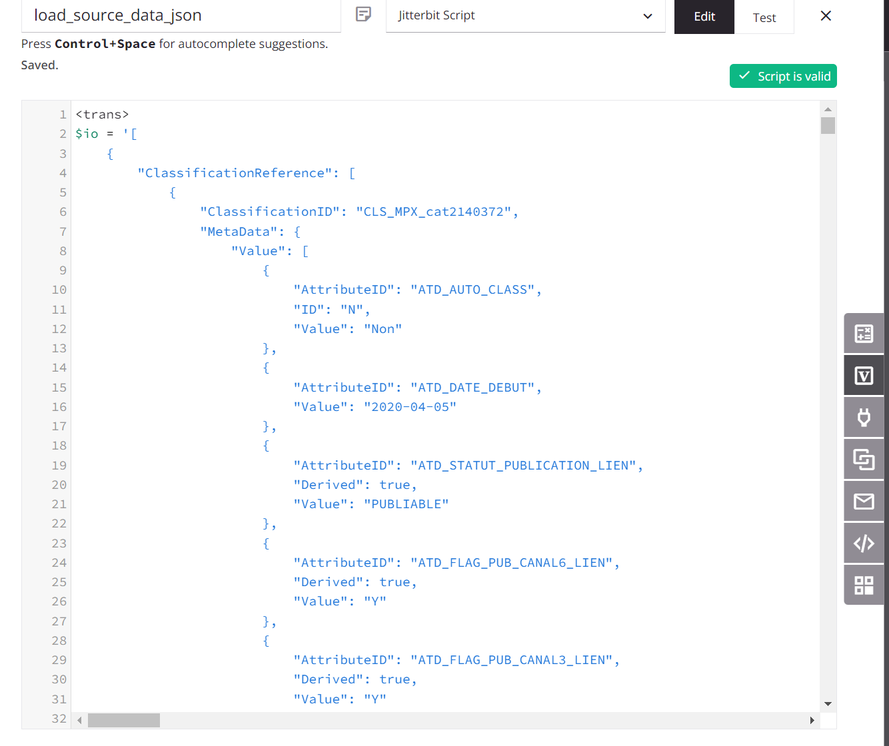
-
La variable global
iose utiliza para configurar un endpoint de Variable, y una actividad Variable Read asociada se utiliza por la operación como fuente de la transformación: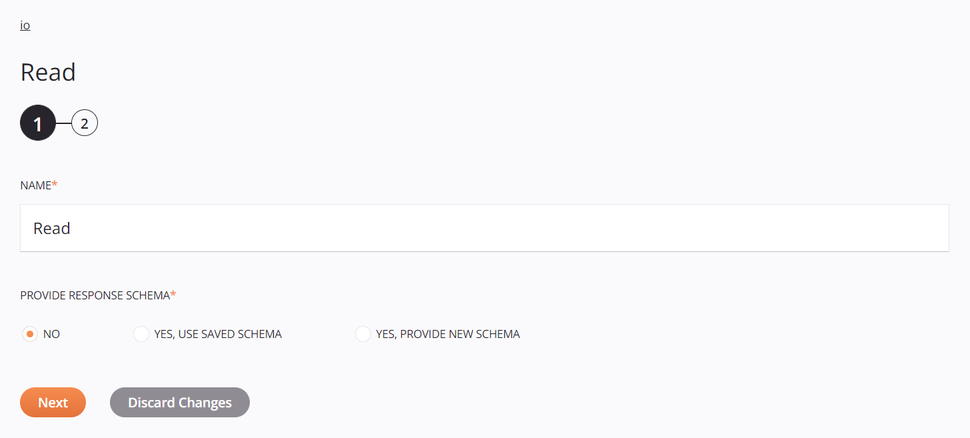
-
Dentro de la transformación, el origen y el destino utilizan el mismo esquema, y todos los campos están asignados:
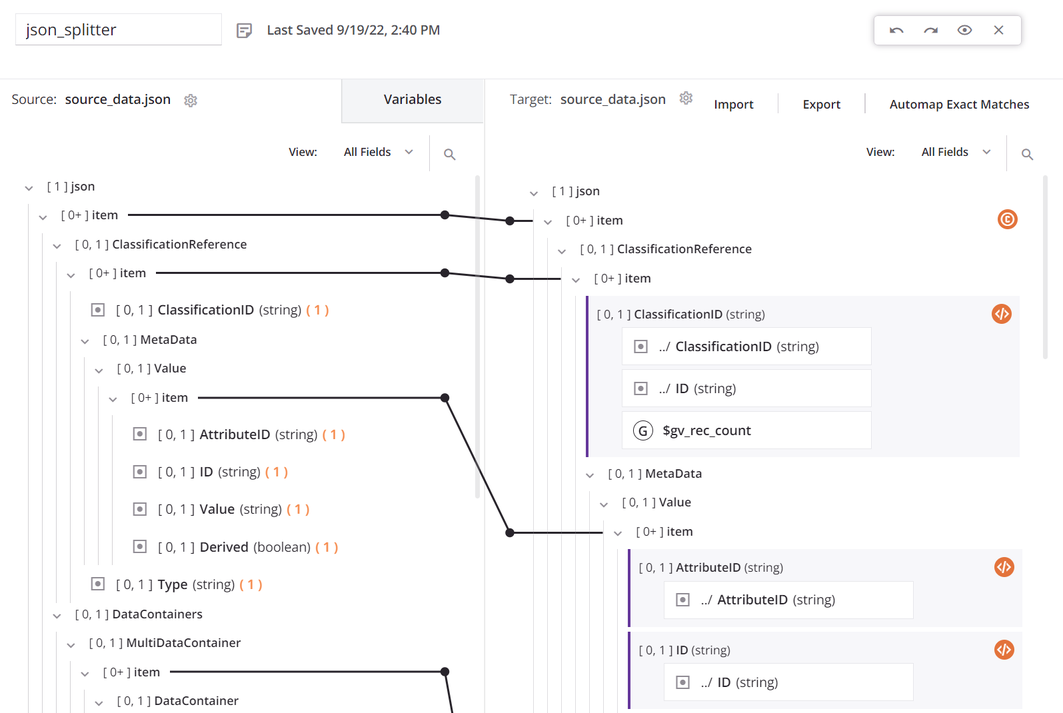
El nodo
itemsuperior tiene una condición para generar el recuento de registros. El primer campo de datos en la asignación de transformación se configura para utilizarSCOPE_CHUNK. La funciónSetse utiliza para construir una variable que comienza con la fraseSCOPE_CHUNKy se concatena con el ID de registro único del origen, así como un contador de registros y un sufijo de.json: -
El destino es una actividad Write de Almacenamiento Temporal configurada con una ruta predeterminada y la variable global de nombre de archivo definida anteriormente:
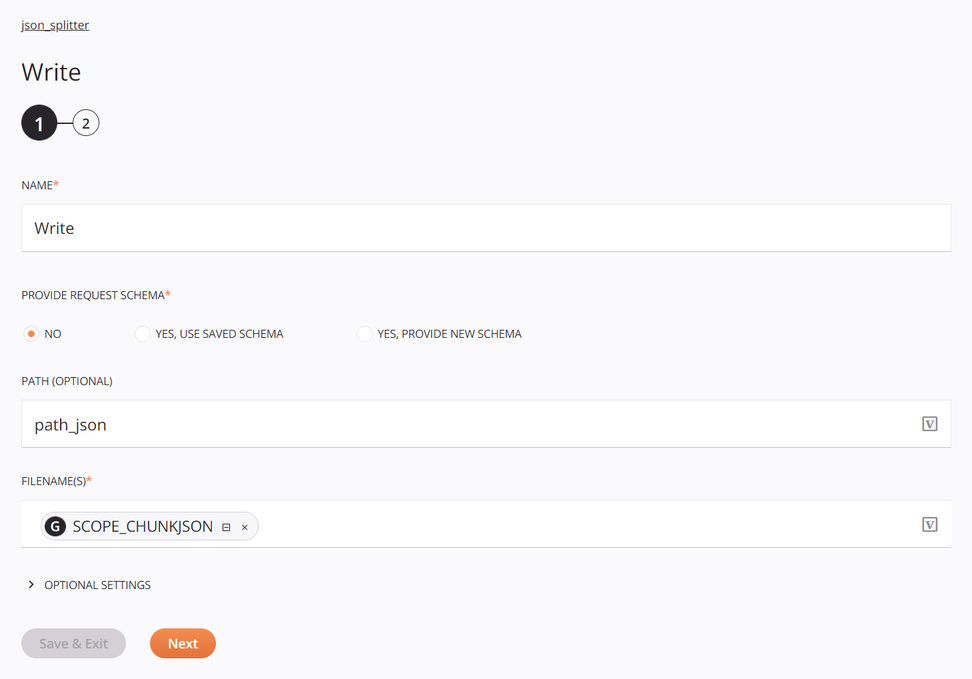
-
Los scripts son para registrar la salida y son opcionales. El primer script obtiene una lista de los archivos del directorio e itera sobre la lista, registrando el nombre y tamaño del archivo, y luego pasa el nombre del archivo a una operación con otro script que registra el contenido del archivo:
log_file_list_json<trans> arr = Array(); arr = FileList("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>"); cnt = Length(arr); i = 0; While(i < cnt, filename = arr[i]; file = ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",filename); WriteToOperationLog("file: " + filename + " has a length of: " + Length(file)); $gv_file_filter = filename; RunOperation("<TAG>operation:log_each_file_json</TAG>"); i++ ); </trans>log_each_file_json<trans> WriteToOperationLog(ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",$gv_file_filter)); </trans>Este script de registro opcional llama a
RunOperationuna vez por archivo dividido. Si se producen más de 50 archivos, este bucle alcanza el límite a nivel de agente en las llamadas síncronas deRunOperationrealizadas desde dentro de un único bucleWhile(50por defecto); consulta la nota bajoRunOperationpara más detalles. -
Las opciones de operación deben configurarse con Enable Chunking seleccionado, con un Chunk Size de
1, Number of Records per File de1y Max Number of Threads de1: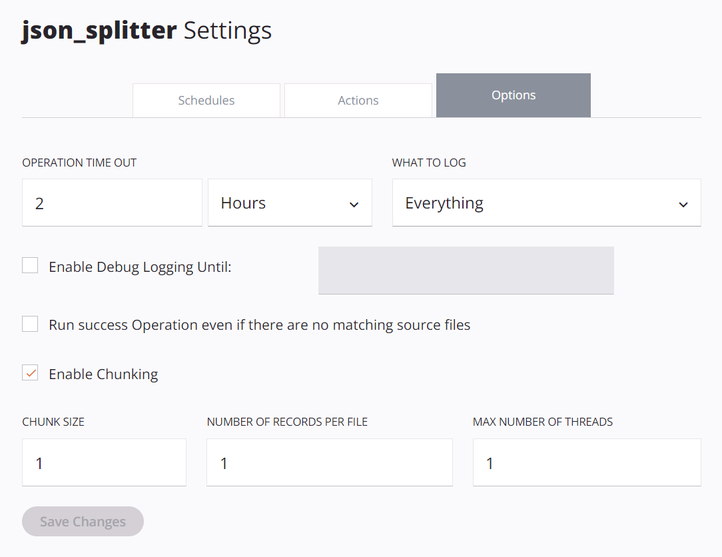
La ejecución de la operación genera registros JSON individuales, que se muestran en la salida del registro:
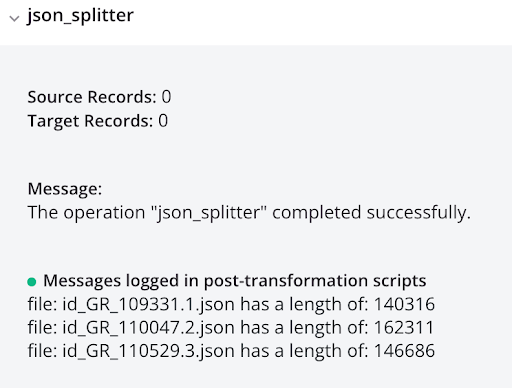
Después de dividir y procesar registros individuales, un paso siguiente común es enviar un correo electrónico de resumen o un registro de registros procesados. Consulta Generar un registro de resumen después de procesar registros. Para consideraciones sobre la ejecución concurrente de operaciones por registro, consulta Administrar operaciones asincrónicas.