Opciones de operación en Jitterbit Studio
Introducción
Configura las opciones de operación para controlar tiempos de espera, registro y procesamiento de datos. La mayoría de las operaciones funcionan bien con la configuración predeterminada, pero puedes personalizarlas según tus necesidades específicas.
Acceder a las opciones de operación
Puedes acceder a la opción Configuración para operaciones desde estas ubicaciones:
- La pestaña Flujos de trabajo del panel del proyecto (consulta Menú de acciones de componentes en Pestaña Flujos de trabajo del panel del proyecto).
- La pestaña Componentes del panel del proyecto (consulta Menú de acciones de componentes en Pestaña Componentes del panel del proyecto).
- El lienzo de diseño (consulta Menú de acciones de componentes en Lienzo de diseño).
- El lienzo de diseño haciendo doble clic en la operación (esto abre Configuración directamente).
Después de que se abra la pantalla de configuración de la operación, selecciona la pestaña Opciones:
Configurar opciones de operación
Las siguientes secciones describen cada opción de operación:
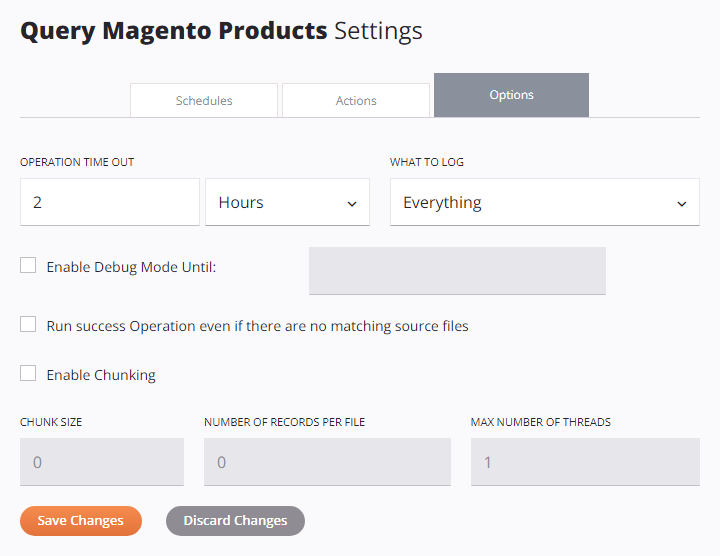
- Tiempo de espera de la operación
- Qué registrar
- Ejecutar en agente dedicado
- Habilitar modo de registro de depuración hasta
- Ejecutar operación exitosa incluso si no hay archivos de origen coincidentes
- Habilitar fragmentación
- Opciones de operación masiva de Salesforce
Tiempo de espera de la operación
Establece cuánto tiempo se ejecuta la operación antes de que se cancele. El valor predeterminado es 2 horas, lo que funciona para la mayoría de las operaciones.
Quizás quieras ajustar esta configuración por estas razones:
-
Aumenta el tiempo de espera para conjuntos de datos grandes que tardan más en procesarse. Las operaciones programadas que procesan grandes volúmenes de datos pueden necesitar tiempos de espera más largos. Si tus conjuntos de datos superan los límites de tiempo de espera, consulta Habilitar fragmentación para opciones que dividen conjuntos de datos grandes en lotes más pequeños y controlan la cantidad de registros escritos por archivo de salida.
-
Disminuye el tiempo de espera para operaciones sensibles al tiempo que deben completarse rápidamente.
Ingresa un número del 1 al 10000 y selecciona Segundos, Minutos u Horas en el menú desplegable.
Nota
Las operaciones activadas por APIs de API Manager ignoran esta configuración en agentes en la nube. Para agentes privados, habilita EnableAPITimeout en el archivo de configuración del agente privado para que la configuración Tiempo de espera de la operación se aplique a operaciones activadas por APIs.
Qué registrar
Elige qué información aparece en los registros de operación:
- Todo: Registra toda la actividad de la operación (recomendado).
- Solo errores: Registra solo operaciones con estado de tipo error (como Error, SOAP Fault o Éxito con error secundario). Usa esta configuración si tienes problemas de rendimiento y no necesitas registros detallados. Las operaciones secundarias exitosas no se registran. Las operaciones principales (de nivel raíz) siempre se registran, ya que requieren registro para funcionar correctamente.
Depuración
La sección Depuración incluye opciones para ejecutar una operación en un agente dedicado y habilitar modo de depuración.
Ejecutar en agente dedicado
Dirige esta operación para que se ejecute en un agente específico como medida temporal de solución de problemas. Esta opción se aplica solo a grupos de agentes privados configurados con una clase de grupo de agentes de Alta disponibilidad (HA). Úsala para reproducir fallos en un agente específico o para eludir un agente problemático mientras mantienes el resto del grupo operativo.
Para habilitar esta opción, selecciona la casilla Ejecutar en agente dedicado y configura lo siguiente:
-
Seleccionar un agente: Selecciona el agente específico dentro del grupo de HA que se utilizará para la ejecución de esta operación. Si se elimina el agente que seleccionas mientras esta opción está activa, la ejecución del agente dedicado se desactiva automáticamente y la operación vuelve a la ejecución estándar del grupo de agentes.
-
Hasta: Selecciona una fecha hasta dos semanas a partir de hoy. La ejecución del agente dedicado se desactiva automáticamente en esta fecha y la operación vuelve al comportamiento estándar de ejecución del grupo de agentes.
-
Aplicar a operaciones secundarias: Si la operación tiene operaciones secundarias, aparece esta casilla. Selecciónala para dirigir todas las operaciones secundarias a ejecutarse en el mismo agente que la operación principal.
Cuando Ejecutar en agente dedicado está habilitado, aparece una advertencia.
Diálogo
Ejecutar esta operación en un solo agente omite tu configuración de Alta Disponibilidad (HA). Si este agente falla o alcanza su capacidad, la operación se detendrá sin conmutación por error.
Habilitar modo de depuración hasta
Activa el registro detallado para solucionar problemas. Selecciona una fecha hasta dos semanas a partir de hoy. El modo de depuración se desactiva automáticamente en esta fecha.
Advertencia
En grupos de agentes en la nube, la duración de esta configuración no es confiable. Los registros pueden dejar de generarse antes del final del período de tiempo seleccionado.
Cuando habilitas el modo de depuración para operaciones con operaciones secundarias, puedes aplicar la misma configuración a todas las operaciones secundarias usando la casilla Aplicar también a operaciones secundarias.
El registro de depuración genera diferentes tipos de registros según tu tipo de agente:
| Tipo de registro | Descripción del registro | Tipo de agente |
|---|---|---|
| Archivos de registro de depuración | Archivos de registro de depuración para solucionar problemas detallados. Puedes acceder a estos archivos directamente en el agente o descargarlos a través de la Consola de administración. El registro de depuración también se puede habilitar para todo el proyecto desde el agente privado mismo (consulta Registro de depuración de operaciones). Los archivos de registro de depuración son accesibles directamente en agentes privados y se pueden descargar a través de las páginas Agentes y Tiempo de ejecución de la Consola de administración. Advertencia El modo de depuración crea archivos de registro grandes. Úsalo solo durante las pruebas, no en producción. |
Solo agentes privados |
| Entrada y salida de componentes | Datos de solicitud y respuesta (conservados durante 30 días). Se accede a través de la página Tiempo de ejecución de la Consola de administración. Precaución Los datos de entrada y salida de componentes siempre se registran en la nube de Harmony, incluso si el registro en la nube está deshabilitado. Para detener esto en agentes privados, establece Los registros de depuración contienen todos los datos de solicitud y respuesta, incluida información sensible como contraseñas e información de identificación personal (PII). Estos datos aparecen en texto sin cifrar en los registros de la nube de Harmony durante 30 días. |
Agentes en la nube y privados |
| Registros de operaciones de API | Registros de operaciones de API exitosas (configuradas para API personalizadas u API OData). De forma predeterminada, solo las operaciones de API con errores se registran en los registros de operaciones. |
Agentes en la nube y privados |
Ejecutar operación exitosa incluso si no hay archivos de origen coincidentes
Esta opción fuerza que una operación sea exitosa incluso cuando su activador falla. Esto permite que otras operaciones configuradas para ejecutarse Al Éxito de esta operación se ejecuten independientemente del resultado de la operación inicial. Se aplica solo cuando la operación inicial contiene una actividad de origen de uno de estos conectores:
- API
- Recurso Compartido de Archivos
- FTP
- HTTP
- Almacenamiento Local
- SOAP
- Almacenamiento Temporal
- Actividad de Variable
De forma predeterminada, las operaciones Al Éxito se ejecutan solo si tienen un archivo de origen coincidente para procesar. Esta opción puede ser útil para configurar partes posteriores de un proyecto sin requerir el éxito de una operación dependiente.
Nota
La configuración AlwaysRunSuccessOperation en el archivo de configuración del agente privado anula esta opción.
Habilitar Fragmentación
La fragmentación divide conjuntos de datos grandes en fragmentos más pequeños (lotes). Esto acelera el procesamiento y ayuda a cumplir con los límites de registros de API. Para una guía orientada a tareas que cubre la selección del tamaño de fragmento, procesamiento paralelo y alcance de variables, consulta Configurar fragmentación de operaciones para conjuntos de datos grandes.
Para habilitar la fragmentación, la operación debe contener una transformación o una actividad de uno de estos conectores:
Nota
La fragmentación se respeta solo cuando el origen es un conector nativo. Si el origen es otro conector, divide la operación en dos: utiliza una actividad Escribir de Variable como destino de la primera operación, luego utiliza una actividad Leer de Variable como origen en la segunda operación con fragmentación habilitada.
Utiliza fragmentación en estas situaciones:
- Procesas conjuntos de datos grandes con miles de registros.
- Utilizas servicios web con límites de registros. Por ejemplo, Salesforce permite solo 200 registros por llamada.
- Deseas utilizar múltiples núcleos de CPU para procesamiento paralelo.
Consejo
Para orientación sobre cuándo utilizar procesamiento por lotes versus procesamiento impulsado por eventos en proyectos de integración, consulta Procesamiento por lotes e impulsado por eventos.
Cuando una actividad de Salesforce, Salesforce Service Cloud o ServiceMax está en la operación, la fragmentación se habilita automáticamente.
Cuando esta configuración está habilitada, configura estos campos:
-
Tamaño de Fragmento: El número de registros en cada fragmento. El valor predeterminado es
1para la mayoría de operaciones y200para operaciones de Salesforce.Nota
Cuando utilizas una actividad masiva de (Salesforce, Salesforce Service Cloud o ServiceMax), cambia este valor predeterminado a un número mucho mayor, como
10,000. -
Número de registros por archivo: La cantidad de registros que se escriben en cada archivo de destino (lote). El valor predeterminado es
0, lo que significa sin límite. -
Número máximo de subprocesos: La cantidad de subprocesos de procesamiento que se ejecutan simultáneamente. El valor predeterminado es
1para la mayoría de las operaciones y2para las operaciones de Salesforce.
Advertencia
La fragmentación afecta cómo funcionan las variables globales y de proyecto. Solo se conservan los cambios del primer subproceso. Consulta la información detallada sobre fragmentación a continuación.
Opciones de operación masiva de Salesforce
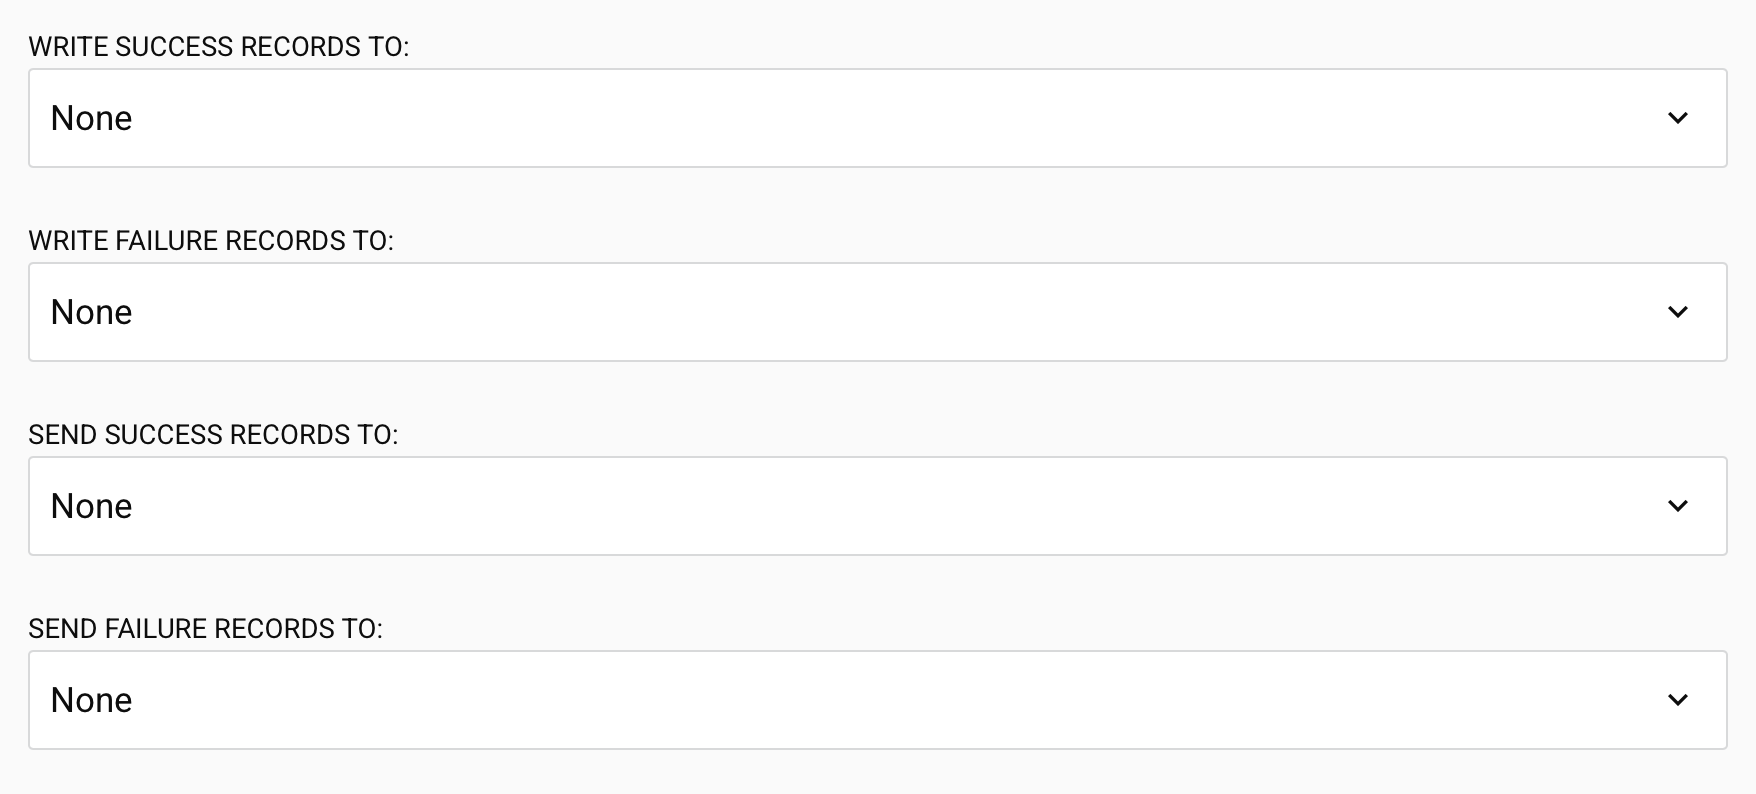
Las siguientes opciones aparecen solo para operaciones masivas de Salesforce, Salesforce Service Cloud y ServiceMax (excepto operaciones de Bulk Query):
-
Escribir registros exitosos en: Elige dónde enviar los registros exitosos después de que se complete la operación masiva. Selecciona entre actividades basadas en archivos configuradas: HTTP, API, FTP, Recurso compartido de archivos, Almacenamiento local, Almacenamiento temporal o Variable. Predeterminado: Ninguno.
-
Escribir registros fallidos en: Elige dónde enviar los registros fallidos después de que se complete la operación masiva. HTTP, API, FTP, Recurso compartido de archivos, Almacenamiento local, Almacenamiento temporal o Variable. Predeterminado: Ninguno.
Importante
Cuando utilizas actividades de Variable, solo las operaciones en la misma cadena de operaciones pueden acceder al valor de la variable durante la ejecución.
-
Enviar registros exitosos a: Elige una notificación por correo electrónico para recibir registros exitosos. Selecciona entre notificaciones por correo electrónico configuradas. Predeterminado: Ninguno.
-
Enviar registros fallidos a: Elige una notificación por correo electrónico para recibir registros fallidos. Selecciona entre notificaciones por correo electrónico configuradas. Predeterminado: Ninguno.
Nota
Las actividades basadas en archivos y las notificaciones por correo electrónico seleccionadas en estas opciones no necesitan ser parte de una operación implementada existente. Studio implementará y administrará automáticamente estos componentes cuando se seleccionen.
Información detallada sobre fragmentación
La fragmentación se utiliza para dividir los datos de origen en múltiples fragmentos (lotes) según el tamaño de fragmento configurado. El tamaño del fragmento es la cantidad de registros de origen (nodos) para cada fragmento. La transformación se realiza entonces en cada fragmento por separado, y cada fragmento de origen produce un fragmento de destino. Los fragmentos de destino resultantes se combinan para producir el destino final.
La fragmentación se puede utilizar solo si los registros son independientes y provienen de una fuente que no sea LDAP. Se recomienda utilizar el tamaño de fragmento más grande posible, asegurándose de que los datos de un fragmento quepan en la memoria disponible. Para conocer métodos adicionales para limitar la cantidad de memoria que utiliza una transformación, consulta Procesamiento de transformaciones.
Advertencia
El uso de fragmentación afecta el comportamiento de las variables globales y de proyecto. Consulta Usar variables con fragmentación a continuación.
Limitaciones de API
Muchas API de servicios web (SOAP/REST) tienen limitaciones de tamaño. Por ejemplo, un upsert basado en Salesforce acepta solo 200 registros por cada llamada. Con suficiente memoria, se puede configurar una operación para usar un tamaño de fragmento de 200. La fuente se dividiría en fragmentos de 200 registros cada uno, y cada transformación llamaría al servicio web una vez con un fragmento de 200 registros. Esto se repetiría hasta que se hayan procesado todos los registros. Los archivos de destino resultantes se combinarían entonces. (Ten en cuenta que también podrías usar actividades de carga masiva basadas en Salesforce para evitar el uso de fragmentación.)
Procesamiento paralelo
Si tienes una fuente grande y una computadora con múltiples CPU, la fragmentación se puede usar para dividir la fuente para procesamiento paralelo. Como cada fragmento se procesa de forma aislada, varios fragmentos se pueden procesar en paralelo. Esto aplica solo si los registros de la fuente son independientes entre sí a nivel de nodo de fragmento. Los servicios web se pueden llamar en paralelo usando fragmentación, mejorando el rendimiento.
Cuando uses fragmentación en una operación donde el destino es una base de datos, ten en cuenta que los datos de destino se escriben primero en numerosos archivos temporales (uno para cada fragmento). Estos archivos se combinan entonces en un archivo de destino, que se envía a la base de datos para inserción/actualización. Si estableces la variable de Jitterbit jitterbit.target.db.commit_chunks en 1 o true cuando la fragmentación está habilitada, cada fragmento se confirma en la base de datos conforme esté disponible. Esto puede mejorar significativamente el rendimiento ya que las inserciones/actualizaciones de la base de datos se realizan en paralelo.
Usar variables con fragmentación
Como la fragmentación puede invocar multihilo, su uso puede afectar el comportamiento de variables que no se comparten entre los hilos.
Las variables globales y las variables de proyecto se segregan entre las instancias de fragmentación, y aunque los datos se combinan, los cambios a estas variables no. Solo se preservan los cambios realizados en el hilo inicial al final de la transformación.
Por ejemplo, si una operación —con fragmentación y múltiples hilos— tiene una transformación que cambia una variable global, el valor de la variable global después de que termina la operación es el del primer hilo. Cualquier cambio a la variable en otros hilos es independiente y se descarta cuando se completa la operación.
Estas variables globales se pasan a los otros hilos por valor en lugar de por referencia, asegurando que cualquier cambio a las variables no se refleje en otros hilos u operaciones. Esto es similar a la función RunOperation cuando está en modo asincrónico.