Solución de problemas en Jitterbit Harmony
Esta guía cubre problemas comunes de solución de problemas en toda la plataforma unificada de Harmony (integración, automatización, gestión de API, EDI y desarrollo de aplicaciones), organizados por capacidad para que encuentres y resuelvas problemas donde sea que surjan. Expande la lista a continuación para revisar todas las entradas en esta página, o utiliza la función de búsqueda de tu navegador Control + F (Windows o Linux) o Command + F (macOS) para buscar un mensaje de error específico o síntoma.
Todas las entradas de solución de problemas en esta página
-
Administración de la plataforma
- No se puede iniciar sesión en Harmony
- Cuenta bloqueada después de intentos fallidos de inicio de sesión
- El usuario no puede acceder a un entorno o sus funciones
- Las variables del proyecto no se transfieren durante la promoción de entornos
- Cambiar el grupo de agentes de un entorno falla con un error de versión mínima de agente
- Design Studio: Los usuarios de SSO fuera de la región de la organización no pueden iniciar sesión
- La prueba de configuración de SSO bloquea la cuenta del proveedor de identidades
- La política de lista de IP permitidas bloquea a un administrador
- Cambiar el subdominio de API rompe las integraciones de API existentes
- El acceso del usuario externo al Portal de API caduca en un momento inesperado
- Los cambios de entorno no se reflejan en las aplicaciones de Harmony
- La configuración de SSO requiere clientes WMC y Studio
- Lista de omisión de SSO: Los miembros de la organización existentes no se pueden agregar directamente
- No se puede habilitar SSO: El usuario pertenece a varias organizaciones
- El inicio de sesión SSO se redirige en un bucle sin error
- La eliminación del almacenamiento de Cloud Datastore falla con error "no se puede excluir"
- La caducidad del token de actualización de OAuth causa falla en las operaciones conectadas
- API de registro de auditoría: la recuperación de tokens falla cuando TFA está habilitado
- Agregar un usuario externo falla con un error
409 conflict - No se puede cambiar la región de la organización en el mismo lugar
-
- Operaciones atrapadas en estado Enviado o En ejecución
- Las operaciones programadas no se ejecutan
- El diccionario o la variable global está vacío después de que una operación se ejecuta de forma asincrónica
- 504 Gateway Timeout (operaciones activadas por API)
- 507 Almacenamiento insuficiente
- 502 Bad Gateway
- Fallo al crear directorio temporal
- Mensajes del registro de operación truncados aproximadamente en 100 KB
- El registro de depuración de operación expone PII y credenciales en texto plano
- Fallo de conexión a la base de datos del agente privado
- El certificado de cliente falla al cargar en agentes privados de Linux
- Errores de validación de operación
- Los nombres de componente deben ser únicos después de importar el proyecto
- El conector solo para agente privado bloquea la importación en un entorno de agente en la nube
- Nodo de bucle de destino asignado a múltiples nodos de bucle de origen
- Propiedades de configuraciones avanzadas: Variables que contienen JSON sin procesar deben escaparse
- Elementos XML no compatibles (CDATA) incrustados en JSON
- La transformación falla cuando un valor de cadena JSON excede la longitud máxima
- Caracteres especiales en esquemas JSON proporcionados por el conector
- Los caracteres multibyte se corrompen en una respuesta de conector grande
- Esquemas duplicados con grupos de sustitución
- La importación de un mapeo de transformación con nodos duplicados falla con "no se puede crear el nodo"
- Advertencia de subelemento adicional en registros de operación
- Límite de iteración de bucle de secuencia de comandos excedido
RunOperationdeja de ejecutarse después de 50 llamadas síncronas en un bucleWhile- Comparar una cadena con un número produce resultados inesperados
- Reprocesamiento de esquema XML reflejado en proyectos creados antes de la versión 10.25
- Salida de transformación convertida a 0 para campos de destino con tipo de dato
double - Campos asignados en blanco con esquemas de origen planos
- Funciones de archivo: La operación continúa después de un error en
ArchiveFileoReadFile ReadFile: Lecturas parciales con contenido de archivo binario- El contenido de
ReadFilecon bytes no UTF-8 falla cuando se asigna a una carga XML o JSON UTF-8 FlushFile/FlushAllFiles: Error cuando el archivo de destino ya existeDeleteFiles: Error cuando no se puede encontrar la ruta de origenGetJSONString: Ejecución interrumpida en ruta no válidaUnmapno desmapea un campo cuando se usa junto conRunScriptDBExecute: Error cuandoauto_commitytransactionson ambostrueCallStoredProcedure:resultSetsiempre nulo con controladores ODBCCallStoredProcedure: "No se encontró el procedimiento almacenado o función" con PostgreSQL JDBCDBLoad: Requiere un controlador de base de datos JDBCAESDecryptionfalla con datos encriptados en OpenSSL 3- Actualizaciones de variables perdidas en operaciones multihilo fragmentadas
- La transformación elimina registros duplicados cuando la salida es jerárquica
- Los identificadores numéricos largos se corrompen en la salida de transformación
- La salida de transformación JSON omite campos
nully de cadena vacía - Los campos mapeados vacíos se convierten en
xsi:nil="true"e invalidan una solicitud XML o SOAP - La marca de orden de bytes (BOM) en un archivo de origen se transmite al valor del primer registro
- Las variables de proyecto devuelven valores vacíos durante las pruebas de secuencias de comandos y transformaciones
- Una función falla cuando el campo de conexión de su punto de conexión se establece en una variable
IsNulldevuelve false para cadenas vacías de datos de origen JSON- Comparar una variable de cadena con el número
0devuelve inesperadamentetrue - La aritmética decimal produce resultados inesperados de punto flotante
- Las funciones de fecha devuelven medianoche en lugar de un valor de solo fecha
- El valor en caché expira más pronto de lo esperado
RunXSLTfalla con "XML version must be 1.0 or 1.1"SelectSingleNodedevuelve el nodo incorrecto cuando se utiliza con un elemento de matrizSelectNodes- La salida de
HexToBinaryaparece sin cambios cuando se registra SortArrayordena nombres de archivos lexicográficamente, no cronológicamenteURLEncodeno codifica ciertos caracteres "seguros" o multibyte- JavaScript: error "Call to Jitterbit Tomcat failed"
- JavaScript: cambios de variable global perdidos en caso de fallo de secuencia de comandos
- JavaScript:
GetVardevuelve null para variables de proyecto definidas por el usuario - Cargar un archivo de esquema lo reemplaza en todo el proyecto
- La implementación de una plantilla de proceso de Marketplace falla debido a una falta de coincidencia de esquema
- Studio se vuelve lento o no responde con proyectos muy grandes
- Amazon Bedrock: error de modelo "on-demand throughput isn't supported"
- Cloud Datastore: La actividad Query Items no devuelve todos los registros coincidentes al filtrar por múltiples valores del mismo campo
- Cloud Datastore: La actividad Delete Items reporta éxito pero no elimina el registro
- Coupa: La autenticación por clave API devuelve 403 Forbidden
- Base de datos (JDBC):
DBLookupoDBExecutefalla con un error de decodificación Base64 - Base de datos (ODBC): Los caracteres multibyte no se manejan correctamente
- Base de datos: La conexión está bloqueada por la política de seguridad
- Base de datos: Los tiempos de espera de conexión se agotan bajo carga
- Base de datos: Errores de longitud de campo en Insert, Update o Upsert
- Base de datos: El archivo JAR del controlador JDBC se sobrescribe al actualizar el agente
- Base de datos: Los caracteres especiales en nombres de columnas causan fallos en consultas
- Base de datos: La sentencia SQL excede el límite de 2,000 caracteres
- IBM DB2 en iSeries: La conexión JDBC falla
- IBM DB2: Configuración del controlador JDBC JCC (archivo JAR y licencia obsoletos)
- Kerberos: "No se pudo inicializar la clase KerbAuthentication"
- Kerberos: Errores JGSS o GSS durante la prueba de conexión
- Microsoft Excel: "La operación debe usar una consulta actualizable"
- MySQL: Acceso denegado a pesar de credenciales correctas
- MySQL: Habilitar Batch no mejora el rendimiento de Insert o Update
- MySQL: El controlador ODBC no aparece en el menú desplegable de Studio
- PostgreSQL: Error de discordancia de codificación de cliente
- PostgreSQL: Usar el controlador proporcionado por Jitterbit en Linux
- SQL Server JDBC: La autenticación integrada de Windows falla
- Autenticación de Windows de SQL Server: Privilegios insuficientes
- SQL Server: "Cannot insert explicit value for identity column" al insertar en una columna de identidad
- SQL Server: La conexión falla con un error de ruta de certificado PKIX
- Correo electrónico: Enviar correo falla cuando la misma dirección aparece en múltiples campos de destinatarios
- Correo electrónico: La prueba de conexión de Gmail falla con error de autenticación
- Correo electrónico: La firma S/MIME falla o es rechazada por proveedores de correo en la nube
- Correo electrónico: La autenticación de Microsoft 365 (ROPC) falla cuando MFA está habilitado
- Epicor Prophet 21: La operación falla en tiempo de ejecución con múltiples condiciones de filtro
- FTP, Recurso compartido de archivos y Almacenamiento local: "Ningún archivo coincide con el filtro de archivo" en pasos de archivo o seguimiento
- FTP, Recurso compartido de archivos y Almacenamiento local: Carpeta de error no escrita al fallar la conexión
- FTP, Recurso compartido de archivos y Almacenamiento local: Palabras clave de nombre de archivo no resueltas en rutas de carpeta de éxito y error
- FTP, Recurso compartido de archivos, Almacenamiento local y Almacenamiento temporal: Escribir encabezados no produce un archivo solo de encabezado cuando el origen no devuelve registros
- FTP: La operación falla después de muchos inicios de sesión rápidos en el mismo servidor
- SFTP "Acceso denegado. Error de autenticación." al usar claves SSH
- Escritura FTP: "Usar cambio de nombre FTP" falla al escribir en un servidor SFTP
- SFTP: Anexar a archivo no es compatible
- FTP: Los nombres de archivo que contienen
#no se manejan correctamente - Recurso compartido de archivos: Las rutas UNC con nombres de servidor fallan en agentes en la nube
- Recurso compartido de archivos: Los archivos mayores a 2 GB pueden fallar al recuperarse
- Almacenamiento local: No disponible en agentes en la nube
- Almacenamiento temporal: Archivos faltantes cuando se leen en una operación posterior
- Almacenamiento temporal: Caracteres restringidos en rutas de archivos
- Almacenamiento temporal: Límite de tamaño de archivo de 50 GB en agentes en la nube
- HTTP v2: Espacios codificados como
+en lugar de%20 - HTTP v2: Código de estado de respuesta no disponible en variables de Jitterbit
- HTTP v2: Espacios de nombres XML reescritos al usar un esquema de solicitud personalizado
- HTTP v2: Encabezado de autorización duplicado causa error 400 Bad Request
- HTTP v2: Valor JSON en una variable de encabezado de solicitud falla al analizarse
- HTTP y HTTP v2: URL contiene múltiples caracteres
? - HTTP v2: Codificación de URL doble cuando "Codificar URL de solicitud" está habilitado
- HTTP v2: La operación falla cuando la URL base se redirige
- HTTP v2: Las variables en la ruta de la actividad no se resuelven
- HTTP: Envía
nullcomo la cadena"null" - LDAP Delete Entry falla cuando la entrada de destino tiene entradas secundarias
- LDAP Search Entry: La expresión de filtro distingue mayúsculas de minúsculas en algunos servidores
- Microsoft SharePoint Online: Conexiones de esquema SOAP fallando después del retiro de IDCRL
- Microsoft Dynamics 365 Business Central v2: Nombres de tipo incompatibles con metadatos
- Microsoft Entra ID: Atributos de extensión no seleccionables como condiciones de filtro de consulta
- Actividad de actualización de Microsoft Entra ID: Campos DateTime rechazados con error de tipo
Edm.String - Consulta de Microsoft Entra ID: "Cláusula de filtro de consulta no compatible o no válida" en propiedades filtradas
- Las operaciones de Microsoft Dynamics AX 2012 fallan con "Logon failed"
- NetSuite: Error de URL del centro de datos
- NetSuite:
INSUFFICIENT_PERMISSIONa pesar de que la prueba de conexión fue exitosa - NetSuite: La conexión de sandbox falla después de actualizar el sandbox
- NetSuite: Los campos personalizados no aparecen en el esquema de actividad
- NetSuite: Los segmentos personalizados no aparecen o no son compatibles en búsquedas avanzadas
- NetSuite: Los campos de cuerpo personalizados no son visibles debido a permisos de rol faltantes
- NetSuite: Las búsquedas guardadas no aparecen en el menú desplegable
- NetSuite: El botón Prueba de consulta de búsqueda expandida está deshabilitado
- NetSuite: Faltan campos de fórmula de búsqueda guardada en la salida de actividad
- NetSuite: Error de análisis en Prueba de consulta cuando el filtro usa una variable de proyecto
- NetSuite: Búsqueda guardada con campos de resultado como salida requiere agente 11.49 o posterior
- NetSuite: La actividad Update devuelve
INVALID_KEY_OR_REFcuando el XML de origen pierdeinternalId - NetSuite: Las operaciones fallan debido a límites de registros de API
- NetSuite: Se superó el límite de solicitudes concurrentes
- NetSuite: Las operaciones fallan después de actualizar la URL de WSDL
- NetSuite Create, Update u Upsert falla con "no es un valor válido para Country"
- Los conjuntos de entidades de OData v2 no se cargan con "No entity sets found"
- OData: Microsoft Dynamics 365 devuelve solo los datos de la empresa predeterminada
- Oracle EBS: Error de conexión "el archivo JAR del proveedor personalizado no está presente"
- Salesforce: Las operaciones fallan debido a límites de registros de API
- Salesforce, Service Cloud y ServiceMax: La autenticación multifactor impide conexiones de autenticación básica
- Certificado de Salesforce: Falta de coincidencia del Nombre Alternativo del Sujeto (SAN)
- Conexión, configuración u operación de Salesforce falla intermitentemente con
SERVER_UNAVAILABLE - Salesforce: El esquema de datos no incluye campos agregados recientemente
- Salesforce: El mapeo automático no asigna campos cuando una actividad de Salesforce es el destino
- Actividad de consulta de Salesforce: La consulta padre-hijo genera esquema jerárquico
- Salesforce: La operación de actualización masiva falla para algunos registros (ID externo duplicado)
- Actividad de inserción o actualización de Salesforce: El campo de ID de registro no se puede asignar
- Actividades de escritura masiva de Salesforce: Se omite el primer registro de datos cuando el origen no tiene fila de encabezado
- Los pasos de operación de actividad masiva de Salesforce se muestran como "Incompleto" sin datos de entrada o salida
- Las actividades masivas de Salesforce fallan cuando se activan mediante una solicitud de API o SOAP
- Eventos de Salesforce: Los eventos no se pueden habilitar después del reinicio del agente
- Eventos de Salesforce: Limitaciones de actividad de escucha
- Múltiples actividades de SAP en una operación fallan en tiempo de ejecución
- SAP RFC: "Sin autorización de RFC para el módulo de función BAPI_TRANSACTION_COMMIT"
- Conexión a SAP falla con "Clave de idioma inválida"
- ServiceNow: Las primeras ejecuciones de operaciones son lentas después del reinicio del agente o en agentes en la nube
- ServiceNow v2: Un objeto no se enumera por su nombre de conector de ServiceNow
- Shopify: Las selecciones del objeto Activity pueden cambiar después de una actualización de versión de API
- Snowflake: Error de espacio de memoria Java al consultar grandes volúmenes de datos
- Snowflake: Las operaciones fallan en el agente 12.x
- Snowflake: Las conexiones basadas en contraseña fallan después de la deprecación de autenticación
- Snowflake: La instancia de desarrollador está durmiendo, las tablas de metadatos no se están completando
- Snowflake Query: La falta de coincidencia de mayúsculas en el nodo raíz del esquema plano genera error de
ProcessFlatStream - Snowflake Merge:
stageNameyfileContentfaltan en el esquema de solicitud para etapas externas - Snowflake Insert o Merge: Errores de sintaxis SQL causados por caracteres especiales
- Error de implementación SOAP: "No WSDL with locator"
- SOAP WSDL: schemaLocation debe utilizar referencias relativas
- El conector SOAP reescribe los prefijos y la estructura del espacio de nombres XML
- SOAP: Los mensajes MTOM/XOP no son compatibles
- VTEX: La prueba de conexión falla con "You don't have permission to access this resource"
- Workday: WSDL v42.0 y v42.1 devuelven errores para servicios específicos
- Workday: La prueba de conexión falla con "The task submitted is not authorized"
- Chunking requiere un conector nativo como origen
- Agente desconectado o inaccesible
- El agente muestra diferentes versiones o direcciones IP
- Falla de sincronización del agente: Los cambios del proyecto no se aplican
- Error 1722 en la instalación de Windows
- Servicio PostgreSQL eliminado después de una actualización fallida en Windows
- Los servicios del agente no inician después de reiniciar Windows después de una actualización
- TFA impide la instalación del agente Windows de 64 bits
- Instalación en Linux sin privilegios falla
- Controlador JDBC: "No suitable driver found"
- Espacio de memoria Java:
OutOfMemoryError - Espacio en disco y acumulación de registros
- Fallos de conexión
TranDb - PostgreSQL: Apagado rápido administrativo
- Fallo de protocolo de enlace de certificado (TLS)
- FTP: Tiempo de espera de conexión de datos agotado
- Problema de IPv6 en Windows
- Máquina virtual de Azure: Pérdida de conexiones y errores de WebSocket/E/S
- Apache: Sin
ConfigArgsinstalado - Apache/Tomcat:
APPARENT DEADLOCK - Apache falla inesperadamente bajo carga concurrente
- El servicio de limpieza no puede eliminar archivos de registro bloqueados en Windows
- El agente no se reinicia con errores de autenticación después de la cancelación del registro
- El cambio de registro en la nube requiere reinicio del agente privado
- No se permite agregar un segundo agente a un grupo de agentes estándar
- Agregar un agente privado falla con un error de límite máximo de agentes
- No se puede eliminar el agente privado
- No se puede eliminar el grupo de agentes privados
- Inhabilitar actualización automática de conectores omitida por acciones del agente
- El agente muestra Desconocido o Detenido después de reutilizar un grupo de agentes en sistemas operativos
- Operaciones retrasadas o en cola después de implementar un proyecto
- El agente aparece como incapaz
- Transformación falla: "No se pudo encontrar el archivo en el almacén de archivos local"
- Recuperar una instalación de Windows fallida
- Conector no descargado al agente
- La instalación del agente no puede registrarse a través de un proxy corporativo
- Bucle de reinicio del servicio del agente
- Operaciones que agotan el tiempo o ignoran la configuración de tiempo de espera
- El rendimiento del agente no cambia después de aumentar
max.concurrent.requests - Desaceleración de transformación XML después de actualizar al agente 11.45 o posterior
- Los archivos de mini-volcado de JVM llenan el disco del agente
- PostgreSQL incluido en Linux utiliza MD5 en lugar de SCRAM-SHA-256
- La conexión de sandbox de Salesforce falla con error de coincidencia de certificado
- SSH: La conexión SFTP falla debido a una ruta de archivo de clave incorrecta
- Configuración SFTP SSH faltante o en la sección
jitterbit.confincorrecta - Falla de autenticación SFTP en un servidor específico (error de coincidencia de cifra de cURL)
- Proxy HTTPS: Falla de autenticación básica a través del túnel proxy
- Agentes privados en redes restringidas: Conectividad solo saliente
- API personalizada devuelve 504 pero el registro de operaciones muestra éxito
- La observabilidad nativa no muestra datos
- Métricas del agente faltantes cuando el agente se conecta a través de un proxy HTTP
- El agente de Datadog falla al iniciarse después de la instalación de Docker
- Linux: Los servicios del agente no se inician después de un reinicio ("postmaster.pid no existe")
- Linux: El antivirus elimina PgBouncer, el agente falla al autenticarse en la base de datos incluida
- Los escaneos de seguridad marcan
log4j-over-slf4j.jarcomo una vulnerabilidad de Log4j 1.x - Servicio de escucha "El clúster no ha alcanzado el tamaño mínimo requerido"
- Mensajes del servicio de escucha no entregados
- Registros de operación de API personalizada no aparecen
- El registro de depuración de operación se detiene antes de la fecha de finalización seleccionada
- Archivos de registro de depuración de operación sin datos
.inputo.output - Datos de entrada/salida del componente no generados
- Jitterbit MQ: Mensajes de cola de quórum descartados silenciosamente después de 20 intentos NACK
- Jitterbit MQ: Entorno no habilitado para mensajería
- Jitterbit MQ: El límite de mensajes excedido causa "Error al enviar mensaje"
- Jitterbit MQ: Los mensajes NACK bloquean el progreso de la cola cuando se vuelven a encolar
- Inicio de sesión de Design Studio: error de certificado SSL o filtro proxy
- Design Studio marcado como software malicioso en macOS Sequoia
- Design Studio: interfaz borrosa o pequeña en pantallas de alta densidad de Windows 10
- Design Studio: tiempo de carga de proyecto largo al usar un proxy
- Design Studio macOS: error "Client Properties Do Not Exist" al iniciar
- Design Studio: la transformación con un script falla con error "/PRESCRIPT/ node"
- No se recomienda almacenar proyectos de Design Studio en un recurso compartido de archivos de red
- Design Studio: descarga de proyecto falla con error
Invalid XML character - Design Studio: componentes de proyecto faltantes después de descargar o importar
- Design Studio: operaciones o transformaciones duplicadas aparecen en un proyecto descargado
- Design Studio: importación de proyecto Salesforce falla con requisito de versión incorrecto
- Design Studio: fallo SOAP no se implementa cuando se configura para activar un correo electrónico directamente
- Design Studio: transferencias de archivos se repiten inesperadamente
- Design Studio: modo pasivo FTP y restricciones de firewall de puerto alto
- Design Studio: las rutas de carpeta de éxito y error de FTP están en el agente, no en el servidor FTP
- Design Studio: no se puede analizar el listado de directorios FTP
- Design Studio: el objetivo FTP Usar cambio de nombre FTP no es funcional con operaciones de archivo SFTP
- Design Studio: el objetivo FTP Crear directorios automáticamente no es confiable
- Design Studio: archivos individuales de origen de recurso compartido de archivos mayores de 2 GB no se pueden recuperar
- Design Studio: prueba de conexión de origen HTTP falla aunque el extremo sea accesible
- Design Studio: error de URL del centro de datos de NetSuite, usar URL WSDL específica de cuenta
- Design Studio: usuarios de TFA de NetSuite no deben usar tipo de autenticación SSO
- Design Studio: error de NetSuite TBA
INSUFFICIENT_PERMISSIONen tiempo de ejecución a pesar de que la prueba de conexión fue exitosa - Design Studio: la lista desplegable de búsqueda guardada de NetSuite está vacía cuando el objeto tiene más de 1,000 búsquedas guardadas
- Design Studio: no se pueden pasar valores NULL o en blanco de NetSuite a campos personalizados
- Design Studio: segmentos personalizados de NetSuite no mostrados en la configuración de actividades
- Design Studio: es posible que los cambios de conexión OAuth 2.0 de Salesforce no se conserven antes de probar o implementar
- Design Studio: no se encuentran IDocs de SAP cuando una operación programada se ejecuta en un agente diferente
- Design Studio: los envíos masivos de IDoc de SAP pueden exceder los límites de conexión del punto final de destino
- Design Studio: carga útil de IDoc de SAP perdida cuando el punto final de destino es inaccesible
- Design Studio: archivos temporales de almacenamiento y reenvío de IDoc de SAP eliminados después de 24 horas
- Design Studio: la operación BAPI de SAP se realiza correctamente pero la transacción no se confirma
- Design Studio: el Escuchador de Eventos de SAP no detecta iDocs en Windows
-
- No se puede publicar una API: se alcanzó el límite de API de suscripción
- La API publicada devuelve 404 No encontrado
- HTTP 504 Tiempo de espera de puerta de enlace
- Portal de API que no refleja cambios del proyecto
- Microsoft Entra ID OAuth: el nombre del perfil de seguridad no puede contener espacios
- Microsoft Entra ID OAuth de 2 tramos: error
OAUTH_INVALID_TOKEN_CODE - Se ha retirado la API de Azure AD Graph
- Proveedor de identidad de Google o Salesforce: OAuth de 2 tramos no es compatible
- Microsoft Copilot Studio: autenticación básica no compatible
- Botón "Nueva API" no visible a pesar de tener el rol correcto en la organización
- Autenticación básica: una credencial en caché de una solicitud anterior afecta una llamada de API posterior
- Error
INVALID_TRIGGER_USERoTRIGGER_USER_TOO_LONG - 401 No autorizado con una lista de direcciones IP permitidas válida (caché obsoleta)
- Salesforce en Hyperforce: Las llamadas a una API se rechazan después de que cambian las direcciones IP de Salesforce
- URL del servicio excede la longitud máxima (HTTP 414)
- API de proxy: los parámetros de ruta del servicio requieren un documento OpenAPI
- No se puede eliminar una API en API Manager
- El entorno de API no se puede cambiar después de la creación
- CORS habilitado: las solicitudes
OPTIONSse ejecutan sin autenticación - API de proxy en la nube: la API de destino debe ser públicamente accesible
- La configuración Mostrar cargas útiles de solicitud y respuesta no tiene efecto en las API de proxy
- La puerta de enlace privada devuelve una página 400 "verificar Servicios de Jitterbit" sin entrada de registro de API
- Los cambios de perfil de seguridad tardan varios minutos en surtir efecto
- Eliminar una API no actualiza la documentación del Portal de API
- No se puede eliminar el perfil de seguridad mientras sigue asignado a una API publicada
- OAuth de 2 patas recurre a 3 patas en versiones de puerta de enlace privada anteriores a 10.48
- ALB de múltiples puertas de enlace: todos los contenedores deben estar en el mismo host
- Puerta de enlace privada: la configuración de SSL personalizada se sobrescribe con las actualizaciones
- La puerta de enlace privada devuelve HTTP 507 o "No such file or directory"
- La instalación o actualización de la puerta de enlace privada falla con dependencias faltantes
- La autoprueba de la puerta de enlace privada devuelve "Failure, test call to API failed"
- OData $count o $inlinecount devuelve un error cuando no hay registros coincidentes
- API de proxy: guiones en encabezados de solicitud reemplazados por guiones bajos
- Los registros de operación no son visibles para operaciones activadas por API cuando el modo de depuración está desactivado
- Carga útil de API disponible en el agente durante 2 días
- La página de API Logs retiene selecciones de filtros anteriores
- Las APIs no publicadas no aparecen en el menú desplegable Analytics APIs
- Error 429: Se superó el límite de llamadas mensuales a la API
- Error 429: La IP del consumidor no está en el rango de IPs de confianza
- Límite de velocidad a nivel de plataforma: 200 solicitudes por minuto
- Zscaler o firewall de intercepción SSL bloquea el acceso a la API
-
- Falla de conexión AS2 o certificado
- Falla de conexión FTP o SFTP
- Problemas de conectividad VAN
- Documento rechazado: datos inválidos o faltantes
- Error de mapeo EDI o esquema
- Identificadores de socio comercial incorrectos
- Confirmaciones no configuradas o no recibidas
- AS2: El firewall del socio comercial debe incluir en la lista de permitidos las direcciones IP de Jitterbit
- La verificación de duplicados no se aplica al formato EDIXml o XCBL
- La actividad EDI for Cloud v2 falla en un agente privado detrás de un firewall o proxy
- El token de acceso EDI desactivado causa error
INVALID_TOKEN - Error de transformación: campo no reconocido en actividad EDI
- El segmento EDI repetido o mapa de bucle mapea solo la última iteración
- Adición de niveles de bucles jerárquicos anidados (HL) a una transformación EDI
- Los valores de invalidación de ID de EDI no se aplican a transacciones salientes
- No se puede eliminar una conexión de comunicación asignada
- El "Próximo tiempo de ejecución" de FTP no se actualiza sin actualizar la página
- Falla de adición de ID de EDI o ID preferido: ID ya en uso
- Los documentos salientes pasan validación local pero fallan en pruebas del socio comercial
- Transacción archivada antes o después de lo esperado
- No se puede acceder a funciones EDI
- No se pueden habilitar configuraciones de PII
-
- App Builder falla al iniciar con un error 500
- App Builder falla al iniciar con un error HTTP 500.30
- App Builder devuelve un error HTTP 503
- App Builder se inicia pero no crea bases de datos
- Ocurre un error al cargar la información de conexión de la base de datos
- App Builder se carga con estilos faltantes o rotos
- La carga de licencia falla
- App Builder no se inicia automáticamente después de reiniciar el servidor
- Implementación de Docker: No se puede cargar la licencia de App Builder 4.x en la interfaz de usuario
- Alta disponibilidad: Todas las instancias deben usar el mismo
appsettings.json - El inicio de sesión de SSO falla o redirige a una URL incorrecta
- La URL base no redirige a la página de inicio de sesión
- Los usuarios locales no pueden restablecer una contraseña olvidada
- App Builder es lento o no responde
- La autenticación OAuth de Salesforce falla o autentica con la instancia incorrecta
- Los valores de columna cifrada aparecen en blanco después de reconfigurar la fuente de datos
- El registro de auditoría no se completa la línea base
- Sistema de archivos de SharePoint: Autenticación OAuth requerida a partir de abril de 2026
- Sistema de archivos de SharePoint: Los archivos no se muestran o las rutas devuelven errores
- Conector de App Builder: No se puede recuperar la clave API generada después de salir de la pantalla
- Conector de App Builder: Error 403 Prohibido
- Webhook: La autenticación HTTP básica requiere el encabezado Authorization en la carga útil
- La migración de fechas agota el tiempo en conjuntos de datos grandes
- El servidor de aplicaciones de App Builder y el servidor de base de datos deben usar la misma zona horaria
- Errores de configuración de SMTP
- Los enlaces profundos dejan de funcionar después de renombrar una aplicación o página
- Un evento se ejecuta varias veces en guardar, insertar, actualizar o eliminar
- El usuario no puede acceder a las páginas o funciones esperadas
- El icono de auditoría no aparece en una página
- Aplicación sin conexión: La base de datos local se borra cuando se actualiza la aplicación
- Aplicación sin conexión: Los programas en segundo plano no se ejecutan cuando la aplicación está cerrada
- La aplicación móvil se congela, falla o tiene problemas de enlaces
- El widget no se activa o no carga correctamente
-
- No se puede publicar una API: Se alcanzó el límite de suscripción
- La API publicada devuelve 404 Not Found
- HTTP 504 Gateway Timeout
- El Portal de API no refleja los cambios del proyecto
- Microsoft Entra ID OAuth: El nombre del perfil de seguridad no puede contener espacios
- Microsoft Entra ID OAuth de 2 pasos: error
OAUTH_INVALID_TOKEN_CODE - Azure AD Graph API ha sido retirada
- Proveedor de identidad de Google o Salesforce: OAuth de 2 pasos no es compatible
- Microsoft Copilot Studio: Autenticación básica no compatible
- Botón "Nueva API" no visible a pesar de tener el rol correcto en la organización
- Autenticación básica: Una credencial en caché de una solicitud anterior afecta una llamada de API posterior
- Error
INVALID_TRIGGER_USERoTRIGGER_USER_TOO_LONG - 401 No autorizado con una lista de direcciones IP permitidas válida (caché obsoleto)
- Salesforce en Hyperforce: Las llamadas a una API se rechazan después de que cambien las direcciones IP de Salesforce
- La URL del servicio excede la longitud máxima (HTTP 414)
- API proxy: Los parámetros de ruta del servicio requieren un documento OpenAPI
- No se puede eliminar una API en API Manager
- El entorno de API no se puede cambiar después de la creación
- CORS habilitado: Las solicitudes
OPTIONSse ejecutan sin autenticación - API proxy en la nube: La API de destino debe ser accesible públicamente
- La configuración Mostrar cargas de solicitudes y respuestas no tiene efecto para las API proxy
- La puerta de enlace privada devuelve una página 400 "verify Jitterbit Services" sin entrada de registro de API
- Los cambios del perfil de seguridad tardan varios minutos en surtir efecto
- Eliminar una API no actualiza la documentación del Portal de API
- No se puede eliminar el perfil de seguridad mientras esté asignado a una API publicada
- OAuth de 2 pasos vuelve a OAuth de 3 pasos en versiones de puerta de enlace privada anteriores a la 10.48
- ALB de múltiples puertas de enlace: Todos los contenedores deben estar en el mismo host
- Puerta de enlace privada: La configuración de SSL personalizada es sobrescrita por las actualizaciones
- La puerta de enlace privada devuelve HTTP 507 o "No such file or directory"
- La instalación o actualización de la puerta de enlace privada falla con dependencias faltantes
- La autoprueba de la puerta de enlace privada devuelve "Failure, test call to API failed"
- OData $count o $inlinecount devuelven un error cuando no hay registros que coincidan
- API proxy: Los guiones en los encabezados de solicitud se reemplazan con guiones bajos
- Los registros de operación no son visibles para operaciones desencadenadas por API cuando el modo de depuración está desactivado
- La carga de API disponible en el agente durante 2 días
- La página Registros de API retiene las selecciones de filtro anteriores
- Las API no publicadas no aparecen en el menú desplegable de análisis de API
- Error 429: Se superó la asignación mensual de llamadas de API
- Error 429: IP del consumidor no dentro del rango de IP de confianza
- Límite de velocidad a nivel de plataforma: 200 solicitudes por minuto
- Zscaler o firewall con interceptación de SSL bloquea el acceso a la API
-
- Fallo de conexión o certificado AS2
- Fallo de conexión FTP o SFTP
- Problemas de conectividad de VAN
- Documento rechazado: Datos inválidos o faltantes
- Error de mapeo o esquema de EDI
- Identificadores de socio comercial incorrectos
- Confirmaciones no configuradas o no recibidas
- AS2: El firewall del socio comercial debe incluir en la lista de permitidos las direcciones IP de Jitterbit
- La verificación de transacciones duplicadas no se aplica al formato EDIXml o XCBL
- La actividad de EDI for Cloud v2 falla en un agente privado detrás de un firewall o proxy
- El token de acceso de EDI desactivado causa el error
INVALID_TOKEN - Error de transformación: Campo no reconocido en la actividad de EDI
- El segmento o bucle EDI repetido mapea solo la última iteración
- Agregar nivel de bucle jerárquico anidado (HL) a una transformación de EDI
- Los valores de anulación de ID de EDI no se aplican a las transacciones salientes
- No se puede eliminar una conexión de comunicación asignada
- FTP "Próxima hora de ejecución" no se actualiza sin actualizar la página
- La adición de ID de EDI o ID preferido falla: ID ya en uso
- Los documentos salientes pasan la validación local pero fallan en las pruebas del socio comercial
- Transacción archivada antes o después de lo esperado
- No se puede acceder a las funciones de EDI
- No se puede habilitar la configuración de PII
-
- App Builder falla al iniciarse con un error 500
- App Builder falla al iniciarse con un error HTTP 500.30
- App Builder devuelve un error HTTP 503
- App Builder se inicia pero no crea bases de datos
- Se produce un error al cargar la información de conexión de la base de datos
- App Builder se carga con estilos faltantes o rotos
- La carga de licencia falla
- App Builder no se inicia automáticamente después de reiniciar el servidor
- Implementación en Docker: No se puede cargar la licencia de App Builder 4.x en la interfaz de usuario
- Alta disponibilidad: Todas las instancias deben utilizar el mismo
appsettings.json - El inicio de sesión de SSO falla o redirige a una URL incorrecta
- La URL base no redirige a la página de inicio de sesión
- Los usuarios locales no pueden restablecer una contraseña olvidada
- App Builder es lento o no responde
- La autenticación OAuth de Salesforce falla o se autentica con la instancia incorrecta
- Los valores de columna cifrada aparecen en blanco después de reconfigurar la fuente de datos
- El registro de auditoría no se completa
- Sistema de archivos de SharePoint: Se requiere autenticación OAuth a partir de abril de 2026
- Sistema de archivos de SharePoint: Los archivos no se muestran o las rutas devuelven errores
- Conector de App Builder: No se puede recuperar la clave de API generada después de salir de la pantalla
- Conector de App Builder: Error 403 Prohibido
- Webhook: La autenticación básica HTTP requiere el encabezado Authorization en la carga
- La migración de datos expira en conjuntos de datos grandes
- El servidor de aplicaciones de App Builder y el servidor de base de datos deben utilizar la misma zona horaria
- Errores de configuración de SMTP
- Los vínculos profundos dejan de funcionar después de cambiar el nombre de una aplicación o página
- Un evento se dispara múltiples veces al guardar, insertar, actualizar o eliminar
- El usuario no puede acceder a las páginas o funciones esperadas
- El icono de auditoría no aparece en una página
- Aplicación sin conexión: La base de datos local se borra cuando se actualiza la aplicación
- Aplicación sin conexión: Los cronogramas en segundo plano no se ejecutan cuando la aplicación está cerrada
- La aplicación móvil se congela, falla o tiene problemas de vínculos
- El widget no se activa o no se carga correctamente
Pasos de diagnóstico
Verificar los registros de operaciones
En la Consola de administración, abre la página Runtime y revisa la entrada de registro de la operación afectada. El estado y cualquier mensaje de registro son el indicador principal de la causa. La página Runtime enumera todas las operaciones, incluidas las ejecutadas directamente y las activadas por una API (mostradas en la columna Log Type como Custom API, Proxy API u OData API), por lo que es el lugar para comenzar la mayoría de los problemas en tiempo de ejecución.
Verificar los registros de API
Para obtener detalles específicos de la API, abre la página API Logs en API Manager. Muestra los datos de solicitud y respuesta de cada llamada API (código de estado HTTP, tiempo de respuesta, URI de solicitud, IP de origen) y, cuando está habilitada, rastros de depuración y detallados. Los registros de operaciones de operaciones activadas por API también aparecen aquí, junto con la página Runtime.
Verificar los registros del agente
Para los entornos que se ejecutan en agentes privados, revisa los archivos de registro del agente para detectar errores de conectividad, recursos y sincronización. Consulta registros de agente para conocer las ubicaciones de los archivos.
Verificar el estado del sistema Harmony
Si un problema parece afectar todas las operaciones o todas las APIs en lugar de un flujo de trabajo único, consulta trust.jitterbit.com y la página de problemas conocidos antes de investigar más.
Administración de la plataforma
Esta sección cubre problemas a nivel de plataforma Harmony: autenticación, gestión de usuarios y entornos, e implementación de proyectos.
No se puede iniciar sesión en Harmony
- Síntoma: Los usuarios no pueden iniciar sesión en el portal Harmony.
- Resolución:
- Consulta trust.jitterbit.com para verificar si hay interrupciones activas de la plataforma.
- Borra la memoria caché y las cookies del navegador, luego reinténtalo, o utiliza una ventana de incógnito o privada o un navegador diferente. Los datos de sesión en caché pueden hacer que el portal vuelva a la página de inicio de sesión o no se cargue después de iniciar sesión.
- Si SSO está configurado, pide a un administrador que verifique la configuración de SSO. Consulta Harmony SSO.
- Confirma que la cuenta del usuario esté activa y no haya sido desactivada en la página Gestión de usuarios de la Consola de administración.
- Si el inicio de sesión sigue fallando después de estas verificaciones (por ejemplo, un restablecimiento de contraseña no se completa o la cuenta se muestra como inactiva a pesar de estar activa), ponte en contacto con soporte de Jitterbit.
Cuenta bloqueada después de intentos fallidos de inicio de sesión
- Síntoma: Un usuario no puede iniciar sesión después de ingresar credenciales incorrectas. Su estado en la página Gestión de usuarios de la Consola de administración se muestra como Inactivo.
- Causa posible: Después de 5 intentos fallidos consecutivos de inicio de sesión, la cuenta se bloquea durante 30 minutos.
- Resolución:
- Espera 30 minutos e intenta de nuevo con las credenciales correctas.
- Alternativamente, utiliza el enlace Olvidé mi contraseña en la página de inicio de sesión del portal Harmony para restablecer la contraseña y desbloquear inmediatamente la cuenta.
El usuario no puede acceder a un entorno o sus funciones
- Síntoma: Un usuario puede iniciar sesión pero no ve un entorno, no puede implementar en él o le faltan funciones esperadas.
- Causa posible: El acceso al entorno está controlado por los roles asignados al usuario.
- Resolución: Un administrador debe otorgar al rol del usuario el acceso al entorno apropiado en la Consola de administración. Verifica los roles asignados al usuario y los permisos otorgados a esos roles.
Las variables del proyecto no se transfieren durante la promoción de entornos
- Síntoma: Después de transferir un proyecto a otro entorno, faltan algunos valores de variables del proyecto en el destino o no son los valores esperados.
- Causa posible: Si el valor de una variable del proyecto se transfiere depende de la opción de transferencia utilizada y su configuración de variable:
- En una transferencia completa de proyecto (el diálogo Migrar), la primera transferencia utiliza por defecto Migrar todos los valores de variables, pero las transferencias posteriores utilizan por defecto Seleccionar valores de variables a migrar, lo que excluye cualquier variable cuyo valor haya cambiado. Una variable que no se incluye y que aún no existe en el destino se transfiere sin valor.
- En una transferencia selectiva, el paso Configurar variables controla qué variables se transfieren, y la opción Incluir valor predeterminado determina si el valor del destino se reemplaza con el valor predeterminado del proyecto de origen.
- Resolución:
- En el diálogo Migrar, elige Migrar todos los valores de variables, o selecciona Seleccionar valores de variables a migrar y añade las variables que deseas transferir a Incluir.
- En una Transferencia selectiva, en el paso Configurar variables, selecciona las variables a transferir y establece Incluir valor predeterminado según sea necesario.
- Alternativamente, establece los valores correctos de las variables para el entorno de destino en Studio después de transferir. Realiza estos cambios en Studio en lugar de en la página Proyectos de la Consola de administración para que queden registrados en el historial del proyecto.
Cambiar el grupo de agentes de un entorno falla con un error de versión mínima de agente
-
Síntoma: Cambiar el grupo de agentes asociado a un entorno en la Consola de administración falla con:
MIN_RQRD_AGENT_VERSION_NOT_MET_CODE -
Posible causa: Uno o más agentes del grupo de agentes destino ejecutan una versión inferior a la versión mínima de agente que requiere el entorno, por lo que se rechaza el cambio. La versión mínima la establecen los proyectos implementados en el entorno: si algún proyecto implementado requiere una versión de agente más nueva que la que proporciona el grupo destino, el cambio falla. Esto puede ocurrir con un grupo de agentes privado, cuyas versiones de agente administras, o con un grupo de agentes en la nube, que Jitterbit actualiza según un calendario escalonado (sandbox antes de producción), por lo que un grupo de agentes en la nube destino puede estar brevemente una versión atrás durante un lanzamiento.
-
Resolución:
- Grupo de agentes privado: En la página Agentes de la Consola de administración, identifica cada agente del grupo destino y actualiza cada uno a una versión que cumpla o supere la versión mínima requerida del entorno (consulta Actualización gradual). Luego reintentar cambiar el grupo de agentes del entorno.
- Grupo de agentes en la nube: Jitterbit actualiza los agentes en la nube y no se pueden actualizar manualmente. Mantén el entorno en un grupo de agentes que ya cumpla con la versión requerida, o reintentar el cambio después de que se haya actualizado el grupo de agentes en la nube destino.
Design Studio: Los usuarios de SSO fuera de la región de la organización no pueden iniciar sesión
- Síntoma: Después de que se habilita el inicio de sesión único (SSO) de Harmony para la organización, los usuarios cuya región de Harmony es diferente de la región predeterminada a la que se conecta el diálogo de inicio de sesión de Design Studio no pueden completar el inicio de sesión de SSO. Los usuarios en la región predeterminada inician sesión sin problemas.
- Posible causa: Design Studio utiliza de forma predeterminada una única URL de región de Harmony en el diálogo de inicio de sesión. Cuando se habilita SSO, la redirección de SSO se resuelve solo contra la región de Harmony que aloja la organización, por lo que los usuarios deben apuntar Design Studio a la URL de esa región antes de iniciar sesión.
- Resolución:
- En el diálogo de inicio de sesión de Design Studio, presiona Ctrl + Shift + U para abrir el campo de URL. Ingresa la URL para la región de Harmony de la organización (por ejemplo,
https://na-east.jitterbit.compara NA ohttps://emea-west.jitterbit.compara EMEA), luego completa el inicio de sesión de SSO. - Para hacer que el cambio sea persistente, establece la URL en el archivo de configuración
client.properties:- Abre
<Jitterbit Studio Home>\configuration\client.propertiesen un editor de texto (en macOS, la ruta es/Applications/Jitterbit Studio [version].app/Contents/Java/configuration/client.properties). - Descomenta el parámetro
cloud.urly establécelo en la URL regional. - Guarda el archivo y reinicia Design Studio.
- Abre
- En el diálogo de inicio de sesión de Design Studio, presiona Ctrl + Shift + U para abrir el campo de URL. Ingresa la URL para la región de Harmony de la organización (por ejemplo,
La prueba de configuración de SSO bloquea la cuenta del proveedor de identidades
- Síntoma: Un administrador se queda bloqueado de su cuenta del proveedor de identidades mientras prueba una configuración de SSO en la Consola de administración.
- Posible causa: Cada clic en Probar configuración abre el portal de inicio de sesión del proveedor de identidades y cuenta como un intento de autenticación contra la política de bloqueo del IdP. Hacer clic en el botón repetidamente puede desencadenar el bloqueo de cuenta del IdP.
- Resolución:
- Limita el número de intentos de prueba en una sola sesión.
- Si se bloquea la cuenta del proveedor de identidades, sigue el proceso de recuperación de cuenta del IdP antes de reintentar la prueba de configuración de SSO. Consulta Configurar SSO para ver todos los pasos de configuración.
La política de lista de IP permitidas bloquea a un administrador
- Síntoma: Pierdes acceso al portal de Harmony inmediatamente después de que otro administrador cambie los rangos en Habilitar rango de IP en la lista blanca.
- Posible causa: La política Habilitar rango de IP en la lista blanca requiere que la dirección IP de cada usuario se incluya en el rango configurado. Un mensaje de validación impide que un administrador guarde un rango que excluya su IP actual, pero no verifica las direcciones IP de otros administradores. Si el cambio de otro administrador excluye tu IP, se te bloquea inmediatamente.
- Resolución:
- Haz que otro administrador cuya IP esté dentro de la lista de permitidas actualice o deshabilite la política, o contacta con soporte de Jitterbit.
Cambiar el subdominio de API rompe las integraciones de API existentes
- Síntoma: Después de cambiar el subdominio de API de una organización en los detalles de la organización de la Consola de administración, las llamadas a las API publicadas de la organización desde clientes e integraciones existentes comienzan a fallar.
- Posible causa: El subdominio de API forma la URL de API base para cada API de la organización, por lo que cambiarlo reescribe la URL de todas las API del API Manager de la organización. Cualquier cliente o integración que siga llamando a la URL anterior falla.
- Resolución:
- En los detalles de la organización, anota la URL base actualizada que se muestra en el campo Vista previa de URL de API base.
- Actualiza todas las integraciones, aplicaciones de cliente y configuraciones de webhook que hacen referencia a la URL de API base anterior.
- Para evitar interrupciones, planifica cambios de subdominio durante una ventana de mantenimiento y notifica a todos los consumidores de API con anticipación.
El acceso del usuario externo al Portal de API caduca en un momento inesperado
- Síntoma: El acceso de un usuario externo al Portal de API caduca antes o después de lo que el administrador esperaba según la fecha configurada.
- Posible causa: El acceso del usuario externo caduca a las 11:59 p.m. en la fecha de vencimiento seleccionada en la zona horaria local del usuario externo. Si el usuario y el administrador se encuentran en zonas horarias diferentes, el tiempo de caducidad efectivo difiere de lo que el administrador ve en la pantalla de configuración.
- Resolución:
- Al establecer una fecha de vencimiento para un usuario externo en la página Gestión de usuarios, ten en cuenta la zona horaria local del usuario al elegir la fecha.
- Para extender el acceso, edita la fecha de Acceso caduca del usuario antes de que venza la fecha actual.
Los cambios de entorno no se reflejan en las aplicaciones de Harmony
- Síntoma: Después de realizar cambios en un entorno en la Consola de gestión, los cambios no aparecen en Studio u otras aplicaciones de Harmony.
- Resolución: Cierra sesión en el portal de Harmony e inicia sesión nuevamente. Es posible que los cambios de entorno no se propaguen a otras aplicaciones de Harmony hasta que se actualice la sesión.
La configuración de SSO requiere clientes WMC y Studio
- Síntoma: La autenticación de inicio de sesión único (SSO) de Harmony falla o funciona solo para algunas aplicaciones de Harmony después de configurar un proveedor de identidad SSO.
- Causa: SSO de Harmony requiere que se configuren dos aplicaciones cliente separadas en el proveedor de identidad: WMC (para el portal de Harmony y todas las aplicaciones web) y Studio (para Design Studio). Configurar solo un cliente deja la otra aplicación sin soporte SSO.
- Resolución: Configura tanto las aplicaciones cliente WMC como Studio en el cajón Configurar SSO, incluso si no utilizas Design Studio. Para clientes de BMC, solo se requiere WMC.
Lista de omisión de SSO: Los miembros de la organización existentes no se pueden agregar directamente
- Síntoma: Agregar un miembro actual de una organización habilitada para SSO a su lista Omitir SSO falla, o el usuario aún no puede omitir SSO después de ser agregado.
- Causa: Se debe agregar un usuario a la lista Omitir SSO antes de agregarlo a la organización. Por lo tanto, un usuario que ya es miembro de la organización no se puede agregar directamente a su lista Omitir SSO.
- Resolución:
- Elimina el acceso del usuario a la organización.
- Agrega la dirección de correo electrónico del usuario a la lista Omitir SSO.
- Vuelve a agregar el usuario a la organización.
No se puede habilitar SSO: El usuario pertenece a varias organizaciones
-
Síntoma: Habilitar el inicio de sesión único (SSO) de Harmony para una organización de Harmony falla con:
SSO_CANNOT_BE_ENABLED_FOR_MEMBERS_ASSOCIATED_WITH_MULTIPLE_ORGS -
Posible causa: Uno o más usuarios en la organización también son miembros de otras organizaciones de Harmony, como organizaciones de prueba u organizaciones de Cloud Data Loader.
-
Resolución:
-
Revisa la lista de usuarios de la organización en la Consola de gestión para identificar usuarios que pertenecen a más de una organización de Harmony.
-
Para cada usuario afectado, elige una de las siguientes opciones:
- Elimínalos de las otras organizaciones a las que pertenecen (incluidas las organizaciones de prueba de Harmony o Cloud Data Loader), o de esta organización, de modo que pertenezcan a una única organización de Harmony.
- Para permitir que el usuario permanezca en varias organizaciones, agrégalo a la lista Omitir SSO, que los excluye de SSO para que inicien sesión con sus credenciales de Harmony. Como un miembro actual no se puede agregar directamente a la lista, primero elimina su acceso a esta organización, agrégalo a la lista Omitir SSO y luego vuelve a agregarlo.
-
-
Reintentar la configuración de SSO después de que todos los usuarios afectados se hayan eliminado o agregado a la lista de omisión de SSO.
El inicio de sesión SSO se redirige en un bucle sin error
- Síntoma: Un usuario que intenta iniciar sesión en Harmony mediante inicio de sesión único (SSO) (por ejemplo, con Azure) se redirige continuamente a la página de inicio de sesión sin mensaje de error.
- Posible causa: La caché del navegador obsoleta o las cookies interfieren con el flujo de autenticación de SSO.
- Resolución:
- Borrar la caché del navegador y todas las cookies relacionadas con Jitterbit, luego reintentar.
- Intentar iniciar sesión desde una ventana de navegación incógnita o privada para omitir los datos almacenados en caché.
- Intentar con un navegador diferente para descartar problemas de compatibilidad específicos del navegador.
La eliminación del almacenamiento de Cloud Datastore falla con error "no se puede excluir"
-
Síntoma: La eliminación de un almacenamiento de estado de Cloud Datastore o almacenamiento de claves falla con:
Failed to delete storage: <storage name> - Storage with ID <storage ID> cannot be excluded because it contains items. -
Resolución: Eliminar todos los datos (como registros) en el almacenamiento antes de eliminar el almacenamiento en sí, luego reintentar la eliminación.
La caducidad del token de actualización de OAuth causa falla en las operaciones conectadas
-
Síntoma: Las operaciones que utilizan un conector autenticado con OAuth 2.0 de 3 etapas (3LO) dejan de funcionar después de un período de tiempo, con errores de autenticación como
Connector could not retrieve the access token to be used in the HTTP callo un mensaje del proveedor de identidad indicando que el token de actualización se ha invalidado o ya se ha canjeado. La conexión a menudo se establece correctamente inmediatamente después de la autenticación y luego falla en una ejecución posterior. -
Posibles causas:
- Una Política de token en la página Registros de aplicación de la consola de administración tiene configurado Habilitar caducidad de token de actualización o Habilitar caducidad de inactividad de token de actualización, por lo que todas las operaciones dependientes de esa conexión fallan en tiempo de ejecución cuando el token caduca.
- La conexión estuvo inactiva más tiempo que la vida útil del token de actualización del proveedor de identidad. Como se describe en las Notas importantes de 3LO, los tokens de actualización se utilizan solo cuando una operación requiere acceso al punto de conexión: el conector renueva el token de acceso de forma reactiva cuando se ejecuta una operación, no a través de un proceso de fondo o una actualización de token programada independiente. Si ninguna operación accede al punto de conexión dentro de la vida útil del token de actualización (que algunos proveedores establecen en tan solo 24 horas), el token de actualización en sí caduca y la cadena de tokens se rompe, incluso cuando Habilitar token de actualización rotativo está seleccionado.
- El mismo registro de aplicación y credenciales de usuario se utilizan para 3LO en más de un proyecto o punto de conexión. Con Habilitar token de actualización rotativo seleccionado, cada actualización de token emite un nuevo token de actualización e invalida el anterior. Si las credenciales compartidas se vuelven a autenticar o se actualizan en un lugar, el token de actualización que las otras operaciones tienen se invalida, por lo que esas operaciones fallan.
-
Resolución:
- Si la causa es una configuración de caducidad de Política de token, revisar la política para el registro de aplicación afectado, renovar el token de actualización mediante el flujo de autenticación del conector, y habilitar Recibir notificación de caducidad en la configuración de conexión para recibir notificación con anticipación antes de que el token caduque nuevamente.
- Si la causa es un período inactivo, asegurarse de que se ejecute una operación que utilice la conexión dentro de la vida útil del token de actualización. No se admite programar una actualización de token independiente para mantener un token activo o restablecer un reloj de inactividad (consultar las Notas importantes de 3LO): el token se renueva solo como efecto secundario de una operación que realmente accede al punto de conexión. Para utilizar este comportamiento admitido, agregar una operación ligera en una programación de operación periódica que llame a un punto de conexión simple a un intervalo más corto que la vida útil del token de actualización (por ejemplo, cada dos horas), utilizando el mismo conector y registro de aplicación que las operaciones principales. Esta operación realiza una solicitud real al punto de conexión, por lo que cada ejecución renueva los tokens como parte del uso normal. Solo se necesita una operación de este tipo por registro de aplicación. Si el proveedor de identidad lo permite, también se puede extender la vida útil del token de actualización.
- Si más de un proyecto o punto de conexión comparte el mismo registro de aplicación y usuario, dar a cada uno su propio registro de aplicación (o usuario) para que sus cadenas de tokens no se invaliden entre sí, y evitar volver a autenticar la conexión compartida mientras otras operaciones dependan de ella.
API de registro de auditoría: la recuperación de tokens falla cuando TFA está habilitado
- Síntoma: Una solicitud a la API del Controlador de Servicio de Usuario para recuperar un token de autenticación para la API del Servicio de Registro de Auditoría devuelve un error.
- Causa: Cuando la autenticación de dos factores (TFA) está habilitada para la organización, una recuperación de token estándar de una sola solicitud falla. TFA requiere un flujo de autenticación de dos pasos.
- Resolución: Sigue el procedimiento de recuperación de tokens con TFA para obtener el token de autenticación utilizando el flujo de dos solicitudes.
Agregar un usuario externo falla con un error 409 conflict
-
Síntoma: Agregar un usuario externo en la página Gestión de Usuarios de la Consola de Administración falla con:
Failed to create new external user - 409 conflict error -
Posible causa: Ya existe un usuario con esa dirección de correo electrónico en el sistema de usuarios de Jitterbit, por lo que no se puede crear nuevamente el usuario externo, incluso si el usuario no es visible en la organización de destino.
-
Resolución: Contacta con el soporte de Jitterbit e incluye la dirección de correo electrónico. Posiblemente sea necesario reconciliar o reasignar la cuenta existente a nivel de plataforma antes de que se pueda agregar el usuario externo.
No se puede cambiar la región de la organización en el mismo lugar
- Síntoma: Una organización necesita moverse a una región de Harmony diferente (por ejemplo, de NA a EMEA) por razones de residencia de datos o cumplimiento normativo, pero no hay ninguna configuración para cambiar la región de una organización existente.
- Posible causa: La región de una organización se fija en la creación. Harmony no admite cambios de región en el mismo lugar.
- Resolución:
- Crea una nueva organización de Harmony en la región de destino.
- Exporta cada proyecto de integración de la organización de origen e impórtalo en la nueva organización.
- En la nueva organización, reconfigura los parámetros específicos del entorno, las conexiones, los cronogramas, las variables del proyecto y los perfiles de seguridad.
- Actualiza todos los clientes externos, integraciones o configuraciones de webhook para que apunten a las URL de API de la nueva región.
- Para una migración coordinada, contacta con el soporte de Jitterbit o Servicios Profesionales para planificar el tiempo y minimizar el tiempo de inactividad operativo.
Integración y automatización
Esta sección cubre problemas con la conexión a sistemas externos, la transformación y el procesamiento de datos, y la ejecución de operaciones de integración, junto con los agentes que las ejecutan.
Operaciones atrapadas en estado Enviado o En ejecución
-
Síntoma: Una operación no se completa como se esperaba. Permanece en estado Submitted o Running y nunca avanza, o se cancela con el mensaje:
Long running operation canceled by SystemLa cancelación puede ocurrir después de que la operación se ha ejecutado durante un tiempo o poco después de que comienza, y no necesariamente refleja cuánto tiempo se ejecutó realmente la operación.
-
Posibles causas:
- Un agente privado perdió su conexión con la plataforma Harmony y no pudo reportar el estado de la operación. La plataforma continúa mostrando la operación como Running y puede cancelarla como aparentemente bloqueada, incluso cuando la operación se completó en el agente. Esto puede afectar operaciones que normalmente se terminan en segundos.
- La operación se completó, pero su estado final no se reportó a Harmony, por lo que continúa apareciendo como Running hasta que agota el tiempo.
- El grupo de agentes está bajo una carga pesada y es lento para recoger o actualizar operaciones en cola.
- La operación está específicamente atrapada en Submitted: el mensaje de ejecución se puso en cola pero ningún agente en el grupo lo aceptó, porque los agentes están sin conexión, no son saludables o no tienen capacidad libre para aceptar nuevas operaciones (por ejemplo, cada hilo de trabajo está ocupado).
-
Resolución:
- Para agentes privados, confirma que el agente tenga el estado Running en la página Agents de la Management Console, revisa los registros del agente privado para detectar problemas de conexión y verifica que la conexión de red entre el agente y la plataforma Harmony sea estable.
- Revisa los registros de operación para confirmar qué sucedió durante la ejecución. El mensaje de cancelación puede aparecer incluso para operaciones que se ejecutaron brevemente, por lo que no necesariamente indica una operación genuinamente de larga duración. Los registros también pueden revelar un error específico a resolver, como
401 Unauthorized(verifica las credenciales) o429 Too Many Requests. Un429de un endpoint de destino se puede mitigar reduciendo la velocidad de solicitud o agregando lógica de reintentos; un429de la puerta de enlace de API de nube administrada por Jitterbit es su límite de plataforma de 200 solicitudes por minuto, así que distribuye las llamadas a lo largo del tiempo o ejecuta las API afectadas en agentes privados. - Mantén los agentes privados en una versión actual. Las versiones de agente más recientes mejoran la resiliencia del agente y reducen la cancelación prematura de operaciones.
- Intenta cancelar las operaciones afectadas. La cancelación está disponible para operaciones en estado Submitted, Received, Pending o Running desde la página Runtime de la Management Console, la tabla de registros de operación o el estado de ejecución de una operación en el lienzo de diseño.
- Si la operación afectada se ejecuta según una programación y nunca se inicia, consulta Operaciones programadas que no se ejecutan.
- Si las operaciones no se pueden cancelar, si el problema se repite o si muchas operaciones se ven afectadas a la vez, ponte en contacto con soporte de Jitterbit, ya que estos casos pueden requerir resolución del lado del servidor.
Nota
La configuración MaxOperationRuntimeSeconds en la sección [ProcessEngine] del archivo jitterbit.conf del agente privado solo limita cuánto tiempo se ejecuta una operación después de que un agente comienza a ejecutarla, por lo que no tiene efecto en operaciones aún en la cola en el estado Submitted. La configuración de operación Operation Time Out limita el tiempo total de ejecución de una operación, pero no se puede limitar solo al estado Submitted, así que reducirla para forzar una cancelación rápida también cancelaría operaciones que aún se están ejecutando legítimamente. Para liberar operaciones atrapadas en Submitted, restaura la capacidad y la salud del agente para que se recojan los mensajes de ejecución en cola, en lugar de ajustar un tiempo de espera.
Las operaciones programadas no se ejecutan
- Síntoma: Una operación configurada con una programación de operación no se ejecuta en la hora programada o se envía pero permanece en estado Pending o Received.
- Posibles causas:
- La programación se asignó a la operación en Studio pero el proyecto no se ha implementado. Las programaciones asignadas en Studio no tienen efecto hasta que se implementa el proyecto.
- La programación está deshabilitada.
- Existe una configuración incorrecta de zona horaria en la configuración de programación.
- Para agentes privados, el servicio de programación no se está ejecutando.
- El agente asociado al entorno está desconectado o no está en buen estado.
- Los cambios implementados en un proyecto no se han sincronizado completamente con el agente.
- El grupo de agentes está saturado de recursos. Un atraso de operaciones de larga duración o un uso sostenido alto de CPU o memoria puede evitar que un grupo de agentes recoja operaciones programadas a tiempo.
- Resolución:
- Confirma que el proyecto se haya implementado desde que se asignó la programación a la operación.
- Confirma que la programación esté habilitada. Las programaciones se pueden habilitar o deshabilitar solo desde la página Projects de la Management Console, en las pestañas Operations y Schedules.
- Revisa la configuración de la programación, prestando especial atención a la configuración de zona horaria. Para más detalles, consulta Zonas horarias de operación.
- Para agentes privados, verifica que el agente esté en línea y en buen estado en la página Agents de la Management Console y confirma que el servicio de programación se esté ejecutando en la máquina del agente. En Windows, verifica que Jitterbit Scheduler y Jitterbit Scheduler Service se ejecuten en el Administrador de tareas. En Linux y Docker, usa el comando
jitterbit status. - Reimplementa el proyecto para forzar la resincronización de la programación con el agente.
- Si las operaciones están atrapadas en un estado Pending, cancélalas desde la página Runtime de la Management Console y reinicia el servicio del agente.
- Si los errores de programación se correlacionan con la carga, reduce el número de operaciones concurrentes de larga duración. En agentes privados, también revisa el uso de CPU y memoria y equilibra las operaciones programadas con la capacidad del agente (un agente privado puede ejecutar hasta el doble del número de núcleos de CPU en operaciones concurrentes).
- Si una operación programada se envía pero luego se detiene en lugar de nunca iniciarse, consulta Operaciones atrapadas en estado Submitted o Running.
El diccionario o la variable global está vacío después de que una operación se ejecuta de forma asincrónica
- Síntoma: Un diccionario o variable global rellenada dentro de una operación secundaria está vacía o mantiene su valor anterior cuando la operación principal la lee después de invocar la secundaria de forma asincrónica.
- Causa posible: Cuando se invoca una operación de forma asincrónica (el tipo de ejecución del Invoke Operation configurado como Asincrónico, o
RunOperationllamado conrunSynchronouslyestablecido enfalse), la operación secundaria se ejecuta en un hilo separado y la operación principal continúa sin esperar. Las variables globales y diccionarios se pasan a la operación secundaria por valor en lugar de por referencia y no son seguros para subprocesos, por lo que los cambios realizados en la operación secundaria no se reflejan en la operación principal. La operación principal también puede leer el valor antes de que la operación secundaria termine. Para comportamiento equivalente en operaciones multihilo fragmentadas, consulta Variable updates lost in chunked multi-threaded operations. - Resolución:
- Si la operación principal depende de valores que produce la operación secundaria, invoca la operación secundaria de forma sincrónica (el tipo de ejecución del Invoke Operation configurado como Sincrónico, o
RunOperationejecutado de forma sincrónica, que es el valor predeterminado) para que la operación secundaria se complete y la operación principal herede sus cambios de variable global. - Para compartir datos entre operaciones que deben ejecutarse independientemente, persiste los datos con funciones de caché (
WriteCacheyReadCache) en lugar de depender de un diccionario o variable global entre subprocesos. Por defecto, las funciones de caché se limitan a 100 llamadas combinadas por minuto por organización. - Insertar un retraso fijo (por ejemplo, con la función
Sleep) agrega latencia y no garantiza que la operación secundaria haya terminado; en su lugar, ejecuta la operación de forma sincrónica.
- Si la operación principal depende de valores que produce la operación secundaria, invoca la operación secundaria de forma sincrónica (el tipo de ejecución del Invoke Operation configurado como Sincrónico, o
504 Gateway Timeout (operaciones activadas por API)
- Síntoma: Las llamadas de API a través de la puerta de enlace de API en la nube o privada devuelven
504 Gateway Timeout, típicamente después de la ventana de tiempo de espera de la puerta de enlace (30 a 180 segundos). - Causa y resolución: La operación de respaldo está excediendo el tiempo de espera de la puerta de enlace de API, o no se puede asignar la solicitud a un agente disponible. Consulta HTTP 504 Gateway Timeout para conocer las causas completas y la resolución.
507 Almacenamiento insuficiente
-
Síntoma: Una llamada de API devuelve:
507 Insufficient Storage -
Posibles causas:
- El agente o el host de la puerta de enlace se ha quedado sin espacio en disco.
- En una puerta de enlace de API privada, la puerta de enlace no puede abrir su archivo de carga útil o respuesta alojado y devuelve un 507 incluso cuando hay suficiente espacio en disco disponible. Esto generalmente apunta a un problema de registro de dominio privado o configuración de la puerta de enlace.
-
Resolución:
- Confirma que el agente o el host de la puerta de enlace tenga suficiente espacio libre en disco.
- Si el espacio en disco es suficiente y la API se sirve a través de una puerta de enlace de API privada, consulta La puerta de enlace privada devuelve HTTP 507 o "No existe ese archivo o directorio" para la causa y resolución.
502 Bad Gateway
-
Síntoma: Una operación que usa Jitterbit Message Queue (JBMQ) falla con:
502 Bad GatewayEl servidor devolvió una respuesta inválida o incompleta.
-
Causa posible: El servicio JBMQ no devolvió una respuesta completa a la solicitud, produciendo un 502. Este error generalmente es transitorio y puede no ser reproducible.
- Resolución:
- Reintenta la operación.
- Si el error persiste, contacta al soporte de Jitterbit.
Fallo al crear directorio temporal
-
Síntoma: Una operación no puede crear un directorio temporal y muestra un error como el siguiente:
Failed to create the directory '/tmp/jitterbit/...'. Reason: boost::filesystem::create_directories: Permission deniedEn un grupo de agentes en la nube, es posible que muestre
No space left on device. -
Posibles causas:
- En un agente privado, la cuenta de servicio del Agente de Jitterbit carece de permisos a nivel del SO en la ruta de archivos temporales, o el disco está lleno.
- En un grupo de agentes en la nube, la causa está en el lado del agente administrado por Jitterbit, no en tu proyecto o configuración.
-
Resolución:
- Para agentes privados, confirma que la cuenta de servicio del agente tiene permisos suficientes en la ruta de archivos temporales (
/tmpoTemporaryFiles), y verifica que el host del agente tenga espacio en disco libre adecuado. - Para grupos de agentes en la nube, esto indica un problema en el lado del agente que Jitterbit resuelve. Contacta a soporte de Jitterbit e incluye el mensaje de error y la hora en que ocurrieron las fallas.
- Para agentes privados, confirma que la cuenta de servicio del agente tiene permisos suficientes en la ruta de archivos temporales (
Mensajes del registro de operación truncados aproximadamente en 100 KB
- Síntoma: Un mensaje de registro de operación aparece cortado, terminando con
message truncated. Esto puede aparecer en los registros de operación o al ver una entrada de registro de Operación en la página Registros de API del Administrador de API. - Posible causa: Los mensajes de registro de operación que superan aproximadamente 100 KB (aproximadamente 99,000 caracteres) se truncan. El punto de truncamiento se marca con
message truncatedal final del mensaje. - Resolución: Si necesitas el contenido completo del registro, reduce la verbosidad del registro de la operación o divide la operación en unidades más pequeñas que generen mensajes de registro más cortos.
El registro de depuración de operación expone PII y credenciales en texto plano
- Síntoma: Datos sensibles, credenciales o información de identificación personal (PII) aparecen en los registros de la nube de Harmony.
- Posible causa: Cuando se habilita el registro de depuración de operación para una operación, todos los datos de solicitud y respuesta se almacenan en la nube de Harmony en texto sin cifrar durante 30 días.
- Resolución:
- Usa el registro de depuración de operación solo en entornos controlados que no sean de producción o durante un período de diagnóstico limitado.
- Para deshabilitar la generación de datos de entrada y salida de componentes para un grupo de agentes privados, establece
verbose.logging.enable=falseen la sección[VerboseLogging]del archivo de configuración del agente.
Fallo de conexión a la base de datos del agente privado
-
Síntoma: Las operaciones fallan con:
Failed to connect to back-end database 'TranDb'FATAL: query_wait_timeout -
Causa posible: La base de datos PostgreSQL interna del agente privado no está disponible o el grupo de conexiones se agotó.
- Solución: Consulta Fallos de conexión
TranDbpara obtener los pasos completos de resolución.
El certificado de cliente falla al cargar en agentes privados de Linux
-
Síntoma: Una operación que realiza una llamada de servicio web TLS mutuo (certificado de cliente) saliente falla en tiempo de ejecución en un agente privado de Linux, con un error como:
Problem with the local SSL certificate. Unable to set private key file: '<path>.key' type PEM.El certificado se carga exitosamente en Studio, pero la operación falla cuando se ejecuta. La misma configuración puede haber funcionado anteriormente en un agente privado de Windows.
-
Causas posibles:
- El usuario del sistema operativo que ejecuta el agente Jitterbit no tiene permiso de lectura para el archivo de clave privada o sus directorios principales.
- Un módulo de seguridad de Linux como SELinux o AppArmor está bloqueando el acceso del agente al archivo de clave privada.
-
Resolución:
- Verifica que la cuenta que ejecuta el agente de Jitterbit tenga acceso de lectura al archivo de clave privada y a todos los directorios principales.
- Comprueba si SELinux o AppArmor están restringiendo el acceso al archivo de clave y ajusta la política o el contexto del archivo según sea necesario.
Errores de validación de operación
Se debe validar las operaciones antes de que se puedan desplegar. Para obtener la lista completa de mensajes de error de validación y sus soluciones, consulta Errores de validación de operación en la guía de solución de problemas de operación.
Los nombres de componente deben ser únicos después de importar el proyecto
-
Síntoma: Después de importar un proyecto desde un archivo de exportación JSON, uno o más componentes se muestran como inválidos y la implementación falla con un mensaje similar a:
[Operation / Connection / Activity / Transformation / Script / Tool / Email / Variable] names must be unique. -
Causa posible: El proyecto importado contiene múltiples componentes del mismo tipo con nombres idénticos. Studio evita crear nombres duplicados al configurar componentes directamente en la interfaz de usuario, pero una importación de proyecto completa no aplica esa verificación.
- Resolución:
- En el panel del proyecto, identifica los componentes inválidos, que se muestran en cursiva roja con un icono de error .
- Haz clic en el icono de error para ver el nombre duplicado específico que causa el conflicto.
- Cambia el nombre de uno de los componentes duplicados para que cada nombre sea único dentro de su tipo.
- Reimplementa el proyecto después de resolver todos los errores de nombres duplicados.
- Para traer solo componentes seleccionados a un proyecto existente, usa importación selectiva, que marca conflictos con componentes con el mismo nombre ya presentes en el proyecto destino y te permite reemplazarlos o mantener ambos.
El conector solo para agente privado bloquea la importación en un entorno de agente en la nube
-
Síntoma: La importación o migración de un proyecto a un entorno asociado con un grupo de agentes en la nube se bloquea porque el proyecto utiliza un conector solo para agentes privados. El mensaje enumera los conectores solo para agentes privados responsables. Una importación de proyecto completa muestra:
The project you are importing uses private agent only connectors and cannot be imported into a cloud environment.Una importación selectiva muestra un diálogo Component import not allowed:
The components you are importing uses private agent only connectors and cannot be imported into a cloud environment. -
Causa posible: El proyecto utiliza uno o más conectores que están disponibles solo en agentes privados. La columna Agent availability en la lista de conectores muestra cuáles son solo para agentes privados. Los agentes en la nube no soportan estos conectores, por lo que Studio evita que el proyecto se importe o migre a un entorno de agente en la nube.
- Resolución:
- Importa o migra el proyecto a un entorno asociado con un grupo de agentes privados que tenga el conector requerido instalado.
- Si el proyecto debe ejecutarse en agentes en la nube, reemplaza las actividades del conector solo para agentes privados con conectores compatibles con la nube (como HTTP v2 para API REST, o el conector Database con un endpoint accesible desde la nube) antes de importar.
Nodo de bucle de destino asignado a múltiples nodos de bucle de origen
-
Síntoma: Una transformación es inválida o falla al desplegar con:
Mappings of a target loop node depend on more than one source loop node. -
Posible causa: Un nodo de bucle de destino tiene asignaciones de campo que hacen referencia a dos o más nodos de bucle de origen diferentes. Cada nodo de bucle de destino puede iterar sobre un único nodo de bucle de origen.
- Resolución:
- Abre la transformación e identifica el nodo de bucle de destino señalado en el error.
- Revisa las asignaciones bajo ese nodo para confirmar que todos los campos asignados provienen del mismo nodo de bucle de origen.
- Si se necesitan datos de múltiples nodos de origen, preprocesa o combina los datos de origen adicionales en un paso de script antes de la transformación, de modo que un único nodo de origen unificado alimente el bucle de destino.
- Para obtener más detalles sobre patrones de asignación válidos, consulta Validez de asignación de transformaciones.
Propiedades de configuraciones avanzadas: Variables que contienen JSON sin procesar deben escaparse
- Síntoma: Muchos conectores incluyen una tabla de Propiedades de configuraciones avanzadas para configuraciones de conexión opcionales. Las variables utilizadas en estos campos que contienen JSON sin formato deben tener el JSON escapado; pasar JSON sin formato sin escapar a través de una variable causa que el valor del campo sea incorrecto.
- Posible causa: Los campos de la tabla Propiedades de configuraciones avanzadas no admiten variables que contengan objetos JSON sin escapar.
- Resolución:
- Antes de pasar contenido JSON a través de una variable en un campo Propiedades de configuraciones avanzadas, escapa el JSON. Por ejemplo,
{"success": "true"}debe escaparse como{\"success\": \"true\"}antes de asignarlo a la variable. - Si ingresa el valor JSON directamente en el campo (no a través de una variable), no se requiere escapado.
- Las variables en campos Propiedades de configuraciones avanzadas se rellenan en tiempo de ejecución solo en la versión del agente 10.75 / 11.13 o posterior. Si un valor de variable no aparece en tiempo de ejecución, confirma que el agente cumple con esta versión mínima.
- Antes de pasar contenido JSON a través de una variable en un campo Propiedades de configuraciones avanzadas, escapa el JSON. Por ejemplo,
Elementos XML no compatibles (CDATA) incrustados en JSON
-
Síntoma: Las secciones de datos de caracteres (CDATA) no se admiten en XML incrustado dentro de JSON que se pasa a través de una transformación. Cuando están presentes, el siguiente error aparece en el registro de operación:
Transformation failed. Error: The operation "Operation" failed. Error: Failed to convert XML file to JSON. org.jitterbit.integration.server.engine.EngineSessionException: org.xml.sax.SAXParseException ... -
Resolución: Utiliza un script de Jitterbit para
Replacelos caracteres&,<,>,'y"dentro de la sección CDATA, incluidos los delimitadores de CDATA (<![CDATA[ ... ]]>), por sus equivalentes escapados (&,<,>,',"). Si no es posible dirigirse solo a la sección CDATA, se puede reemplazar toda la cadena XML que la contiene.El siguiente ejemplo se considera inválido sin estos reemplazos:
{
  "name": "Jitterbit",
  "data": "<xml><content><![CDATA[<greeting>Hello, world!</greeting>]]></content></xml>"
}
La transformación falla cuando un valor de cadena JSON excede la longitud máxima
-
Síntoma: Una transformación que procesa un valor de cadena JSON grande falla con un error que reporta que la cadena excede la longitud máxima permitida, por ejemplo:
Transformation failed. Error: Error Code: String value length (20054016) exceeds the maximum allowed (20000000, from StreamReadConstraints.getMaxStringLength())El seguimiento de pila hace referencia a
StreamConstraintsExceptiony al analizador JSON del agente. Un desencadenante común es una respuesta de HTTP v2 con Get response content in base64 string habilitada: la codificación Base64 amplía el contenido binario (como un archivo de audio o multimedia), por lo que la cadena codificada puede exceder el límite incluso cuando el archivo original es más pequeño. -
Causa: El analizador JSON del agente limita un único valor de cadena JSON a 20 MB (
20000000caracteres) de forma predeterminada. Una respuesta o valor asignado más grande que esto falla mientras el agente lo analiza, antes de que se ejecute cualquier actividad posterior (como una carga). -
Resolución: En un agente privado que ejecuta la versión 12.5 o posterior, aumenta el límite con la clave
MaxStringLengthen la sección[JsonParser]del archivo de configuraciónjitterbit.conf(por ejemplo, establécela en50000000para un límite de 50 MB) y luego reinicia el agente. Esta clave está disponible en la versión del agente 12.5 y posteriores, así que actualiza primero el agente si está en una versión anterior.
Caracteres especiales en esquemas JSON proporcionados por el conector
-
Síntoma: Cuando una transformación utiliza un esquema JSON heredado de una actividad de conector adyacente, cualquier carácter especial en un nombre de campo o nodo del esquema se reemplaza por guiones bajos (
_). Al usar procesamiento JSON heredado (el predeterminado para proyectos creados antes de la versión 11.48 de Harmony), esto puede causar que el punto final devuelva errores porque los nombres de campo reales ya no coinciden con lo que espera.Por ejemplo, si la actividad proporciona un campo denominado
location_ids[], se convierte alocation_ids__. Si el punto final aún espera el nombre original, puede devolver un error como:
"error_message": "{location_ids:expected String to be a Array}"
-
Resolución:
-
Confirmar que se esté usando un esquema JSON en la actividad afectada. Estos esquemas tienen un nodo raíz denominado
json: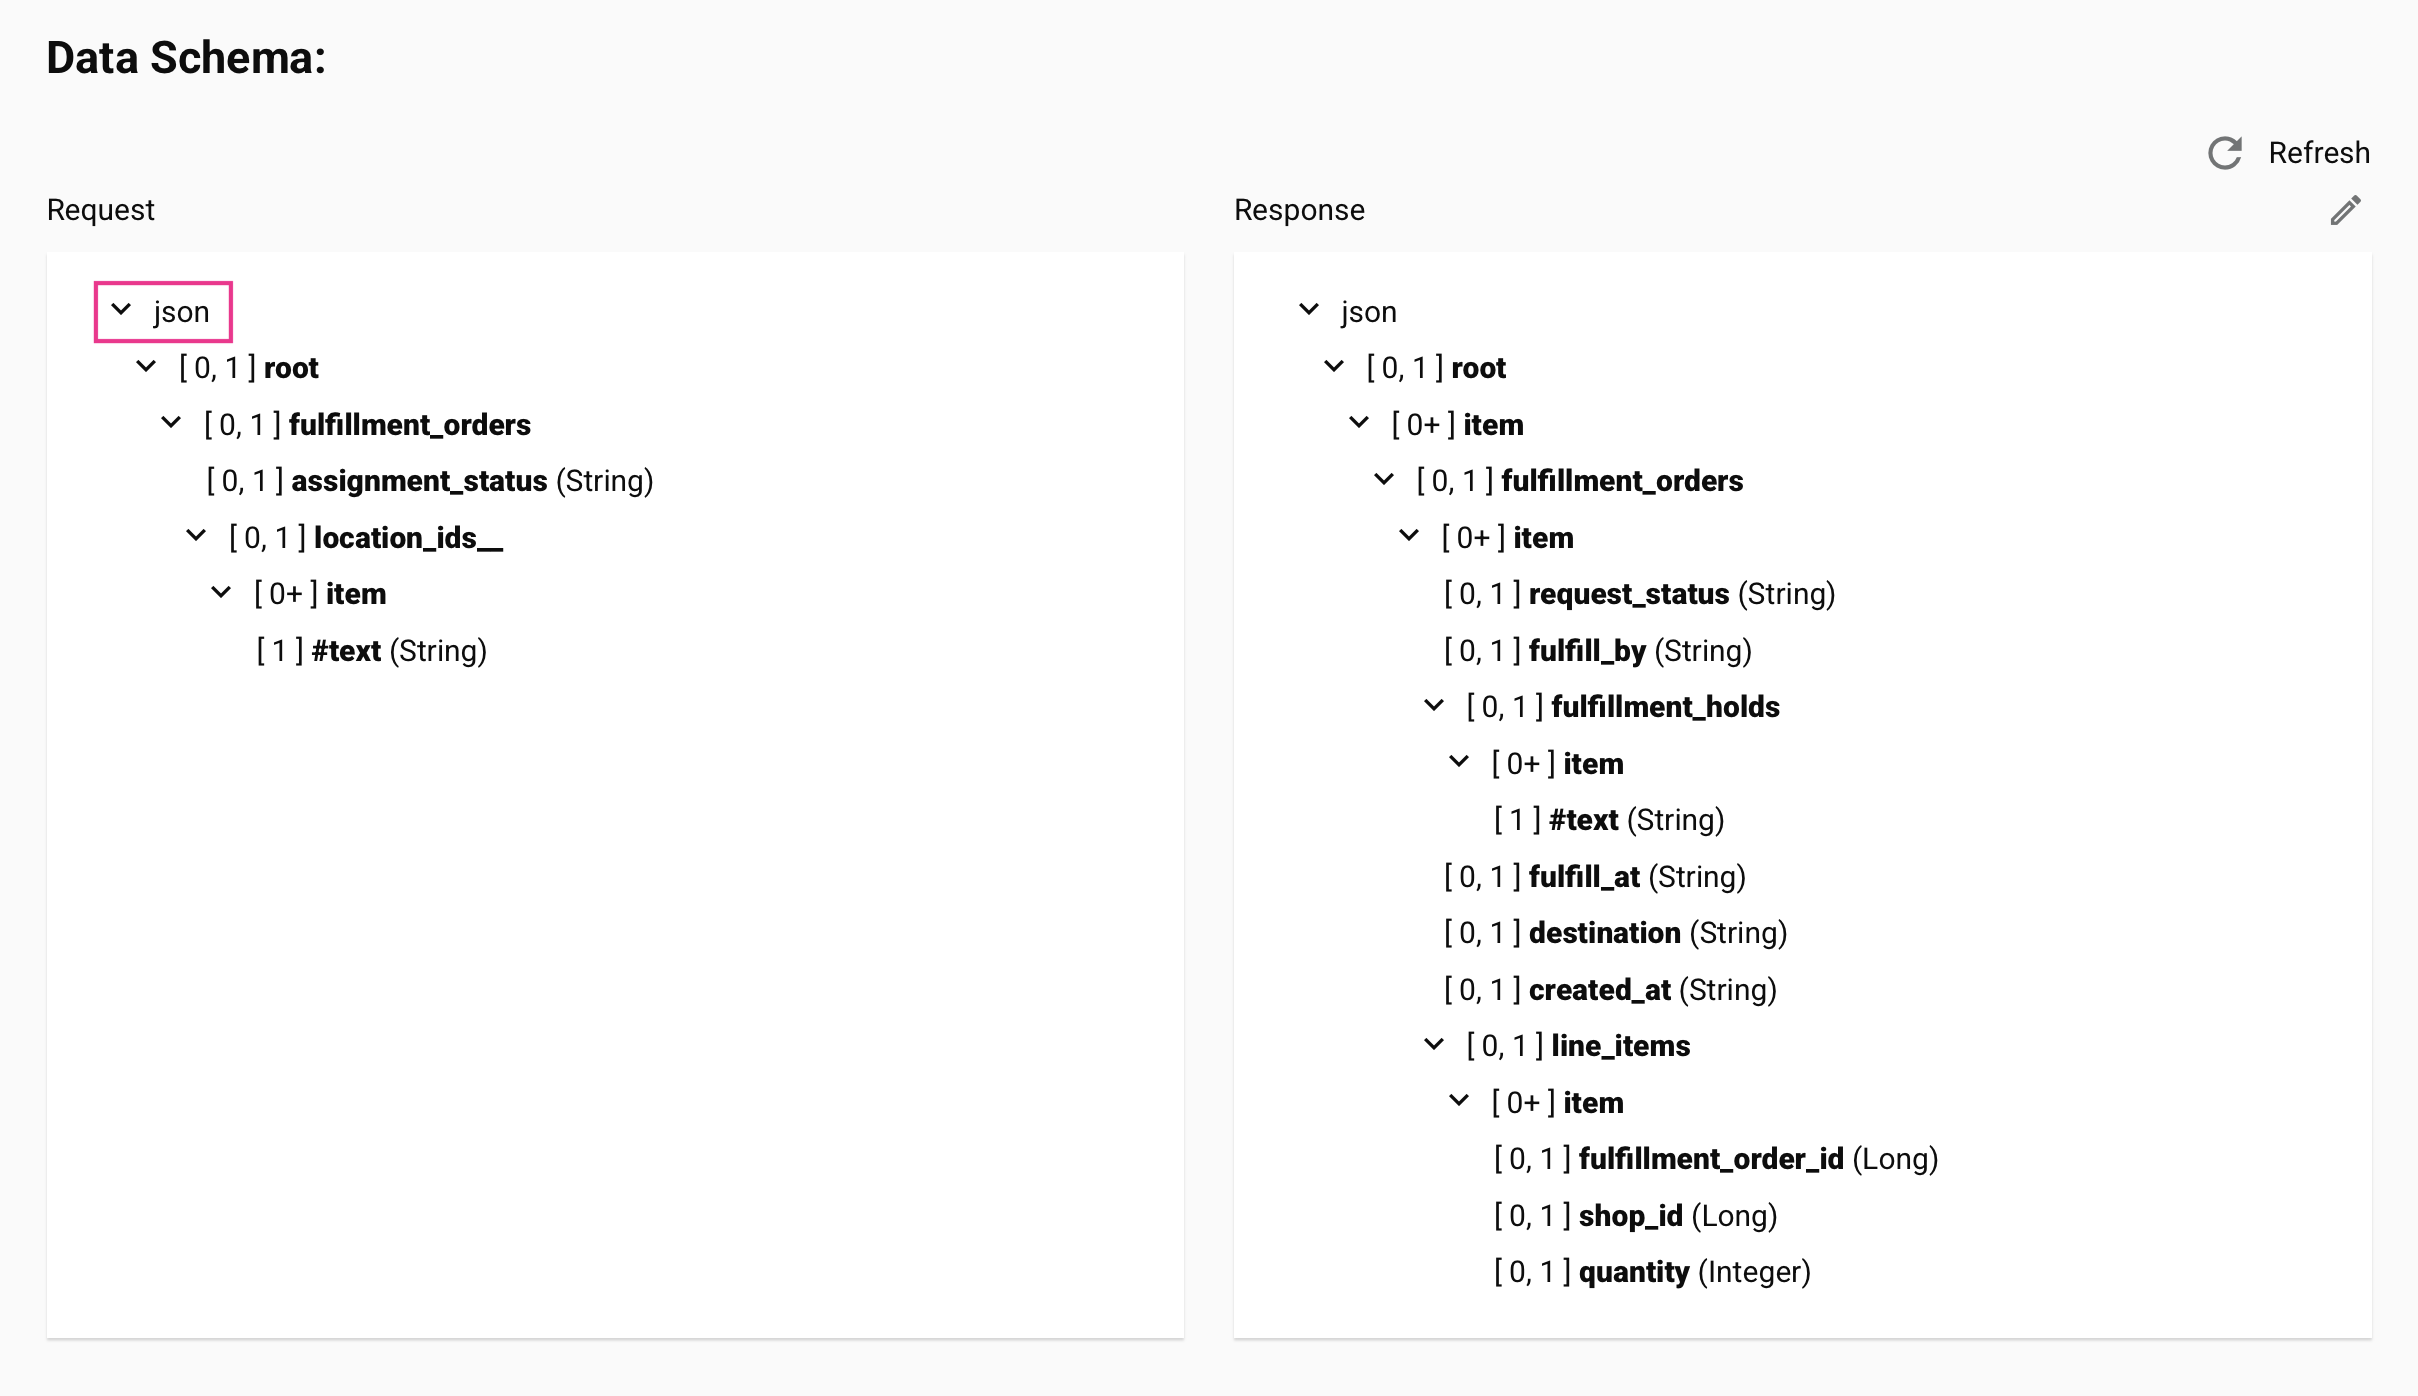
-
Habilitar la configuración de proyecto Preserve JSON names (requiere versión del agente 11.48 o posterior).
- Reconfigurar, implementar y ejecutar la operación.
Importante
Cuando se habilita Preserve JSON names en un proyecto donde estaba deshabilitado anteriormente, el nuevo método de procesamiento se aplica solo a las operaciones y esquemas configurados después de habilitar esta configuración. Las operaciones y esquemas existentes continúan utilizando el procesamiento JSON heredado. Para evitar inconsistencias dentro de un proyecto, reconfigurar todas las operaciones y esquemas existentes después de habilitar esta configuración.
Para verificar el nombre del campo que se envía al punto de conexión, revisar el valor
jsonPropertyNameen los datos de entrada o salida de la actividad con el registro de depuración habilitado: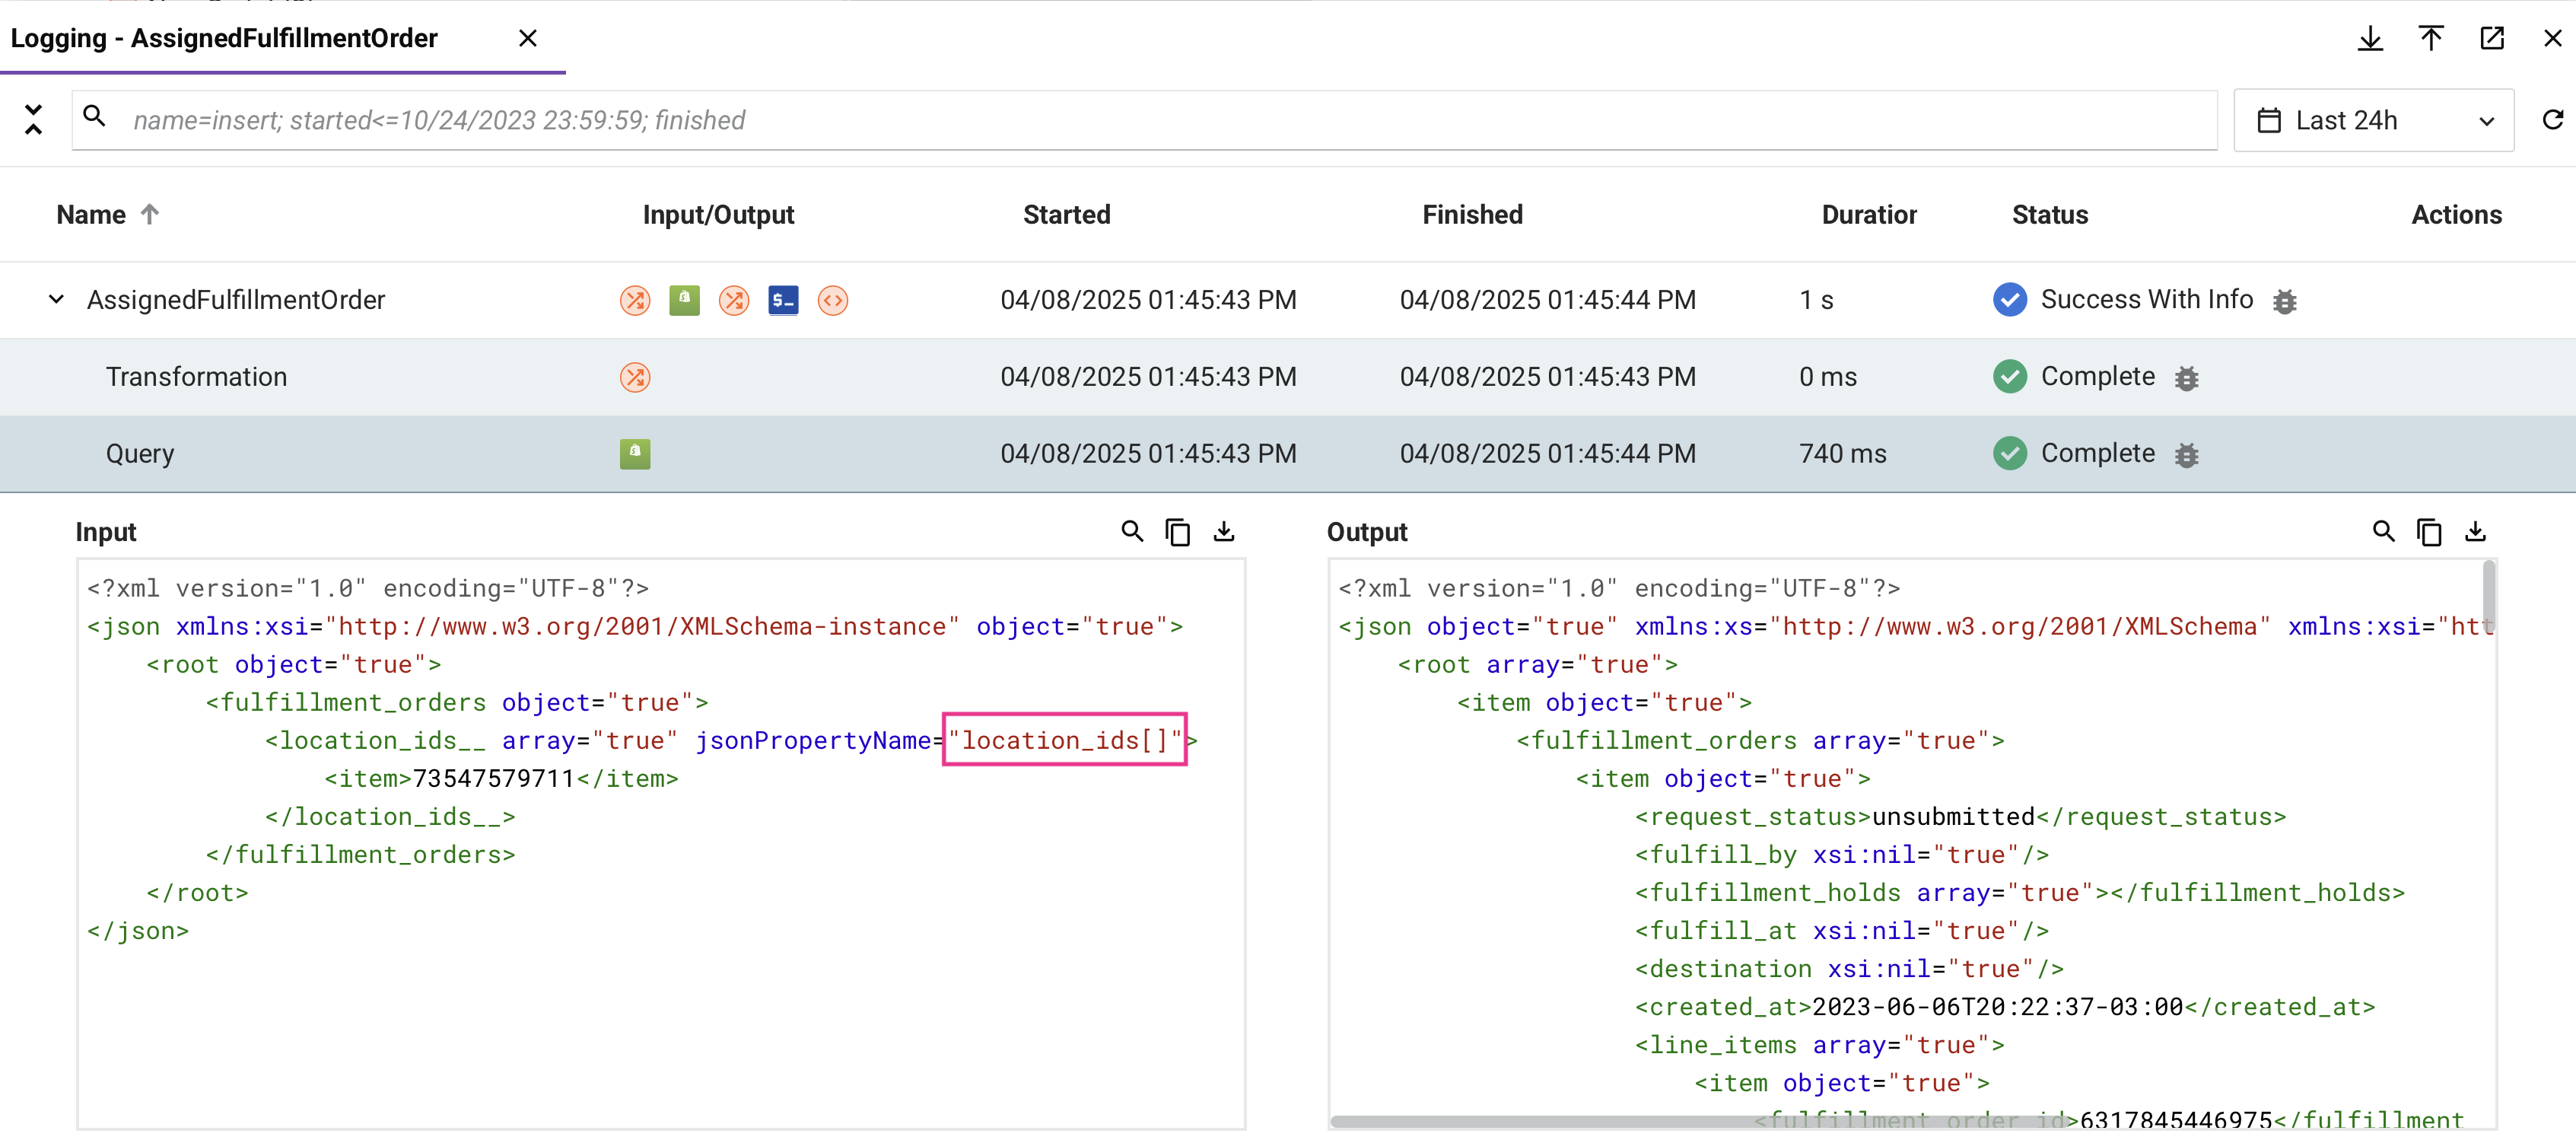
-
Los caracteres multibyte se corrompen en una respuesta de conector grande
- Síntoma: Un carácter multibyte en una respuesta del conector JSON se corrompe. El texto corrupto muestra el patrón clásico de bytes UTF-8 decodificados como Latin-1 (por ejemplo,
São Luísse devuelve comoSão LuÃs). Típicamente, solo se ve afectado un carácter multibyte que aparece después de aproximadamente los primeros 8 KB de la respuesta; el mismo carácter que aparece antes en la respuesta no se ve afectado. - Causa posible: En las versiones del agente 12.8 y 12.9, la detección automática de codificación de caracteres solo analiza el inicio de la respuesta para determinar su codificación. Si esa muestra contiene solo caracteres ASCII, la respuesta se detecta como Latin-1 (ISO-8859-1) en lugar de UTF-8, corrompiendo cualquier carácter multibyte que aparezca más allá de la porción analizada.
- Resolución: Actualizar a la versión del agente 12.10 o posterior, que corrige la detección de codificación.
Esquemas duplicados con grupos de sustitución
-
Síntoma: Los esquemas duplicados que usan grupos de sustitución XML no son compatibles. Usar uno resulta en un error en tiempo de ejecución:
Failed to initialize transformation "<transformation name>". Failed to expand the (source|target) tree for the path: <path to substitution head node>.Este error también puede ocurrir por otras razones, como importar una asignación de transformación con nodos duplicados, y no necesariamente indica un problema de grupo de sustitución.
-
Resolución: Si se confirma que los grupos de sustitución son la causa, limpiar el esquema duplicado y recrearlo usando un método diferente (carga, creación de esquema personalizado, etc.).
La importación de un mapeo de transformación con nodos duplicados falla con "no se puede crear el nodo"
-
Síntoma: Una transformación cuya asignación fue importada de un archivo que hace referencia a nodos duplicados falla en tiempo de ejecución con un error como:
Failed to initialize transformation "<transformation name>". Failed to expand the target tree for the path: <path to node>. The node: <node name> cannot be created.
La asignación puede parecer correcta en el diseñador de transformaciones aunque la operación falle al ejecutarse.
-
Posible causa: Importar un archivo de asignación que añadió nodos duplicados al esquema de destino no aplicó el cambio correspondiente a la definición del esquema utilizada cuando se ejecuta la operación, dejando las dos desincronizadas. Esto se ha corregido, pero una transformación cuya asignación se importó antes de la corrección aún puede verse afectada.
-
Resolución: En la transformación afectada, usa Eliminar todas las asignaciones bajo este nodo en el nodo raíz para quitar todas las asignaciones, luego importa el archivo de asignación nuevamente. Reimportar resincroniza la definición del esquema utilizada en tiempo de ejecución con la asignación. Si el error persiste, reconfigura la actividad que proporciona el esquema, luego actualiza el esquema en la transformación.
Advertencia de subelemento adicional en registros de operación
- Síntoma: Un mensaje de
subelemento adicionalen los registros de operación es una advertencia, no un error, y generalmente puede ignorarse. Indica que la carga útil de la API de un conector devolvió más nodos o campos de los definidos en el esquema de datos de respuesta. - Resolución: Si necesitas capturar los datos adicionales, actualiza el esquema para incluir los campos adicionales.
Límite de iteración de bucle de secuencia de comandos excedido
- Síntoma: Un script falla con un error indicando que se ha alcanzado el número máximo de iteraciones de bucle. El límite predeterminado es de 50.000 iteraciones.
- Causas posibles:
- Un bucle en un script de Jitterbit supera el límite de iteraciones de la plataforma.
- Un script de JavaScript contiene múltiples bucles cuyos recuentos de iteraciones combinados superan 50.000. En JavaScript, el límite se aplica por script (en todos los bucles), no por bucle individual.
- Resolución:
- Revisa la lógica del script para determinar si el bucle puede optimizarse para reducir el número de iteraciones.
- Para scripts de JavaScript en agentes privados, el límite por script puede aumentarse agregando
JavaScriptMaxIterations=X(dondeXes mayor que50000) a la sección[Settings]del archivo de configuración del agente privado. - Para Jitterbit Script en agentes privados, aumenta el límite configurando
jitterbit.scripting.while.max_iterationsa un valor mayor que50000.
RunOperation deja de ejecutarse después de 50 llamadas síncronas en un bucle While
-
Síntoma: Después de actualizar un agente privado a la versión 12.11 o posterior, un script que llama a
RunOperation,RunOperationFromProjectoReRunOperationde forma sincrónica desde dentro de un bucleWhileprocesa menos registros de los esperados. No se produce un error a nivel de operación a menos que el script mismo verifique el valor de retorno de la función o llame aGetLastError. El registro de operación muestra una entrada que identifica la operación invocada por nombre (usando su GUID como alternativa si no se puede resolver el nombre) cuando se alcanzó el límite, yGetLastErrordevuelve esta misma información de identificación. -
Causa posible: A partir de la versión de agente 12.11, un límite a nivel de agente (
MaxSynchronousRunOperationCallsInLoopen la sección[OperationEngine]del archivojitterbit.conf, 50 de forma predeterminada) limita el número de llamadas sincrónicas aRunOperation,RunOperationFromProjectyReRunOperationrealizadas dentro de un único bucleWhile; los tres comparten un recuento acumulativo por bucle. Una vez alcanzado el límite, cada llamada posterior devuelvefalsesin generar un error, por lo que un bucle que no verifica el valor de retorno continúa iterando sin darse cuenta de que las llamadas posteriores no hicieron nada. -
Resolución:
- Si el bucle no verifica el valor de retorno, envuelve la llamada para que un límite activado genere un error de script, por ejemplo:
If(!RunOperation("<TAG>operation:MyOp</TAG>"), RaiseError(GetLastError()));. - Para aumentar el límite de una operación específica, configura la variable Jitterbit
jitterbit.operation.max_sync_runop_calls_in_loopantes de que se ejecute el bucle, siempre que se permitan sobrescrituras por operación (MaxSynchronousRunOperationCallsInLoopOverrideAllowed). - Para aumentar el valor predeterminado en todo el agente, incrementa
MaxSynchronousRunOperationCallsInLoopen la sección[OperationEngine]del archivojitterbit.conf.
- Si el bucle no verifica el valor de retorno, envuelve la llamada para que un límite activado genere un error de script, por ejemplo:
Comparar una cadena con un número produce resultados inesperados
-
Síntoma: Una comparación entre una cadena y un número devuelve un resultado inesperado. Por ejemplo, comparar una cadena no numérica con
0se evalúa como igual, por lo que se ejecuta la rama incorrecta:$value = "test"; If($value == 0, WriteToOperationLog("equal"), WriteToOperationLog("not equal")); // logs "equal", even though "test" is not 0 -
Causa: Cuando los dos operandos son de diferentes tipos, Jitterbit Script convierte ambos a números para compararlos. Una cadena que no representa un número se convierte a
0, por lo que"test" == 0se convierte en0 == 0, que estrue. Este es el comportamiento esperado. -
Resolución: Compara valores del mismo tipo. Para probar una cadena contra un valor específico, compárala con una cadena literal (por ejemplo,
$value == "0"o$value == "") en lugar de un número. Si un valor puede llegar como cualquier tipo, convierte ambos operandos al mismo tipo (por ejemplo, conString) antes de comparar.
Reprocesamiento de esquema XML reflejado en proyectos creados antes de la versión 10.25
-
Síntoma: Debido a cambios en las versiones de Harmony 10.25 y 10.27, los proyectos creados antes de 10.25 que utilizan esquemas XML espejados pueden comportarse de manera diferente a la esperada. Las asignaciones que utilizaron funciones XML que involucran espacios de nombres (como
SelectNodes) pueden ahora ser inválidas.La diferencia está en el manejo del prefijo del espacio de nombres:
- Antes de 10.25: Los esquemas XML espejados utilizaban el prefijo de espacio de nombres predeterminado
xsi. - 10.25 en adelante: Los esquemas XML espejados utilizan el prefijo de espacio de nombres calificado
ns. Los campos sin asignar no se muestran en el esquema.
- Antes de 10.25: Los esquemas XML espejados utilizaban el prefijo de espacio de nombres predeterminado
-
Resolución: A partir de la versión 10.27, importar un proyecto cuyos esquemas XML espejados se crearon antes de 10.25 conserva el prefijo del espacio de nombres original, por lo que el esquema es idéntico a cuando se creó. Para forzar una actualización al prefijo del espacio de nombres actual, regenera el esquema actualizándolo o reconfigurando la actividad que lo proporciona. Después de regenerar, revisa todas las llamadas de función de espacio de nombres XML afectadas y actualiza las referencias de prefijo según corresponda.
Consulta la comparación de esquema XML anotado para ver una ilustración de la diferencia entre los dos formatos.
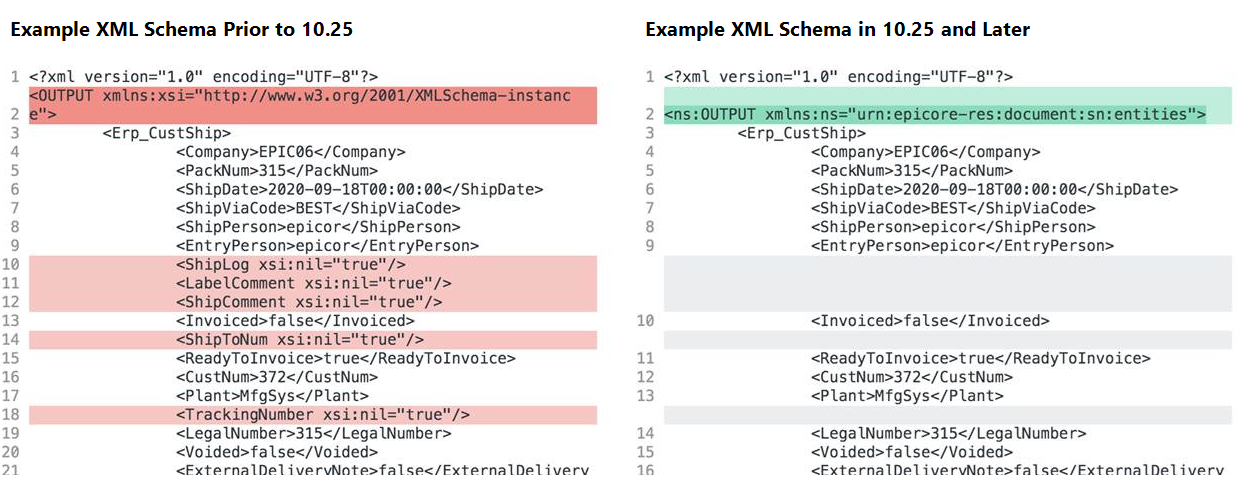
Salida de transformación convertida a 0 para campos de destino con tipo de dato double
- Síntoma: Un campo de destino con tipo de dato
doubleen el esquema recibe un valor de0aunque el script de asignación devuelve un valor de cadena no vacío. - Posible causa: Cuando la transformación procesa una salida de script, coacciona el resultado al tipo de dato del campo de destino. Si el valor de cadena comienza con un carácter que no es un dígito (por ejemplo,
"string1"), no se puede extraer ninguna porción numérica y el campo recibe el valor numérico predeterminado de0. Por el contrario, un valor como"1string"produciría1, ya que el dígito inicial se transfiere. - Resolución:
- Verifica la definición del esquema para el campo de destino afectado y confirma si su tipo de dato es
doubleu otro tipo de dato numérico. - Si el script de asignación puede devolver una cadena no numérica, añade una validación explícita para asegurar que solo valores numéricos se asignen a campos de destino numéricos, o cambia el tipo de dato del campo en el esquema.
- Verifica la definición del esquema para el campo de destino afectado y confirma si su tipo de dato es
Campos asignados en blanco con esquemas de origen planos
- Síntoma: Los campos de destino aparecen en blanco en la salida de la operación aunque los datos de origen contengan valores. Este problema ocurre específicamente al usar un esquema de origen plano. No ocurre con esquemas reflejados ni esquemas JSON.
- Posible causa: El modo de transformación de transmisión predeterminado procesa registros de manera incremental, lo que puede causar que los campos asignados no reciban valores cuando se usan con esquemas de origen planos.
-
Resolución:
-
Agregar un paso de script al inicio de la operación que desactive las transformaciones de transmisión estableciendo
jitterbit.transformation.auto_streamingenfalse:$jitterbit.transformation.auto_streaming = false; -
Desplegar y ejecutar nuevamente la operación. Para obtener más contexto sobre la transmisión y el procesamiento de transformaciones, consulta Procesamiento de transformaciones.
-
Funciones de archivo: La operación continúa después de un error en ArchiveFile o ReadFile
- Síntoma: Una operación se completa con un estado de éxito, pero los archivos no se archivaron o los datos no se leyeron como se esperaba. No aparece ningún error en el resultado de la operación, solo una advertencia en el registro de operación.
- Causa posible:
ArchiveFileyReadFiletienen comportamiento de fallo suave: si alguna de estas funciones falla, se interrumpe el script actual y se agrega una advertencia al registro de operación, pero la operación en sí no falla y los pasos posteriores continúan. A partir de la versión del agente 12.5, hay una excepción:ArchiveFilellamado condeleteSourceestablecido entruelanza un error capturable cuando no se puede eliminar el archivo de origen, en lugar de fallar silenciosamente. - Resolución:
- Verifica los registros de operación para ver mensajes de advertencia cuando una operación se realiza correctamente pero falta la salida de archivo esperada.
- Si el script debe detenerse ante un fallo de función de archivo, envuelve la llamada en una función
Evaly llama explícitamente aRaiseErrorpara promover la advertencia a un fallo de operación.
ReadFile: Lecturas parciales con contenido de archivo binario
- Síntoma: Un script que usa
ReadFilepara leer un archivo binario (como un ZIP o PDF) devuelve datos incompletos o dañados. - Causa posible:
ReadFileno es confiable con contenido de archivo binario y típicamente solo lee una parte de tales archivos. - Resolución: Usa
Base64EncodeFileen lugar deReadFilepara leer el contenido completo de un archivo binario como una cadena codificada en Base64.
El contenido de ReadFile con bytes no UTF-8 falla cuando se asigna a una carga XML o JSON UTF-8
-
Síntoma: Una transformación que mapea contenido de archivo sin procesar leído con
ReadFile(por ejemplo, un archivo EDI sin procesar) en un campo de destino XML o JSON con codificación UTF-8 falla durante la conversión de XML o JSON. Reemplazar el valor mapeado con una cadena codificada permite que la operación se complete, lo que confirma que el contenido sin procesar es el desencadenante. Los intentos de eliminar el carácter ofensivo usando su punto de código Unicode (por ejemplo,Replace($readFile, HexToString("2026"), "~")para la elipsisU+2026) no coinciden, y llamar aStringToHexen el contenido con soporte Unicode habilitado genera:not a UTF-8 string, byte not in range: 13 -
Causa: El contenido del archivo contiene un byte que no es válido en UTF-8 (por ejemplo, el byte único
0x85, que algunos archivos EDI usan como terminador de segmento). Este byte sin procesar no es lo mismo que la codificación UTF-8 multibyte de un carácter Unicode de aspecto similar (la elipsisU+2026se codifica como tres bytes), por lo que un reemplazo dirigido al punto de código Unicode nunca coincide. Conjitterbit.scripting.hex.enable_unicode_supportestablecido entrue, las funciones hexadecimales interpretan el contenido como UTF-8 y fallan en el byte inválido. -
Resolución: Coincide y reemplaza el byte sin procesar con el soporte Unicode hex deshabilitado, de modo que
HexToStringfuncione en bytes sin procesar en lugar de caracteres UTF-8:$jitterbit.scripting.hex.enable_unicode_support = false; $badByte = HexToString("85"); $readFile = Replace($readFile, $badByte, "~");Ajusta el valor hexadecimal (
85) al byte reportado porStringToHex($readFile)y la cadena de reemplazo (~) según sea necesario, luego mapea el valor desinfectado.
FlushFile / FlushAllFiles: Error cuando el archivo de destino ya existe
- Síntoma: Un script falla al intentar escribir un archivo en un destino que ya contiene un archivo con el mismo nombre.
- Causa posible:
FlushFileyFlushAllFiles(y por extensiónArchiveFile) generan un error si ya existe un archivo con el nombre de destino en el destino. - Resolución:
- Agrega una llamada a
DeleteFileoDeleteFilesantes de la operación de escritura para eliminar el archivo existente. - Alternativamente, usa un nombre de archivo dinámico que incluya una marca de tiempo o identificador único para evitar colisiones.
- Agrega una llamada a
DeleteFiles: Error cuando no se puede encontrar la ruta de origen
- Síntoma: Un script que usa
DeleteFilesfalla con un error cuando no se puede encontrar la ruta de origen o el directorio especificado. (Un filtro que no coincide con ningún archivo devuelve0en lugar de un error.) - Causa posible: Si no se puede encontrar la ruta de origen,
DeleteFilesgenera un error en lugar de devolver silenciosamente. Esto puede causar fallos de operación inesperados cuando el archivo a eliminar no existe. - Resolución: Envuelve la llamada a
DeleteFilesen una funciónEvalpara capturar el error y manejarlo sin que la operación falle.
GetJSONString: Ejecución interrumpida en ruta no válida
- Síntoma: Un script que llama a
GetJSONStringfalla cuando la ruta suministrada no se resuelve en el JSON (por ejemplo, el nodo está ausente o una matriz está vacía). El error es genérico y no identifica la ruta como la causa; cuando se invoca la operación a través de una API, puede aparecer como unProxy Error [502]engañoso devuelto a la persona que llama a la API. - Causa posible: Si el argumento
pathpasado aGetJSONStringes inválido o no coincide con ningún dato, la función interrumpe el flujo de ejecución inmediatamente y devuelve un error, lo que puede causar que todo el script se cancele. - Resolución:
- Valida la ruta JSON antes de pasarla a
GetJSONStringo (en versión de agente 11.59 / 12.3 o posterior) usaGetJSONStringEx, que devuelve un valor personalizable en lugar de interrumpir la ejecución cuando la ruta es inválida o no se encuentra. - Registra la carga útil JSON inmediatamente antes de la llamada a
GetJSONStringpara verificar la estructura real y confirmar la ruta.
- Valida la ruta JSON antes de pasarla a
Unmap no desmapea un campo cuando se usa junto con RunScript
-
Síntoma: La expresión de mapeo de un campo destino implica tanto
RunScriptcomoUnmap, pero el campo no se desmapea. Para un destino JSON o XML, el campo aparece en la salida con un valornullen lugar de omitirse. -
Posibles causas:
RunScriptprecede aUnmapen la misma expresión de mapeo (por ejemplo,RunScript("<TAG>script:MyScript</TAG>"); Unmap();). En versiones de agente anteriores a 12.9, esta combinación no desmaqueaba el campo.Unmapse llama desde dentro del script invocado porRunScript, en lugar de directamente en la propia expresión de mapeo del campo destino.RunScriptdevuelve el resultado del script llamado como una cadena en lugar de propagar una señal de desmapeo al mapeo, por lo que llamar aUnmapdesde dentro del script llamado no tiene efecto, en cualquier versión de agente, independientemente de cualquier lógica condicional alrededor de la llamada. Este es el comportamiento esperado.
-
Resolución:
- Si
RunScriptyUnmapse llaman ambos directamente en la expresión de mapeo del campo destino, actualiza a la versión 12.9 del agente o posterior. -
Si
Unmapse llama desde dentro del script invocado porRunScript, mueve la llamadaUnmapfuera del script llamado y al interior de la propia expresión de mapeo del campo destino, por ejemplo:RunScript("<TAG>script:MyScript</TAG>"); If(<condition>, Unmap(), <value>);
- Si
DBExecute: Error cuando auto_commit y transaction son ambos true
- Síntoma: Una operación que utiliza
DBExecutefalla con un error relacionado con configuraciones de transacción conflictivas. - Posible causa: Tanto
jitterbit.scripting.db.auto_commitcomojitterbit.scripting.db.transactionestán configuradas entrueen el script antes de la llamadaDBExecute. Estas dos configuraciones son mutuamente excluyentes y combinarlas causa un error. - Resolución: Decide si necesitas comportamiento de confirmación automática o control de transacción explícito, y luego configura solo la variable apropiada:
- Para confirmación automática (cada declaración confirmada inmediatamente): establece
$jitterbit.scripting.db.auto_commit = truey dejajitterbit.scripting.db.transactionsin establecer o enfalse. - Para control de transacción (confirmación al final de la transformación): establece
$jitterbit.scripting.db.transaction = trueyjitterbit.scripting.db.auto_commit = false.
- Para confirmación automática (cada declaración confirmada inmediatamente): establece
CallStoredProcedure: resultSet siempre nulo con controladores ODBC
- Síntoma: Un script que usa
CallStoredProceduredevuelvenullpara el parámetroresultSetaunque el procedimiento almacenado devuelve datos. - Causa posible: El parámetro
resultSetsolo es compatible con controladores de base de datos JDBC. Cuando el endpoint de base de datos usa un controlador ODBC,resultSetsiempre esnullsin importar lo que devuelva el procedimiento almacenado. - Resolución:
- Si se requiere el conjunto de resultados del procedimiento almacenado, cambia el endpoint de base de datos para usar un controlador JDBC en lugar de ODBC.
- Si no es posible cambiar de controlador, recupera los datos de salida a través de parámetros de salida en lugar del argumento
resultSet.
CallStoredProcedure: "No se encontró el procedimiento almacenado o función" con PostgreSQL JDBC
-
Síntoma: Un script que usa
CallStoredProcedurecontra una base de datos PostgreSQL falla con:CallStoredProcedure failed to execute call "<function-name>". java.sql.SQLException: Stored proc or function could not be found: <function-name> -
Causa posible: El controlador JDBC de PostgreSQL distingue entre funciones y procedimientos.
CallStoredProceduresiempre construye su llamada usando un patrón que el controlador interpreta como una búsqueda de un procedimiento. Si el objeto de base de datos es una función de PostgreSQL en lugar de un procedimiento, el controlador no puede localizarlo y devuelve el error "no encontrado". - Resolución:
- Determina si el objeto de base de datos que se está llamando es una función de PostgreSQL (devuelve un valor) o un procedimiento (sin valor de retorno).
-
Reemplaza
CallStoredProcedureconDBExecutey usa la sintaxis SQL correcta para el tipo de objeto:-
Función: usa
SELECT.$result = DBExecute("<TAG>Sources/My DB Connection</TAG>", "SELECT my_function(arg1, arg2)");DBExecutedevuelve un conjunto de resultados. Usa un bucleWhileconGetpara leer los valores devueltos. -
Procedimiento: usa
CALL.DBExecute("<TAG>Sources/My DB Connection</TAG>", "CALL my_procedure(arg1, arg2)");Los procedimientos de PostgreSQL no devuelven un valor; se puede descartar el valor devuelto de
DBExecute.
-
DBLoad: Requiere un controlador de base de datos JDBC
- Síntoma: Una operación que usa
DBLoadfalla o no produce salida cuando el endpoint de base de datos usa un controlador ODBC. - Causa posible:
DBLoadsolo funciona con endpoints de base de datos configurados para usar un controlador JDBC. No es compatible con controladores ODBC. - Resolución: Confirma que el endpoint de base de datos asociado con la actividad de destino usa un controlador JDBC. Si usa un controlador ODBC, cambia a JDBC.
AESDecryption falla con datos encriptados en OpenSSL 3
- Síntoma: Una operación que usa
AESDecryptionfalla o devuelve salida garbled al desencriptar datos que fueron encriptados usando OpenSSL 3. - Causa posible:
AESDecryptionusa un algoritmo AES heredado por defecto que no es compatible con la encriptación de OpenSSL 3. Cuando los datos encriptados se produjeron con OpenSSL 3, la desencriptación falla sin configuración adicional. - Resolución:
- Para agentes privados versión 11.42 o posterior, establece
jitterbit.scripting.aes.defaultentrueen un paso de script aguas arriba de la llamadaAESDecryptionpara habilitar la compatibilidad con OpenSSL 3. - Alternativamente, reemplaza
AESDecryptionconAESDecryptionEx, que es compatible con OpenSSL 3 por defecto en versiones de agente 11.42 o posterior.
- Para agentes privados versión 11.42 o posterior, establece
Actualizaciones de variables perdidas en operaciones multihilo fragmentadas
- Síntoma: Cuando una operación se ejecuta con segmentación habilitada y Max Number of Threads configurado a más de 1, las actualizaciones de variables globales o de proyecto realizadas durante la operación no se preservan completamente después de que se completa. Un caso posible es rellenar una variable de diccionario o matriz desde cada registro de origen y encontrar que contiene solo parte de los datos después (por ejemplo, aproximadamente la mitad de los registros cuando se ejecutan dos hilos). Esto puede ocurrir con conectores cuya configuración predeterminada utiliza más de un hilo, como las actividades de Salesforce, que tienen un valor predeterminado de 2 hilos.
- Posible causa: Cada hilo recibe su propia copia de las variables globales y de proyecto al inicio del procesamiento. Los cambios locales del hilo no se fusionan con el estado compartido. Solo se preservan los cambios realizados por el primer hilo cuando se completa la operación; los cambios de todos los demás hilos se descartan.
- Solución:
- Si la corrección es más importante que el rendimiento por operación, establece Max Number of Threads en
1. Cada segmento se procesa secuencialmente, por lo que las actualizaciones de variables no se dividen entre hilos. - Si se requiere rendimiento multihilo, no acumules estado por registro en una variable global o de proyecto. En su lugar, coloca la salida de cada hilo en un archivo único de Temporary Storage o en una tabla de base de datos de ensayo, luego consolida los resultados en una operación posterior de un solo hilo. Para un ejemplo práctico del patrón de ensayo, consulta Ámbito de variables con segmentación.
- De manera más general, no confíes en actualizaciones de variables globales o de proyecto de operaciones segmentadas y multihilo en scripts u operaciones posteriores. Si el estado de la variable debe preservarse, establece esas variables en un paso de operación no segmentado que se ejecute antes o después de la transformación segmentada. Para detalles sobre el comportamiento de segmentación con variables, consulta Usar variables con segmentación.
- Si la corrección es más importante que el rendimiento por operación, establece Max Number of Threads en
La transformación elimina registros duplicados cuando la salida es jerárquica
- Síntoma: Una transformación que lee un origen CSV y asigna a un formato de salida jerárquico (como JSON) descarta silenciosamente registros duplicados. Los registros con valores de campo idénticos aparecen solo una vez en la salida sin importar cuántas veces ocurran en el origen. La operación se completa exitosamente pero reporta menos registros de destino que registros de origen.
- Posibles causas:
- Al convertir datos de origen plano a un formato de salida jerárquico, el motor de transformación elimina registros duplicados durante la normalización. Los registros con valores idénticos después del análisis se tratan como duplicados y se mantiene solo una copia.
- Este comportamiento es específico de la salida jerárquica. Cuando el esquema de salida es plano, la normalización no se ejecuta y se escriben todos los registros.
- El motor de transformación también elimina espacios en blanco iniciales y finales de los valores de campo CSV de forma predeterminada. Los registros que difieren solo por espacios iniciales o finales se vuelven idénticos después del recorte y están sujetos a la misma deduplicación.
- Resolución:
- Habilita la fragmentación en las opciones de operación. La fragmentación procesa registros en lotes, lo que omite la normalización y preserva todos los registros incluyendo duplicados.
- Utiliza un esquema de salida plano en la transformación en lugar de uno jerárquico. La normalización no se aplica a la salida plana, por lo que se preservan todos los registros.
- Desactiva la normalización estableciendo una variable de Jitterbit en un paso de script antes de la transformación. Para transformaciones plano a plano, establece
jitterbit.transformation.disable_normalizationentrue. Para transformaciones plano a XML, establecejitterbit.transformation.flat_to_xml.disable_normalizationentrue(requiere agente 11.58 o posterior). Ambas variables pueden afectar otras transformaciones en la misma operación, así que prueba el cambio cuidadosamente. - Si los duplicados son causados específicamente por diferencias de espacios en blanco, establece
jitterbit.source.preserve_char_whitespaceentrueen un paso de script antes de la transformación. Esto preserva los espacios en blanco durante el análisis para que los registros afectados permanezcan distintos.
Los identificadores numéricos largos se corrompen en la salida de transformación
- Síntoma: Un valor numérico largo (por ejemplo, un número de seguimiento, número de cuenta o ID externo) se envía al destino con un valor incorrecto. El número es demasiado grande para caber en el tipo numérico implícito utilizado durante la asignación, por lo que se desborda y produce un valor incorrecto en el destino.
- Causa posible: El campo de origen o destino está tipado implícitamente como un tipo de dato numérico cuyo rango no puede contener el valor completo, causando un desbordamiento durante la conversión.
- Resolución:
- En la transformación, establece el tipo de dato del campo destino afectado como String en lugar de un tipo numérico. Los IDs largos que no se utilizan en operaciones aritméticas deben tratarse como cadenas.
-
Si el campo de origen también está tipado numéricamente, convierte el valor explícitamente con
Stringantes de asignarlo:String($source.numericId)
La salida de transformación JSON omite campos null y de cadena vacía
- Síntoma: Una transformación JSON elimina campos cuyo valor es
nullo una cadena vacía ("") de la carga útil de salida, incluso aunque esos campos estén asignados explícitamente. El sistema destino recibe una carga útil que no incluye los campos omitidos, lo que puede causar errores de validación aguas abajo cuando el destino requiere que los campos estén presentes. - Causa posible: El procesador de salida JSON omite campos con valores
nullo cadena vacía de forma predeterminada. - Resolución:
- En un paso de script anterior a la transformación, establece
jitterbit.target.xml.include_nil_attributeentrue. En la versión del agente 11.37 o posterior, esto incluye valoresnully cadenas vacías en la salida JSON, coincidiendo con la entrada. (A pesar delxmlen su nombre, esta variable se aplica a destinos JSON). - Si necesitas control total sobre qué campos aparecen en la carga útil, construye el cuerpo JSON en un paso de script utilizando concatenación de cadenas y envíalo a través de un conector HTTP v2 con un cuerpo de solicitud sin esquema.
- En un paso de script anterior a la transformación, establece
Los campos mapeados vacíos se convierten en xsi:nil="true" e invalidan una solicitud XML o SOAP
-
Síntoma: En una transformación XML o SOAP, un campo asignado con un valor vacío se emite como un elemento nil, y el punto final destino rechaza la solicitud. Por ejemplo, una asignación de número de teléfono vacío produce:
<ns1:Phone_Number xsi:nil="true"/>Algunos puntos finales (por ejemplo, los servicios SOAP de Workday) lo tratan como inválido y devuelven un error.
-
Causa: De forma predeterminada, cuando una asignación a un nodo destino resulta en un valor null o vacío, la transformación incluye el nodo pero lo marca como nil (
xsi:nil="true"). Esto se controla mediantejitterbit.target.xml.include_null_xml, cuyo valor predeterminado estrue. -
Resolución: En un paso de script anterior a la transformación, establece
$jitterbit.target.xml.include_null_xml = falsepara eliminar completamente de la salida los nodos con un valor null o vacío. Si en su lugar el nodo debe estar presente como un elemento vacío, utiliza las variables Jitterbit destino relacionadasjitterbit.target.xml.include_empty_xmlyjitterbit.target.xml.include_nil_attribute, que controlan si se incluyen valores vacíos y null en la salida.
La marca de orden de bytes (BOM) en un archivo de origen se transmite al valor del primer registro
- Síntoma: Cuando un archivo de origen (por ejemplo, un archivo CSV) comienza con una marca de orden de bytes UTF-8 (BOM), el primer campo del primer registro en la salida de transformación contiene un carácter adicional o inesperado que no forma parte de los datos de origen, en lugar del valor esperado. Los archivos exportados como CSV UTF-8 desde Microsoft Excel comúnmente incluyen este BOM.
- Causa posible: Studio lee el contenido de un archivo de origen tal cual y no detecta ni elimina un BOM inicial. Los bytes sin procesar del BOM se convierten en parte del valor del primer campo una vez que el archivo se analiza en registros.
- Resolución: Inspecciona el valor del campo afectado para identificar los caracteres exactos producidos por el BOM, luego asigna el campo usando
Replacepara eliminarlos. En la versión del agente 12.6 o anterior, donde UTF-8 no es el predeterminado, también puedes configurar explícitamente la codificación de caracteres a UTF-8 antes de que se ejecute la actividad de origen, por ejemplo$jitterbit.source.text.character_encoding = "utf-8";. La versión del agente 12.7 y posteriores utilizan UTF-8 de forma predeterminada.
Las variables de proyecto devuelven valores vacíos durante las pruebas de secuencias de comandos y transformaciones
- Síntoma: Al probar un paso de script o transformación en Studio, una variable de proyecto referenciada en el script o mapeo devuelve un valor vacío en lugar del valor configurado. La prueba puede fallar con un error no relacionado con la variable misma (por ejemplo, un tiempo de espera de conexión causado por una dirección de servidor en blanco).
- Posible causa: Los valores de las variables de proyecto se inyectan en tiempo de ejecución mediante la plataforma Harmony. Durante una prueba en tiempo de diseño, no existe un contexto de tiempo de ejecución para inyectar ese valor, por lo que una referencia de variable de proyecto devuelve un valor vacío a menos que la variable tenga un Valor predeterminado configurado para usar como alternativa. La resolución de conexión propia de una función es un caso separado que no utiliza el Valor predeterminado en absoluto; consulta Una función falla cuando su campo de conexión de endpoint se establece en una variable.
- Resolución:
- Establecer un valor predeterminado en la variable de proyecto: En la configuración de la variable de proyecto, ingresa el valor a usar durante las pruebas en el campo Valor predeterminado. Esta es la solución más simple para un valor configurado estático. Ten en cuenta que el valor predeterminado se usa siempre que la variable no haya sido establecida en tiempo de ejecución (no solo durante pruebas en tiempo de diseño), por lo que en tiempo de ejecución también actúa como alternativa cuando la variable no está configurada. Consulta Variables de proyecto para obtener detalles de configuración.
- Usar una variable global: Reemplaza la referencia de variable de proyecto con una variable global y asigna su valor dentro del script mismo, antes de la línea que la usa. Dado que una variable global obtiene su valor de la ejecución del script en lugar de la inyección en tiempo de ejecución, asignarla antes de su uso la hace disponible durante una prueba en tiempo de diseño. Prefiere esto cuando el valor se deriva en un script o cuando no deseas un valor alternativo en tiempo de ejecución. Consulta Variables globales para obtener detalles. Si la variable global se referencia en un campo de configuración del conector en lugar de directamente en un script, también debes definir un valor predeterminado por campo para ese campo (consulta Definir un valor predeterminado, que cubre tanto el método de píldora de variable como el método de sintaxis en línea para campos que no muestran una píldora).
Una función falla cuando el campo de conexión de su punto de conexión se establece en una variable
-
Síntoma: Probar un script (utilizando Ejecutar prueba) que llama a una función como
DBLookup,DBExecuteoSfLookupfalla, por ejemplo con:No suitable driver found for [...]o un error que indica un marcador de posición de variable sin resolver en la dirección del endpoint. El mismo script se ejecuta correctamente cuando se implementa y ejecuta en una operación.
-
Posible causa: La conexión utilizada por la función tiene un campo (como Inicio de sesión, Contraseña, Cadena de conexión o una dirección de servidor) establecido en una variable global o de proyecto. Probar un script ejecuta solo el script probado, por lo que la variable aún no ha recibido su valor en tiempo de ejecución cuando la función resuelve la conexión. A diferencia de una variable referenciada directamente en un campo configurado de una actividad, esto no está cubierto por el Valor predeterminado de una variable; una función como estas no lee el valor predeterminado al resolver una conexión. Para una variable referenciada directamente en un script o mapeo en su lugar, donde un Valor predeterminado sí resuelve el problema, consulta Las variables de proyecto devuelven valores vacíos durante pruebas de script y transformación.
-
Resolución: Antes de la llamada de función, asigna temporalmente la misma variable global o de proyecto su valor real directamente dentro del script probado (por ejemplo,
$login = "value";para una variable llamadalogin), luego elimina la asignación antes de implementar la operación.
IsNull devuelve false para cadenas vacías de datos de origen JSON
- Síntoma:
IsNulldevuelvefalsepara un campo asignado desde una fuente JSON, incluso cuando el campo parece no tener valor. La lógica descendente que depende de la verificación de nulo se comporta inesperadamente o produce resultados incorrectos. - Causa posible: JSON distingue entre un valor ausente o explícitamente
nully una cadena vacía (""). Un campo establecido en""en JSON es una cadena vacía, no nulo, por lo queIsNullcorrectamente devuelvefalsepara él. A partir del agente 11.37, el agente preserva esta distinción con precisión. Los scripts o transformaciones que anteriormente confiaban en queIsNulldevolvieratruepara cadenas vacías dependían de un comportamiento anterior que ya no es correcto. -
Resolución:
-
Usa
IfEmptypara manejar tanto nulo como cadenas vacías: La funciónIfEmptydevuelve un valor predeterminado cuando el argumento es nulo o una cadena vacía, y es el reemplazo recomendado para este escenario:// Devuelve "default" si el campo es nulo o una cadena vacía result = IfEmpty($myField, "default"); -
Usa
Lengthpara verificar cadenas vacías explícitamente: Si solo necesitas verificar si una cadena está vacía (no nula), usaLength($myField) == 0. - Corrige los datos de fuente: Si la fuente JSON debe indicar que no hay valor, actualízala para enviar
"field": nullu omite completamente el campo en lugar de"field": "".
-
Comparar una variable de cadena con el número 0 devuelve inesperadamente true
- Síntoma: Una comparación como
$myVar == 0devuelvetrueincluso cuando$myVarcontiene una cadena no numérica (por ejemplo,"test"). Las condicionesIfy otras lógicas que verifican cero producen resultados inesperados. - Causa posible: Cuando Jitterbit Script compara valores de diferentes tipos de datos, intenta convertir ambos operandos a dobles como paso final. Cuando se aplica a una cadena no numérica, la conversión falla y devuelve
0como valor predeterminado. La comparación luego se evalúa como0 == 0, que estrue. -
Resolución:
-
Asegúrate de que ambos lados de la comparación utilicen el mismo tipo de dato. Si la intención es verificar si una variable de cadena contiene el valor
"0", compara contra el literal de cadena"0"en lugar del entero0:// Compares string to integer: non-numeric strings coerce to 0 and match unexpectedly If($myVar == 0, ...) // Compares string to string: behaves as expected If($myVar == "0", ...) -
Si se espera que la variable contenga un valor numérico, asegúrate de que se asigne como número en lugar de cadena antes de la comparación.
-
La aritmética decimal produce resultados inesperados de punto flotante
- Síntoma: Una expresión aritmética que incluye literales decimales produce un resultado que es ligeramente diferente del valor esperado. Por ejemplo,
Double(12.01) - Double(12.00)devuelve0.00999999999999979en lugar de0.01, y(4.9 * 100) - 490se evalúa a5.6843418860808e-14en lugar de0. - Causa posible: Jitterbit Script almacena números como valores de punto flotante. La mayoría de fracciones decimales no pueden representarse exactamente en punto flotante binario, por lo que la aritmética sobre ellas puede acumular pequeños errores de redondeo. La resta que cancela la mayoría de un valor expone este residuo. Convertir explícitamente valores como
Doubleno previene esto: especifica el tipo de dato pero no cambia cómo se almacena o computa el valor. - Resolución:
- Aplica
Roundal resultado: UsaRoundcon el número de decimales requerido para el cálculo:
- Aplica
$a = Round(Double(12.01) - Double(12.00), 2); // devuelve 0.01
-
Convertir literales decimales usando
Float: Envuelve el literal decimal enFloatantes del cálculo:$a = (Float(4.9) * 100) - 490; WriteToOperationLog($a);
Las funciones de fecha devuelven medianoche en lugar de un valor de solo fecha
- Síntoma: Después de actualizar a la versión 12.8 del agente o posterior,
ConvertTimeZone,DateoGeneralDatedevuelven una cadena de fecha y hora completa (por ejemplo,2026-01-01 00:00:00) para una entrada de exactamente medianoche, en lugar de una cadena solo de fecha (2026-01-01), lo que puede interrumpir la lógica posterior que espera el formato más corto.CVTDateno se ve afectada. - Posible causa: Con los agentes de versión 12.8 y posterior, estas funciones tratan la medianoche (
00:00:00) como un valor de hora válido y la preservan en el valor devuelto, de la misma manera que cualquier otra hora. Anteriormente, un valor de exactamente medianoche se truncaba a una cadena solo de fecha, mientras que cualquier otra hora se preservaba correctamente. - Resolución: Si la lógica posterior requiere un valor solo de fecha, usa
FormatDatepara formatear explícitamente el resultado en lugar de depender del formato de salida predeterminado de la función.
El valor en caché expira más pronto de lo esperado
- Síntoma: Un valor escrito en la caché con una expiración larga (por ejemplo, 24 horas) desaparece mucho antes de que transcurra ese tiempo, o expira después de 30 minutos independientemente de lo que se haya establecido en
WriteCache. - Posible causa: Cada llamada a
ReadCacherestablece la expiración del elemento almacenado a 30 minutos (1800 segundos) a menos que se proporcione explícitamente el parámetroexpirationSeconds. La expiración deWriteCachesolo se aplica en el momento de la escritura; las lecturas posteriores sin una expiración explícita acortan silenciosamente la vida útil restante. -
Resolución:
-
Especifica la expiración en
ReadCache: Pasa el número deseado de segundos como parámetroexpirationSecondspara preservar o extender la vida útil del valor en caché en cada lectura:// Restablece la expiración a 24 horas en cada lectura testVal = ReadCache("CacheTest", 86400, "env"); -
Pasa
-1para preservar la expiración de escritura: Al pasar un valor no positivo,ReadCacheretiene la expiración establecida por la llamada más reciente aWriteCacheen lugar de aplicar una nueva:testVal = ReadCache("CacheTest", -1, "env");
-
RunXSLT falla con "XML version must be 1.0 or 1.1"
-
Síntoma:
RunXSLTfalla con el error:Failed to execute xslt. XML version must be 1.0 or 1.1aunque el archivo XML de entrada contiene una declaración válida de
<?xml version="1.0"?>. -
Posible causa: La hoja de estilos XSLT está configurada para producir salida HTML (por ejemplo,
<xsl:output method="html"/>).RunXSLTsolo admite XML como salida. Cuando la hoja de estilos produce HTML, la función genera un resultado vacío, que desencadena este error. El mensaje de error se refiere a la declaración XML faltante en la salida (vacía), no al XML de entrada. -
Solución:
-
Actualiza el XSLT para producir salida XML: Cambia la declaración de salida de la hoja de estilos a
<xsl:output method="xml"/>, o elimina la declaraciónxsl:outputpor completo (XML es el valor predeterminado). Este es el enfoque recomendado y funciona tanto en agentes en la nube como en agentes privados. -
Usa el plugin XSL Transform (solo agentes privados): Para grupos de agentes privados, el plugin XSL Transform deprecado utiliza el procesador XSLT Saxon y admite formatos de salida que no son XML, incluyendo HTML. Consulta Plugins disponibles para obtener detalles de instalación.
-
SelectSingleNode devuelve el nodo incorrecto cuando se utiliza con un elemento de matriz SelectNodes
- Síntoma:
SelectSingleNodedevuelve datos del elemento incorrecto (por ejemplo, siempre la primera coincidencia en el documento) cuando se llama en un elemento recuperado de una matrizSelectNodes. - Causa posible: Usar una expresión XPath absoluta (que comienza con
//) como argumento de ruta hace queSelectSingleNodebusque desde la raíz del documento XML original en lugar de hacerlo de forma relativa al nodo actual. Una expresión como"//Item/ItemName"coincide con el primerItemNameen cualquier lugar del documento, independientemente del elementoItemque se haya recuperado de la matriz. -
Solución:
-
Usa una ruta relativa: Omite los
//iniciales y especifica solo el nombre del elemento o una ruta relativa al nodo actual. Esto limita la búsqueda al nodo pasado como primer argumento:$itemName = SelectSingleNode($item, "ItemName"); -
Alternativa: envuelve el nodo en
String: Convertir el elemento de la matriz a una cadena antes de pasarlo aSelectSingleNodetambién produce el resultado correcto, aunque usar una ruta relativa es el enfoque preferido:$item = String($items[2]); $itemName = SelectSingleNode($item, "//Item/ItemName");
-
La salida de HexToBinary aparece sin cambios cuando se registra
- Síntoma:
HexToBinaryparece no tener efecto: el valor escrito en el registro de operaciones se ve idéntico a la entrada hexadecimal, lo que sugiere que la conversión no ocurrió. - Causa posible:
WriteToOperationLogno puede enviar datos binarios sin procesar. Cuando recibe un valor binario, lo convierte de vuelta a hexadecimal para mostrarlo. El mismo comportamiento se aplica en la ventana de prueba de script. La conversión funciona correctamente; solo la visualización se ve afectada. -
Solución: Para trabajar con o verificar la salida binaria, escríbela en un archivo usando
WriteFile. Por ejemplo:WriteFile("<TAG>activity:ftp/FTP Endpoint/ftp_write/Write</TAG>", HexToBinary("1A3F"));
SortArray ordena nombres de archivos lexicográficamente, no cronológicamente
- Síntoma:
SortArraydevuelve nombres de archivo en orden alfabético en lugar del orden cronológico esperado cuando los nombres de archivo contienen cadenas de fecha u hora incrustadas. - Causa posible:
SortArrayrealiza una ordenación de cadena (lexicográfica). Para un nombre de archivo comoordall_DDMMYYHHMMSS.txt, la parte del día precede a la parte del año en la cadena, por lo que una ordenación alfabética no coincide con una ordenación basada en fecha. - Solución:
- Si controlas la convención de nombres de archivo, cambia a un formato que se ordene correctamente cuando se ordena alfabéticamente, como
YYYY-MM-DD_HHMMSS_filename.txt. Esta es la solución más simple y confiable. - Si el formato del nombre de archivo no puede cambiar, analiza la porción de fecha de cada nombre de archivo en una clave ordenable (por ejemplo,
YYYYMMDDHHMMSS) y ordena según la clave analizada en lugar del nombre de archivo sin procesar.
- Si controlas la convención de nombres de archivo, cambia a un formato que se ordene correctamente cuando se ordena alfabéticamente, como
URLEncode no codifica ciertos caracteres "seguros" o multibyte
- Síntoma: Un valor que pasa a través de
URLEncodese envía al destino con algunos caracteres sin codificar, lo que causa que el sistema receptor rechace la solicitud o malinterprete el valor. Esto afecta comúnmente a credenciales o valores de consulta que contienen caracteres como$,+o!. - Posibles causas:
URLEncodesigue RFC 1738 y trata estos caracteres como "seguros", por lo que nunca los codifica:$ - _ . + ! * ' ( ) ,. Un destino que espera que estos caracteres estén codificados en porcentaje recibe el carácter sin procesar en su lugar.- La compatibilidad con caracteres multibyte en
URLEncoderequiere la versión 12.4 del agente o posterior. En agentes anteriores, los caracteres multibyte pueden no codificarse como se espera.
-
Resolución:
-
Cuando sea necesario codificar caracteres "seguros" (por ejemplo, en una contraseña de OAuth o en un valor que contiene
+), usa la funciónencodeURIComponentde JavaScript en un paso de script de JavaScript en lugar deURLEncode:<javascript> $my_username = "$Example+User"; $loginValue = encodeURIComponent($my_username); </javascript>Esto devuelve
%24Example%2BUser. -
Para codificar caracteres multibyte con
URLEncode, confirma que el agente está en la versión 12.4 o posterior.
-
JavaScript: error "Call to Jitterbit Tomcat failed"
-
Síntoma: Un paso de JavaScript complejo o de larga duración falla con un error genérico que hace referencia a Tomcat, incluso aunque los servicios de Jitterbit Apache y Jitterbit Tomcat en el agente estén ejecutándose. El script puede tener éxito cuando se reduce su complejidad (por ejemplo, al disminuir los conteos de iteración o la profundidad de recursión).
Call to Jitterbit Tomcat failed (null response). Make sure the Jitterbit Apache and Jitterbit Tomcat services are both running. Failed to execute script -
Posible causa: JavaScript profundamente recursivo puede exceder el límite de profundidad de recursión del motor de JavaScript del agente, produciendo un desbordamiento de pila que se manifiesta como este error genérico de Tomcat. Este límite de recursión es intencional. El script típicamente se completa una vez que se reduce la profundidad de recursión.
- Resolución:
- Reduce la profundidad de recursión o reescribe la lógica recursiva como un bucle iterativo.
- Si el algoritmo no puede evitar recursión profunda, usa un enfoque que no dependa de ella.
- Ten en cuenta que el límite de iteración de bucle separado por script (
JavaScriptMaxIterations, consulta Límite de iteración de bucle de script excedido) no aumenta el techo de recursión, que no se expone como una configuración personalizable.
JavaScript: cambios de variable global perdidos en caso de fallo de secuencia de comandos
- Síntoma: Un script de JavaScript que modifica variables globales se ejecuta sin error aparente en algunos casos, pero los cambios en esas variables globales están ausentes en scripts u operaciones posteriores.
- Posibles causas:
- En JavaScript, los cambios en variables globales se confirman solo cuando el script se completa correctamente. Si el script falla en cualquier punto, todos los cambios de variables globales realizados durante esa ejecución se descartan.
- Mezclar la sintaxis
$variableconJitterbit.SetVar/Jitterbit.GetVarpara la misma variable dentro de un script de JavaScript puede causar un comportamiento en tiempo de ejecución impredecible.
- Resolución:
- Estructura los scripts de JavaScript de modo que todas las asignaciones de variables globales ocurran después de la lógica que podría fallar, o usa manejo de errores para prevenir fallos a mitad del script.
- Para cualquier variable dada en un script de JavaScript, usa la sintaxis
$variableoJitterbit.SetVar/Jitterbit.GetVar, nunca ambas. Elige una y úsala consistentemente en todo el script. - Para confirmar qué variables se están estableciendo, agrega llamadas a
WriteToOperationLogpara registrar valores de variables en puntos clave durante la ejecución.
JavaScript: GetVar devuelve null para variables de proyecto definidas por el usuario
- Síntoma: Llamar a
Jitterbit.GetVaren una variable de proyecto definida por el usuario en un paso de script de JavaScript devuelvenullen lugar del valor de la variable, sin mensaje de error. - Causa posible:
Jitterbit.GetVaryJitterbit.SetVarestán destinados a variables del sistema de Jitterbit (por ejemplo,jitterbit.operation.name) y a nombres de variables que contienen un punto, que la notación de punto de JavaScript no puede referenciar directamente. No leen variables de proyecto ordinarias definidas por el usuario cuyos nombres no contienen punto; pasar tal nombre aGetVardevuelvenull. En su lugar, referencia esas variables directamente con$nombre. Estas funciones también convierten todos los valores a cadenas, por lo que no son apropiadas para arreglos u objetos, y un valor establecido conSetVarse puede leer nuevamente conGetVardentro del mismo script, pero no persiste en scripts posteriores. -
Resolución: Usa la sintaxis
$nombreVariabledirectamente en JavaScript para acceder a variables de proyecto y globales definidas por el usuario cuyos nombres no contienen punto. ReservaGetVarySetVarpara variables del sistema de Jitterbit y para variables cuyos nombres contienen punto (por ejemplo,$hola.mundo), a las que la notación de punto de JavaScript no puede acceder directamente. Para una variable determinada, usa$-prefijo oGetVar/SetVar, no ambos. Consulta también JavaScript: cambios en variables globales perdidos en caso de falla del script.// Correct: access a user-defined project variable directly var value = $myProjectVar; // Incorrect for user-defined variables without periods: var value = Jitterbit.GetVar("$myProjectVar"); // returns null
Cargar un archivo de esquema lo reemplaza en todo el proyecto
- Síntoma: Después de cargar un nuevo archivo de esquema durante la configuración de la transformación, otras transformaciones en el proyecto que usaban el mismo esquema ahora se comportan de manera inesperada o producen errores.
- Causa posible: Cuando se carga un archivo con el mismo nombre que un archivo de esquema existente ya definido en el proyecto, Studio muestra un diálogo ¿Sobrescribir archivo?. Si se hace clic en Continuar, el archivo existente se reemplaza en cada ubicación donde se usa. Este reemplazo es en todo el proyecto, no limitado a la transformación actual.
- Resolución:
- Antes de cargar un archivo de esquema de reemplazo, confirma si el esquema existente se comparte: abre el esquema para editarlo y si lo referencia más de un componente, Studio muestra un diálogo Esquema utilizado por múltiples componentes listándolos (consulta Actualizar esquemas definidos por transformación). Evalúa el impacto en todos los componentes listados antes de continuar.
- Si solo una transformación debe usar el esquema actualizado, haz clic en Cancelar en el diálogo ¿Sobrescribir archivo? (o renombra el nuevo archivo antes de cargarlo) para que no sobrescriba el archivo compartido.
La implementación de una plantilla de proceso de Marketplace falla debido a una falta de coincidencia de esquema
- Síntoma: Un proyecto importado de una plantilla de proceso de Marketplace no se implementa o produce errores en tiempo de ejecución porque faltan campos en una transformación o falla la validación de actividades de origen y destino.
- Causa posible: Las plantillas de proceso se desarrollan contra una instancia de endpoint específica. Si tu instancia difiere (por ejemplo, si tu organización de Salesforce o NetSuite tiene campos personalizados o estándar diferentes), es posible que los esquemas insertados en las transformaciones de la plantilla no coincidan con tu endpoint.
- Resolución:
- En la transformación afectada, abre la configuración de esquema y haz clic en el icono de actualización (o la palabra Actualizar) para regenerar el esquema desde tu endpoint conectado.
- Si el esquema aún no coincide después de actualizar, borra el esquema existente y duplica uno nuevo desde un archivo de muestra actual o directamente desde el endpoint.
- Reasigna los campos que se agregaron o eliminaron durante la regeneración del esquema.
- Reimplementa el proyecto y vuelve a ejecutar la operación para confirmar que el problema se resolvió.
Studio se vuelve lento o no responde con proyectos muy grandes
- Síntoma: Studio responde lentamente cuando un único flujo de trabajo contiene un número muy grande de operaciones, o al guardar un script muy grande.
- Causa posible: El lienzo de diseño renderiza todas las operaciones en el flujo de trabajo activo a la vez, por lo que un flujo de trabajo con un número muy grande de operaciones exige mucha memoria del navegador.
- Resolución:
- Divide flujos de trabajo grandes en subflujos de trabajo más pequeños y vinculados. Studio renderiza solo el lienzo del flujo de trabajo activo, por lo que tener menos operaciones por flujo de trabajo mejora la capacidad de respuesta. Usa acciones de operación para encadenar subflujos de trabajo juntos.
- Si la lentitud ocurre específicamente al guardar un script grande, divide el script en scripts más pequeños y llámlos usando
RunScript.
Amazon Bedrock: error de modelo "on-demand throughput isn't supported"
-
Síntoma: Una actividad de Amazon Bedrock falla con:
Invocation of model ID <model-name> with on-demand throughput isn't supported. Retry your request with the ID or ARN of an inference profile that contains this model. -
Posible causa: Algunos modelos, incluyendo los modelos GPT-5.6 de OpenAI, no admiten rendimiento bajo demanda y requieren el ID de un perfil de inferencia entre regiones en lugar del ID del modelo que se devuelve en la lista Seleccionar un modelo de la actividad.
- Resolución:
- En la Consola de Administración de AWS, ve a Amazon Bedrock > Perfiles de inferencia y busca el ID del perfil de inferencia para el modelo. Por ejemplo, el ID del perfil de inferencia para
anthropic.claude-3-5-haiku-20241022-v1:0en EE. UU. esus.anthropic.claude-3-5-haiku-20241022-v1:0. Para los modelos GPT-5.6 de OpenAI, los prefijos de ID de perfil de inferencia válidos varían según el modelo y la región (por ejemplo,us.oglobal.), comous.openai.gpt-5.6-terraoglobal.openai.gpt-5.6-terra. Para obtener el ID exacto del perfil de inferencia para tu modelo y región, consulta las tarjetas de modelo de AWS para GPT-5.6 Sol, GPT-5.6 Terra y GPT-5.6 Luna. - Ingresa el ID del perfil de inferencia utilizando la opción Ingresar identificador de modelo en la configuración de la actividad.
- En la Consola de Administración de AWS, ve a Amazon Bedrock > Perfiles de inferencia y busca el ID del perfil de inferencia para el modelo. Por ejemplo, el ID del perfil de inferencia para
Cloud Datastore: La actividad Query Items no devuelve todos los registros coincidentes al filtrar por múltiples valores del mismo campo
- Síntoma: Una actividad Query Items utilizada para buscar varios registros específicos a la vez (por ejemplo, por una lista de valores de
Key) devuelve solo un registro, aunque todos los registros existan en el almacenamiento y se puedan confirmar en la página Cloud Datastore de Management Console. - Causa posible: El filtro de la consulta combina varias condiciones en el mismo campo (por ejemplo, varios valores de
Keydiferentes en un solo filtro). Las condiciones de filtro de Cloud Datastore solo se pueden combinar cuando cada condición especifica un campo diferente; un filtro no puede especificar el mismo campo más de una vez, y no se puede aplicar más de una condición u operador al mismo campo. - Resolución: Ejecuta una llamada Query Items separada para cada valor en lugar de combinar varios valores del mismo campo en un solo filtro. Para obtener más detalles sobre las condiciones de filtro compatibles, consulta Actividad Query Items.
Cloud Datastore: La actividad Delete Items reporta éxito pero no elimina el registro
- Síntoma: Una actividad Delete Items de Cloud Datastore reporta éxito en el registro de operaciones, pero el registro de destino sigue existiendo cuando se consulta después.
- Causa posible: Delete Items identifica los registros por el valor de Key (o Alternative Key) del almacenamiento, suministrado en el array
keysoidsde la solicitud. (Ambos arrays aceptan valores de clave o clave alternativa.) Si se suministra el ID interno del registro en lugar de su valor de clave, ningún elemento coincide, y la actividad reporta éxito sin eliminar nada. - Resolución:
- En la transformación que prepara la solicitud Delete Items, asigna el valor de Key (o Alternative Key) del almacenamiento, no el ID de registro interno.
- Cuando encadenas desde una actividad Query Items, asigna el valor
keyde la respuesta de consulta a la solicitud de eliminación.
Coupa: La autenticación por clave API devuelve 403 Forbidden
- Síntoma: Una operación de conector Coupa falla con un error
Forbidden (403)al utilizar autenticación de clave API. - Causa posible: A partir de la versión de Coupa R35 (enero de 2023), las claves API de Coupa están deprecadas y ya no se admiten para la autenticación. Las conexiones configuradas para utilizar autenticación de clave API reciben un error 403.
- Resolución:
- En la configuración de conexión de Coupa, cambia de autenticación de clave API a autenticación OAuth 2.0.
- En tu instancia de Coupa, crea una aplicación cliente OAuth 2.0 y obtén las credenciales del cliente.
- Actualiza la configuración de conexión con las credenciales de OAuth 2.0, guarda y realiza una nueva prueba.
Base de datos (JDBC): DBLookup o DBExecute falla con un error de decodificación Base64
-
Síntoma: Una función
DBLookupoDBExecutedirigida a una base de datos PostgreSQL o SQL Server a través de un controlador JDBC falla en tiempo de ejecución con:Base64 decoding failed. Reason: error:00000000:lib(0)::reason(0)Esto ocurre siempre que el valor devuelto se asemeja a datos codificados en Base64, como un JWT u otro token de acceso, aunque la misma consulta tenga éxito cuando se ejecuta directamente contra la base de datos.
-
Causa posible: Las versiones del agente anteriores a la 12.9 pueden intentar incorrectamente decodificar en Base64 un valor de resultado JDBC que coincida con un patrón similar a Base64, independientemente de si el valor es realmente datos codificados en Base64.
-
Resolución:
- Para agentes privados, actualiza a la versión 12.9 o posterior. Los agentes en la nube reciben la actualización automáticamente.
- Si no puedes actualizar inmediatamente, evita activar la verificación Base64 convirtiendo el valor afectado a hexadecimal en la consulta SQL y luego decodificándolo en un paso de script usando
HexToString. Por ejemplo, en PostgreSQL:SELECT encode(<column>, 'hex'). Usa el equivalente SQLdecode(...,'hex')conStringToHexcuando escribas el valor de vuelta en la base de datos.
Base de datos (ODBC): Los caracteres multibyte no se manejan correctamente
- Síntoma: Al leer o escribir en una base de datos a través del conector de base de datos usando un controlador ODBC, los caracteres multibyte o no ASCII (por ejemplo, caracteres acentuados o no latinos) no se manejan correctamente.
- Causa posible: La compatibilidad de caracteres multibyte para el conector de base de datos sobre un controlador ODBC no está habilitada de forma predeterminada. La variable de Jitterbit
jitterbit.scripting.db.multibyte.enabledebe establecerse entrue. Esta compatibilidad está disponible en la versión 12.6 del agente y posteriores, y no es necesaria cuando se usa un controlador JDBC. -
Resolución:
- Confirma que el agente sea versión 12.6 o posterior.
-
Establece la variable
jitterbit.scripting.db.multibyte.enableentrueantes de que se ejecute la operación de base de datos. Por ejemplo, en un paso de script:$jitterbit.scripting.db.multibyte.enable = true;
Alternativamente, usa un controlador JDBC para la conexión de base de datos, que maneja caracteres multibyte sin esta variable.
Base de datos: La conexión está bloqueada por la política de seguridad
-
Síntoma: La prueba de conexión de un conector de base de datos falla con:
HttpErrorResponse: The database connection could not be established due to a security policy violation.con una línea de detalles que especifica una conexión de bucle invertido:
Details: java.lang.IllegalArgumentException - JDBC connections to loopback addresses are not permitted.o un parámetro de cadena de conexión específico:
Details: java.lang.IllegalArgumentException - JDBC connection parameter 'allowmultiqueries' cannot be enabled. -
Causa posible: La versión 12.10 del agente y posteriores restringen de forma predeterminada ciertas conexiones de base de datos y parámetros de cadena de conexión por seguridad. Esto incluye conexiones a
localhosto127.0.0.1y parámetros específicos de cadena de conexión para los controladores MySQL, PostgreSQL, Oracle y SQL Server. Una conexión que funcionaba anteriormente puede fallar después de actualizar un agente privado a la versión 12.10, porque la restricción se aplica de forma predeterminada aunque la sección[JdbcSecurity]no se agregue automáticamente a un archivojitterbit.confexistente. -
Resolución: En un agente privado, configura la sección
[JdbcSecurity]del archivo de configuración del agente (jitterbit.conf) para permitir la conexión específica o el parámetro que necesitas; después reinicia el agente.
Base de datos: Los tiempos de espera de conexión se agotan bajo carga
-
Síntoma: Las operaciones de origen o destino de base de datos fallan intermitentemente bajo carga concurrente pesada, con una excepción similar a:
java.sql.SQLException: Network error IOException: Connection timed out Caused by: java.net.ConnectException: Connection timed out -
Posible causa: Cada operación de base de datos abre una nueva conexión JDBC física y la cierra después, en lugar de reutilizar una existente. Bajo carga concurrente, esto genera suficiente cambio de conexiones contra la base de datos de destino que algunos intentos de conexión se agotan.
-
Resolución: El agente versión 12.11 y posteriores pueden agrupar y reutilizar conexiones en lugar de abrir y cerrar una para cada operación, lo que reduce este cambio. En un agente privado, establece
jdbc.hikari.enabled=trueen la sección[SourceTargetPooling]del archivo de configuración del agente (jitterbit.conf); después reinicia el agente.
Base de datos: Errores de longitud de campo en Insert, Update o Upsert
-
Síntoma: Una actividad Insertar, Actualizar o Actualizar/Insertar de Base de datos falla con un estado de operación Error cuando un valor de origen asignado es más largo de lo que permite la columna de destino. El registro de operación contiene uno de los siguientes:
One or more values were truncated when inserting and/or updating the fieldField value too long FieldName: m_site Length: 3 Length Allowed: 1 -
Posible causa: De forma predeterminada, si un valor de origen asignado excede la longitud definida de la columna de destino, la actividad rechaza la fila y reporta un estado Error en lugar de truncar el valor.
- Resolución:
- En la configuración de la actividad Insertar, Actualizar o Actualizar/Insertar de base de datos, habilita Permitir truncamiento de campos de caracteres para evitar errores de longitud de campo. Con esta opción habilitada, los valores que exceden la longitud del campo de destino se truncan y la operación reporta un estado Éxito con información en lugar de Error.
- Si el truncamiento no es aceptable, recorta o transforma el campo de origen en la asignación de transformación para que los valores nunca excedan la longitud de la columna de destino, o amplía la columna de destino en el lado de la base de datos.
- Redespliega y vuelve a ejecutar la operación.
Base de datos: El archivo JAR del controlador JDBC se sobrescribe al actualizar el agente
- Síntoma: Los archivos JAR del controlador JDBC personalizado instalados para el conector de base de datos se eliminan o sobrescriben cuando se actualiza el agente.
- Posible causa: Solo el directorio
<JITTERBIT_HOME>/tomcat/drivers/lib/se conserva entre actualizaciones del agente. Los archivos JAR de controlador personalizado colocados en otros lugares de los directorios del agente son parte de la implementación administrada y pueden eliminarse o sobrescribirse durante una actualización. - Resolución:
- Coloca los archivos JAR del controlador JDBC personalizado en
<JITTERBIT_HOME>/tomcat/drivers/lib/en su lugar. Este directorio se conserva durante las actualizaciones del agente. - Si los controladores están actualmente en la ubicación incorrecta, muévelos al directorio correcto y reinicia el agente.
- Coloca los archivos JAR del controlador JDBC personalizado en
Base de datos: Los caracteres especiales en nombres de columnas causan fallos en consultas
- Síntoma: Las consultas de Base de datos o las transformaciones fallan cuando una tabla de origen tiene nombres de columna que contienen caracteres especiales como
@. - Causa posible: Los controladores ODBC no pueden manejar ciertos caracteres especiales en los nombres de columna de la base de datos.
- Resolución:
- Crea una vista de base de datos en la tabla física que exponga la columna afectada con un nombre que no contenga caracteres especiales.
- Apunta la actividad de Base de datos a la vista en lugar de la tabla original.
Base de datos: La sentencia SQL excede el límite de 2,000 caracteres
- Síntoma: Una actividad de Consulta de Base de datos falla o se trunca cuando la sentencia SQL configurada es muy larga.
- Causa posible: El campo de sentencia SQL en una actividad de Consulta de Base de datos acepta un máximo de 2,000 caracteres.
- Resolución:
- Crea una vista de base de datos que encapsule la lógica de consulta compleja.
- Referencia el nombre de la vista en la actividad de Consulta en lugar de la sentencia SQL completa.
IBM DB2 en iSeries: La conexión JDBC falla
- Síntoma: Una conexión de Base de datos a IBM DB2 en iSeries (AS/400 o IBM i) usando un controlador JDBC no se conecta.
- Causa posible: Algunas conexiones a DB2 en iSeries usando un controlador JDBC encuentran problemas que no ocurren con un controlador ODBC.
- Resolución: Cambia la conexión para usar un controlador ODBC en lugar de JDBC. Las conexiones ODBC son compatibles solo con agentes privados.
IBM DB2: Configuración del controlador JDBC JCC (archivo JAR y licencia obsoletos)
- Síntoma: Una conexión de Base de datos que usa el controlador JDBC JCC de IBM DB2 falla con un error que hace referencia a una licencia faltante, o falla o produce errores de compatibilidad con versiones más recientes de DB2.
- Causas posibles:
- El archivo de controlador
db2jcc.jarimplementa la especificación JDBC 3 obsoleta. El actualdb2jcc4.jarimplementa JDBC 4, que las versiones más recientes de DB2 requieren. - El controlador JCC requiere un archivo JAR de licencia separado. El archivo JAR del controlador por sí solo no es suficiente.
- El archivo de controlador
- Resolución:
- Usa el controlador
db2jcc4.jar, no el obsoletodb2jcc.jar. Instálalo en<JITTERBIT_HOME>/tomcat/drivers/lib/en el agente privado. - Obtén el archivo JAR de licencia de IBM (llamado
db2jcc_license_cisuz-XX.jar, dondeXXes el número de versión) y cópialo a<JITTERBIT_HOME>/tomcat/shared/lib/. - También puedes usar la biblioteca de código abierto JTOpen (también conocida como controlador AS400), que no requiere el controlador JCC ni un archivo de licencia.
- Usa el controlador
Kerberos: "No se pudo inicializar la clase KerbAuthentication"
-
Síntoma: Una conexión de Base de datos que usa autenticación Kerberos falla con:
Could not initialize class com.microsoft.sqlserver.jdbc.KerbAuthentication -
Causa posible: Los archivos de configuración de Kerberos en el host del agente no tienen los permisos de archivo correctos.
- Resolución:
- En el host del agente privado, establece los permisos de archivo en los archivos de configuración de Kerberos (
jaas.conf,krb5.confy el archivo de caché de tickets de Kerberos) a644:
- En el host del agente privado, establece los permisos de archivo en los archivos de configuración de Kerberos (
chmod 644 jaas.conf krb5.conf krb5cc_agent
- Reinicia el agente después de aplicar los cambios de permisos.
Kerberos: Errores JGSS o GSS durante la prueba de conexión
- Síntoma: Una conexión de Base de datos que utiliza autenticación Kerberos falla con errores que hacen referencia a
jgssogss. - Posible causa: La JVM está configurada con
-Dsun.security.jgss.native=true, lo que le indica que use la biblioteca GSSAPI nativa del sistema operativo. En algunos sistemas, esto entra en conflicto con la configuración de Kerberos. - Resolución:
- Elimina el parámetro
-Dsun.security.jgss.native=truede los argumentos de JVM del agente. - En
krb5.conf, añadeudp_preference_limit = 1en la sección[libdefaults]para forzar TCP en lugar de UDP para el tráfico de Kerberos. - Reinicia el agente.
- Elimina el parámetro
Microsoft Excel: "La operación debe usar una consulta actualizable"
-
Síntoma: Una actividad de Inserción o Actualización de base de datos dirigida a un archivo de Microsoft Excel (a través de ODBC) falla con:
[Microsoft][ODBC Excel Driver] Operation must use an updateable query -
Posible causa: El controlador ODBC de Excel abre el archivo de Excel en modo de solo lectura de forma predeterminada, a menos que la cadena de conexión establezca explícitamente el modo lectura/escritura.
- Resolución: En el campo Connection String de la conexión de base de datos (ingresado en Optional Settings con Use Connection String seleccionado), añade
ReadOnly=0;al final de la cadena de conexión para abrir el archivo de Excel en modo lectura/escritura.
MySQL: Acceso denegado a pesar de credenciales correctas
-
Síntoma: La conexión a una base de datos MySQL utilizando el conector de base de datos falla con:
Access denied for user 'root'@'%' to database 'test'incluso cuando el nombre de usuario y la contraseña son correctos.
-
Posible causa: MySQL puede otorgar diferentes permisos según la dirección IP del cliente. Una cuenta de usuario puede tener los privilegios requeridos desde direcciones IP específicas pero no desde la dirección IP del agente privado.
-
Resolución:
-
En MySQL, verifica que la cuenta de usuario tenga los permisos necesarios para conexiones desde la dirección IP del agente privado. La sintaxis exacta de concesión varía según la versión de MySQL (consulta la documentación de MySQL o ponte en contacto con tu administrador de MySQL), pero generalmente toma la forma:
GRANT ALL ON database.* TO 'user'@'agent-ip'; -
Prueba la conectividad utilizando un cliente MySQL instalado directamente en el host del agente para determinar si el problema es de red o específico de Jitterbit.
-
MySQL: Habilitar Batch no mejora el rendimiento de Insert o Update
- Síntoma: Una actividad de Inserción o Actualización de Base de datos que utiliza el controlador JDBC de MySQL muestra poco o ninguna mejora de rendimiento después de habilitar Enable Batch, incluso con un gran número de registros.
- Posible causa: De forma predeterminada, el controlador JDBC de MySQL (Connector/J) envía una declaración por fila independientemente de Enable Batch, en lugar de un lote verdadero del lado del servidor.
- Resolución: En el campo Additional Connection String Parameters de la conexión, añade
rewriteBatchedStatements=true.
MySQL: El controlador ODBC no aparece en el menú desplegable de Studio
- Síntoma: Al configurar una conexión de Base de datos a MySQL utilizando un controlador ODBC en un agente privado, el controlador instalado no aparece en el menú desplegable Driver en Studio.
- Causa posible: El gestor ODBC en el host del agente privado no muestra el controlador, generalmente debido a un desajuste entre 32 bits y 64 bits o a una instalación incompleta del controlador.
- Resolución:
- En el host del agente privado (Windows), abre Orígenes de datos (ODBC) (en Herramientas administrativas) y confirma que el controlador MySQL ODBC aparece en la lista. Para ver las opciones del controlador MySQL, consulta Conectarse a MySQL.
- Confirma que el agente se conecta a la máquina correcta: el controlador ODBC debe estar instalado en el host del agente, no en la máquina del usuario de Studio.
PostgreSQL: Error de discordancia de codificación de cliente
- Síntoma: Una prueba de conexión del conector de Base de datos a PostgreSQL falla con un error de "desajuste de codificación del cliente".
- Causa posible: La codificación que utiliza el servidor PostgreSQL es diferente de la codificación predeterminada que asume el controlador ODBC de PostgreSQL.
- Resolución:
- En la configuración de conexión de Base de datos, agrega
ConnSettings=SET CLIENT_ENCODING to 'LATIN1'(sustituyendo la codificación real del servidor) al campo Parámetros adicionales de cadena de conexión. - En Windows, si el servidor utiliza una codificación cirílica como WIN1251, también establece la codificación del cliente a
WIN1251en la configuración del controlador ODBC.
- En la configuración de conexión de Base de datos, agrega
PostgreSQL: Usar el controlador proporcionado por Jitterbit en Linux
- Síntoma: Las operaciones que utilizan el conector de Base de datos para conectarse a PostgreSQL desde un agente privado de Linux fallan o generan errores, incluso cuando parece que hay un controlador instalado.
- Causa posible: Muchas distribuciones de Linux incluyen un controlador ODBC de PostgreSQL empaquetado con
unixODBCque no funciona de manera confiable con Harmony. - Resolución: No utilices el controlador PostgreSQL empaquetado por la distribución. Utiliza el controlador ODBC de PostgreSQL incluido en la instalación del agente Jitterbit.
SQL Server JDBC: La autenticación integrada de Windows falla
-
Síntoma: Para agentes privados, una conexión de Base de datos a SQL Server utilizando un controlador JDBC y autenticación integrada de Windows falla con:
This driver is not configured for integrated authentication. ClientConnectionId:...Con el controlador MS JDBC de SQL Server, los registros del agente también pueden mostrar:
java.lang.UnsatisfiedLinkError: no mssql-jdbc_auth-8.2.0.x64 in java.library.path -
Causas posibles:
- Uso del controlador jTDS de SQL Server: Falta el archivo
ntlmauth.dllrequerido para la autenticación integrada de Windows en el directorio JRE que utiliza el agente Jitterbit en tiempo de ejecución. - Uso del controlador MS JDBC de SQL Server o un controlador JDBC más reciente de Microsoft para SQL Server: Falta el archivo DLL
mssql-jdbc_authrequerido para la autenticación integrada de Windows en los directorios JRE que utiliza el agente Jitterbit en tiempo de ejecución. No es suficiente colocar el archivo DLL en el mismo directorio que el archivo JAR de JDBC. - La cadena de conexión no incluye los parámetros requeridos para tu controlador.
- Uso del controlador jTDS de SQL Server: Falta el archivo
-
Resolución: Elige la opción que coincida con tu controlador JDBC:
- SQL Server jTDS:
- En el host del agente privado, copia
ntlmauth.dll(de la carpetax64/SSOdel paquete de descarga del proyecto jTDS) a<JITTERBIT_HOME>/jre/bin. - En la configuración de conexión de la base de datos, agrega
integratedSecurity=trueal campo Parámetros adicionales de la cadena de conexión. - Reinicia el servicio del agente Jitterbit.
- En el host del agente privado, copia
- SQL Server MS JDBC o un controlador JDBC de Microsoft más reciente para SQL Server:
- En el host del agente privado, copia
mssql-jdbc_auth-x.x.x.x64.dll(de la distribución del controlador JDBC, usando la versión que coincida con el archivo JAR de JDBC incluido en tu agente) a<JITTERBIT_HOME>/jre/biny a<JITTERBIT_HOME>/jre/lib. Realiza una copia de seguridad del archivo, ya que puede eliminarse durante actualizaciones principales del agente. - En la configuración de conexión de la base de datos, agrega
integratedSecurity=true;trustServerCertificate=trueal campo Parámetros adicionales de la cadena de conexión. - Reinicia el servicio del agente Jitterbit.
- En el host del agente privado, copia
- SQL Server jTDS:
Autenticación de Windows de SQL Server: Privilegios insuficientes
- Síntoma: Una conexión de base de datos que utiliza la autenticación de Windows de SQL Server falla incluso cuando las credenciales del dominio parecen correctas.
- Posible causa: El usuario del dominio de Windows que ejecuta el servicio del agente Jitterbit carece de los privilegios a nivel del sistema operativo requeridos para la Seguridad Integrada de Windows.
- Resolución:
- Otorga al usuario del dominio los privilegios de Windows Iniciar sesión como servicio y Actuar como parte del sistema operativo en el host del agente privado.
- Confirma que el usuario del dominio tiene permisos de lectura y escritura en el directorio de instalación del agente Jitterbit.
- Reinicia el servicio del agente Jitterbit después de aplicar los cambios de privilegios.
SQL Server: "Cannot insert explicit value for identity column" al insertar en una columna de identidad
-
Síntoma: Una operación del conector de base de datos que escribe en una tabla de SQL Server con una columna de identidad falla con:
Database Error: Cannot insert explicit value for identity column in table '<table>' when IDENTITY_INSERT is set to OFF. -
Posible causa: La columna de identidad se incluye en la instrucción INSERT que genera el conector de base de datos para el destino. SQL Server rechaza un INSERT que hace referencia a una columna de identidad en su lista de columnas (con un valor explícito o nulo) mientras
IDENTITY_INSERTestá configurado enOFF. Asignar el campo a un valor nulo no lo excluye: un campo de destino se omite del INSERT solo cuando se asigna con la funciónUnmap. -
Resolución:
-
Para permitir que SQL Server asigne el valor de identidad automáticamente, excluye la columna del INSERT asignando el campo de destino de identidad con la función
Unmap. Para excluir la columna solo cuando la fuente no proporciona un valor, usa una asignación condicional:If($source.id != "", $source.id, Unmap())Cuando la condición es falsa,
Unmapelimina la columna del INSERT y SQL Server asigna el siguiente valor de identidad. (Proporcionar un valor explícito en la rama verdadera aún requiere queIDENTITY_INSERTestéON; consulta la siguiente opción.) -
Si debes insertar valores explícitos en la columna de identidad, activa
IDENTITY_INSERTen la tabla de destino en scripts SQL previos y posteriores dentro de la actividad:
-
SET IDENTITY_INSERT <table> ON;
SET IDENTITY_INSERT <table> OFF;
Utiliza esta opción solo cuando desees controlar intencionalmente los valores de identidad desde fuera de la base de datos. Permite insertar valores explícitos en la columna de identidad.
SQL Server: La conexión falla con un error de ruta de certificado PKIX
-
Síntoma: Una conexión de Base de datos a SQL Server falla con:
"encrypt" property is set to "true" and "trustServerCertificate" property is set to "false" but the driver could not establish a secure connection to SQL Server by using Secure Sockets Layer (SSL) encryption: Error: (certificate_unknown) PKIX path building failed: sun.security.provider.certpath.SunCertPathBuilderException: unable to find valid certification path to requested target.Una conexión que funcionaba anteriormente puede comenzar a fallar después de actualizar el agente a la versión 12.8 o posterior.
-
Posible causa: Las versiones actuales del controlador SQL Server MS JDBC solicitan una conexión cifrada de forma predeterminada y validan el certificado que presenta el servidor de base de datos. La conexión falla cuando no se puede rastrear ese certificado a una autoridad de certificación (CA) que el agente ya confía, como un certificado autofirmado, un certificado emitido internamente o el certificado de la CA de Amazon RDS que presenta una instancia de Amazon RDS para SQL Server. Se trata de una falla de confianza del certificado y no de cifrado, por lo que una base de datos puede tener el cifrado habilitado y un certificado válido instalado y aún así fallar. La versión 12.8 del agente actualizó el controlador incluido a una versión que solicita cifrado de forma predeterminada, por lo que una conexión configurada antes de esa actualización puede fallar después.
-
Resolución: Ingresa
encrypt=false;en el campo Parámetros de cadena de conexión adicionales bajo Configuración opcional de la conexión de base de datos, o inclúyelo en una cadena de conexión manual. Esto funciona en agentes en la nube y privados. Para obtener más información, consulta Cifrado de conexión y certificados de servidor.Precaución
Con
encrypt=false, los datos viajan sin cifrar entre el agente y la base de datos. Utiliza esta opción solo donde sea aceptable para los datos y la ruta de red implicada.
Correo electrónico: Enviar correo falla cuando la misma dirección aparece en múltiples campos de destinatarios
- Síntoma: Una actividad de correo electrónico Enviar correo electrónico de Correo electrónico falla en tiempo de ejecución cuando la misma dirección de correo electrónico está presente en más de uno de los campos Para, CC o BCC.
- Posible causa: El conector de correo electrónico no permite que la misma dirección aparezca en varios campos de destinatario en una única solicitud de envío. Esto aplica a direcciones configuradas directamente en la actividad y a direcciones suministradas dinámicamente a través de una asignación de transformación.
- Resolución:
- Revisa los campos Para, CC y BCC en la configuración de la actividad y en cualquier asignación de transformación de la actividad para confirmar que ninguna dirección aparece en más de un campo.
- Si se ensamblan listas de destinatarios dinámicamente utilizando variables o scripts, agrega una verificación de deduplicación antes de pasar las direcciones a la actividad.
Correo electrónico: La prueba de conexión de Gmail falla con error de autenticación
- Síntoma: Una prueba de conexión a una cuenta de Gmail usando Autenticación básica falla con un error de autenticación, incluso cuando se ingresa la contraseña correcta de la cuenta de Google.
- Posible causa: Google requiere una contraseña de aplicación para cuentas con verificación en dos pasos habilitada. La contraseña de la cuenta de Google no es aceptada por SMTP o IMAP cuando la verificación en dos pasos está activa; solo se aceptan contraseñas de aplicación.
- Resolución:
- En tu cuenta de Google, genera una contraseña de aplicación para la aplicación Jitterbit (consulta la página de Google Iniciar sesión con contraseñas de aplicación).
- En la configuración de conexión de correo electrónico en Studio, ingresa la contraseña de aplicación en el campo Contraseña SMTP o Contraseña IMAP en lugar de la contraseña de la cuenta de Google.
Correo electrónico: La firma S/MIME falla o es rechazada por proveedores de correo en la nube
- Síntoma: Los correos electrónicos configurados con firma S/MIME fallan al enviarse, son rechazados por el servidor del destinatario o llegan sin firmar cuando se utiliza un proveedor de correo electrónico en la nube, como Microsoft 365 o Exchange Online.
- Posibles causas:
- Los proveedores en la nube requieren un certificado S/MIME emitido por una autoridad de certificación (CA) de confianza. Los certificados autofirmados no son aceptados por proveedores en la nube como Microsoft 365 (Exchange Online).
- S/MIME funciona únicamente cuando se utilizan agentes privados. Si la operación se ejecuta en un agente en la nube, la firma S/MIME no se aplica independientemente del tipo de certificado.
- Resolución:
- Obtén un certificado S/MIME de una CA de confianza. Let's Encrypt proporciona certificados gratuitos aceptados por los principales proveedores en la nube.
- Reemplaza el certificado autofirmado en la actividad de correo electrónico Enviar correo electrónico con el certificado emitido por la CA (consulta Requisitos previos para el cifrado S/MIME).
- Para agentes privados, confirma que el certificado se importa correctamente en el almacén de confianza predeterminado del agente. Para agentes en la nube, la firma S/MIME no es compatible.
Correo electrónico: La autenticación de Microsoft 365 (ROPC) falla cuando MFA está habilitado
- Síntoma: Una conexión OAuth 2.0 de Microsoft 365 que utiliza la concesión de Credenciales de Propietario del Recurso (ROPC) falla en la autenticación, incluso cuando el nombre de usuario, contraseña, ID de cliente, ID de inquilino y secreto de cliente son todos correctos.
- Posible causa: La autenticación ROPC requiere que la autenticación multifactor (MFA) esté deshabilitada para las credenciales de Microsoft 365 utilizadas con el conector. La concesión ROPC no puede satisfacer un desafío de MFA, por lo que la solicitud de token falla cuando se aplica una política de MFA a la cuenta.
- Resolución:
- Utiliza una cuenta de Microsoft 365 cuyas credenciales no estén sujetas a una política de MFA. Para mantener la seguridad, crea un directorio o inquilino dedicado de Microsoft Entra ID que no aplique MFA, como se describe en Requisitos previos para Microsoft 365.
- Si no se puede quitar MFA de la cuenta, utiliza un método de autenticación diferente compatible para la conexión en lugar de ROPC.
Epicor Prophet 21: La operación falla en tiempo de ejecución con múltiples condiciones de filtro
- Síntoma: Una actividad Query de Epicor Prophet 21 falla en tiempo de ejecución cuando la Cadena de filtro contiene más de una condición de filtro, aunque la actividad parezca válida en Studio.
- Posible causa: Una limitación en la API de Middleware de Epicor Prophet 21 impide que se procesen múltiples condiciones de filtro. La operación parece válida en Studio pero falla en tiempo de ejecución cuando hay más de un filtro.
- Resolución:
- Reduce la Cadena de filtro a una única condición de filtro.
- Si se necesitan múltiples condiciones de filtro, recupera un conjunto de resultados más amplio usando un solo filtro y aplica el filtrado adicional en una transformación o paso de script después de la actividad.
FTP, Recurso compartido de archivos y Almacenamiento local: "Ningún archivo coincide con el filtro de archivo" en pasos de archivo o seguimiento
-
Síntoma: Una actividad de lectura de FTP, File Share o Local Storage falla porque el archivo que espera leer ya no se encuentra en la ruta de origen:
Failed to read file from the source "Read". Reason: No files match the file filter "<filter>".La actividad que previamente procesó el archivo se ejecutó correctamente; la falla ocurre en un paso posterior (generalmente un paso de archivo o notificación) que intenta leer el mismo archivo con el mismo filtro.
-
Posibles causas:
- La actividad de procesamiento ya movió o eliminó el archivo de origen como parte de su comportamiento After Processing, así que el paso de archivo no tiene nada que coincida.
- Se lanza una operación secundaria de manera asincrónica y la operación principal intenta leer el archivo de salida de la secundaria antes de que termine de escribirlo.
- Una actividad Write de FTP con Use FTP Rename habilitado (el valor predeterminado) escribe el archivo con un nombre temporal y lo renombra al nombre final al completarse. Una operación de lectura posterior que se ejecuta antes de que se complete el renombramiento no encontrará el archivo.
- Resolución:
- Confirma si el paso anterior ya manejó el archivo a través de sus opciones integradas de After Processing (mover, renombrar, eliminar). Si es así, un paso de archivo separado es redundante y debe eliminarse.
- Si se requiere un paso de archivo separado, rediseña la cadena para que el procesamiento y el archivo ocurran en la misma referencia de archivo en memoria en lugar de releer desde el origen. Por ejemplo, pasa el contenido leído a través de Temporary Storage al paso de archivo en lugar de releer la ruta de origen.
- Si un paso posterior lee la salida producida por una operación secundaria, ejecuta la secundaria de manera sincrónica para que su salida exista antes de la lectura. Establece el Run type de la herramienta Invoke Operation en Synchronously o, al llamar la operación desde un script, ejecuta
RunOperationde manera sincrónica (el valor predeterminado). Insertar un retraso fijo (por ejemplo, con la funciónSleep) agrega latencia y no garantiza que el archivo esté listo. - Si una actividad Write de FTP está escribiendo en la misma ubicación, verifica si Use FTP Rename está habilitado en la actividad FTP Write. Si la lectura posterior se ejecuta antes de que se complete el renombramiento, deshabilita Use FTP Rename en la actividad de escritura o asegúrate de que la operación de lectura no se ejecute hasta que la operación de escritura se haya completado totalmente.
FTP, Recurso compartido de archivos y Almacenamiento local: Carpeta de error no escrita al fallar la conexión
- Síntoma: Después de que falla una actividad de FTP, File Share o Local Storage, no aparece ningún archivo en la carpeta de error configurada.
- Causa posible: La carpeta de error está diseñada para archivar una copia del archivo de origen después de un procesamiento fallido, por lo que captura archivos solo cuando la actividad se ejecuta y luego falla (por ejemplo, un error de permisos de escritura en el servidor). Si no se puede establecer la conexión al servidor en absoluto, la operación falla antes de que la actividad lea algún archivo, por lo que no hay archivo para escribir en la carpeta de error.
- Resolución:
- Si la carpeta de error está vacía después de un fallo, consulta los registros de operación para buscar un error a nivel de conexión (como un fallo de autenticación o un mensaje de host inaccesible).
- Utiliza el botón Test en la conexión para confirmar si el problema es a nivel de red o autenticación.
FTP, Recurso compartido de archivos y Almacenamiento local: Palabras clave de nombre de archivo no resueltas en rutas de carpeta de éxito y error
- Síntoma: Las operaciones mueven archivos a carpetas de éxito o error después del procesamiento, pero la ruta de destino incluye texto de palabra clave sin expandir en lugar de valores resueltos. La operación puede fallar o escribir archivos en ubicaciones inesperadas.
- Causas posibles:
- Los campos de ruta de carpeta de éxito y carpeta de error en actividades de FTP, File Share y Local Storage no admiten sustitución de palabras clave de nombre de archivo. Las variables no se expanden en estos campos.
- Estos campos se refieren a directorios en la máquina del agente privado, no en el servidor remoto. Las rutas relativas se interpretan en relación con el sistema de archivos del host del agente.
- Resolución:
- Utiliza solo rutas literales (sin variables de palabras clave de nombre de archivo) para los campos de carpeta de éxito y error.
- Si se requieren rutas dinámicas, añade un paso de script después de la actividad para mover o renombrar el archivo procesado a la ubicación prevista utilizando funciones de archivo.
FTP, Recurso compartido de archivos, Almacenamiento local y Almacenamiento temporal: Escribir encabezados no produce un archivo solo de encabezado cuando el origen no devuelve registros
- Síntoma: Una actividad de escritura basada en archivos con la opción Write Headers habilitada (FTP Write, File Share Write, Local Storage Write o Temporary Storage Write) no escribe encabezados cuando el origen no devuelve registros. Se crea un archivo vacío o no se crea ningún archivo (si también está seleccionado Do not create empty files).
- Causa: Este es el comportamiento esperado. Los encabezados se escriben como parte de la salida de transformación, y la transformación se ejecuta solo cuando el origen devuelve al menos un registro. Cuando el origen no devuelve registros, se omite la transformación, por lo que no se escribe salida alguna (incluidos los encabezados), y Studio registra una advertencia de que el origen está vacío. Esto no es específico de ningún conector de origen particular ni destino de archivo plano.
FTP: La operación falla después de muchos inicios de sesión rápidos en el mismo servidor
- Síntoma: Una operación que utiliza el conector FTP (sobre el protocolo FTP o SFTP) que se autentica en el mismo servidor muchas veces en rápida sucesión (por ejemplo, leyendo cientos de archivos pequeños dentro de un bucle, u muchas operaciones ejecutándose contra el mismo servidor en un horario programado) finalmente falla con una denegación de inicio de sesión o error de conexión. La misma operación se ejecuta correctamente con una carga menor.
- Posibles causas:
- El conector FTP abre y autentica una nueva conexión para cada ejecución de actividad y la cierra cuando termina la operación; una sesión no se reutiliza entre actividades, entre ejecuciones de operaciones o entre proyectos. Esto es por diseño. Cuando muchas operaciones se ejecutan contra el mismo servidor, por ejemplo varias operaciones programadas o múltiples proyectos dirigidos al mismo host, cada ejecución se autentica independientemente.
- El servidor remoto está configurado con un número máximo de conexiones, autenticaciones por minuto o sesiones concurrentes por usuario, y la tasa de inicio de sesión combinada de Jitterbit excede ese límite.
- Resolución:
- Cuando sea posible, rediseña la operación para hacer menos conexiones. Reemplaza una actividad de Lectura dentro de un bucle con una única actividad de Lectura que utiliza un comodín en el campo Obtener archivos (por ejemplo,
*.xmlodata_*.csv), luego divide los datos recuperados en registros individuales dentro de una transformación. - Si la operación debe procesar archivos uno a la vez, solicita al administrador del servidor FTP que aumente el límite por usuario de conexiones concurrentes o autenticaciones por minuto.
- Cuando sea posible, rediseña la operación para hacer menos conexiones. Reemplaza una actividad de Lectura dentro de un bucle con una única actividad de Lectura que utiliza un comodín en el campo Obtener archivos (por ejemplo,
SFTP "Acceso denegado. Error de autenticación." al usar claves SSH
-
Síntoma: Una operación SFTP que utiliza autenticación por clave privada SSH falla con
Login denied. Authentication failure., aunque las mismas claves se autentican correctamente desde un cliente SFTP interactivo.Failed to get ftp directory list for url sftp://example.com:22/. Login denied. Authentication failure. -
Posibles causas:
- La clave privada está protegida por una frase de contraseña, pero falta la configuración
PrivateKeyPassphrasede la sección[SSH]del archivo jitterbit.conf del agente. - Una contraseña está configurada en el endpoint FTP junto con la clave privada. La presencia de una contraseña en la configuración del endpoint interfiere con la autenticación basada en claves.
- La clave privada está protegida por una frase de contraseña, pero falta la configuración
-
Resolución:
- Para agentes privados, confirma que la sección
[SSH]dejitterbit.confcontiene la rutaPrivateKeyFilecorrecta y, si la clave está protegida por frase de contraseña, el valorPrivateKeyPassphrasecoincidente (consulta Conectarse a SFTP con claves SSH). - En la configuración del endpoint FTP, borra el campo Contraseña cuando la autenticación sea por clave SSH.
- Confirma que la clave está en un formato que el agente soporta (OpenSSH). Convierte la clave con
ssh-keygensi está en formato PuTTY (.ppk) u otro formato que no sea OpenSSH.
- Para agentes privados, confirma que la sección
Escritura FTP: "Usar cambio de nombre FTP" falla al escribir en un servidor SFTP
-
Síntoma: Una actividad de Escritura de FTP configurada con la opción Usar cambio de nombre FTP falla cuando el destino es un servidor SFTP, con un error similar a:
Failed to put ... to the url ...
Quote command returned error. Rename command failed: <reason>.
El
<reason>generalmente esNo such file or directory, oPermission deniedpara un archivo cuyo nombre contiene caracteres multibyte. -
Posibles causas:
- En agentes anteriores a la 11.56, la opción Usar cambio de nombre FTP no respetaba de forma confiable el paso de cambio de nombre al escribir en un servidor SFTP, particularmente en operaciones con patrón de archivo.
-
El nombre del archivo contiene caracteres multibyte y el servidor SFTP no admite renombrar archivos cuyos nombres los contengan. A partir de la versión 12.8 del agente, el conector FTP puede leer y escribir archivos con nombres multibyte; sin embargo, con Use FTP Rename el agente carga el archivo bajo un nombre temporal (sufijo
-jbupload) y luego lo renombra al nombre final, y si el servidor no puede renombrar el nombre multibyte devuelve un error engañosoPermission denied. Los nombres de archivo que usan solo caracteres ASCII no se ven afectados. Esta es una limitación del servidor SFTP, no de Jitterbit. -
Resolución:
-
Asegúrate de que el agente sea versión 11.56 o posterior, donde Use FTP Rename con SFTP funciona como se espera. Los agentes en la nube se actualizan automáticamente; actualiza los agentes privados si es necesario.
-
Desactiva la casilla Use FTP Rename en la configuración de la actividad para que el agente escriba directamente en la ruta de destino en lugar de cargar en un nombre temporal y renombrar. Esto evita el paso de renombramiento y resuelve ambas causas.
-
Para el caso multibyte, como alternativa utiliza un servidor SFTP que admita renombrar archivos cuyos nombres contengan caracteres multibyte.
-
SFTP: Anexar a archivo no es compatible
- Síntoma: Una actividad FTP Write configurada con la opción Append To File no anexa al archivo existente cuando el destino es un servidor SFTP.
- Posible causa: El protocolo SFTP no admite anexar a archivos existentes. Esta es una limitación a nivel de protocolo, no un problema de configuración de Jitterbit.
- Resolución:
- Usa FTP o FTPS si se requiere el comportamiento de anexación.
- Si se requiere SFTP, implementa la lógica de anexación manualmente: lee el contenido del archivo existente, combínalo con los datos nuevos y escribe el resultado completo de nuevo como un archivo completo.
FTP: Los nombres de archivo que contienen # no se manejan correctamente
- Síntoma: Una actividad del conector FTP (sobre el protocolo FTP o SFTP) falla cuando el nombre de archivo de origen o destino contiene un carácter hash (
#). Leer el archivo devuelve un error comoNo File with that nameoError in SSH Layer, y escribir el archivo produce un nombre de archivo truncado. - Posible causa: El conector FTP trata la ruta del archivo como una URL, en la que el carácter hash es un delimitador de fragmento reservado. El conector analiza la parte de la ruta antes de
#y descarta el resto. - Resolución:
- Renombra los archivos para eliminar o reemplazar el carácter
#antes de que Jitterbit los lea o escriba. - Para que el conector codifique en URL los nombres que contienen caracteres especiales como
#, establecejitterbit.source.ftp.encode_urlentrueen un script de transformación para nombres de archivo o carpeta de origen, yjitterbit.target.ftp.encode_urlentruepara archivos escritos en el destino.
- Renombra los archivos para eliminar o reemplazar el carácter
Recurso compartido de archivos: Las rutas UNC con nombres de servidor fallan en agentes en la nube
- Síntoma: Las conexiones de Recurso compartido de archivos que utilizan rutas UNC (por ejemplo,
\\server\share) fallan al conectarse cuando la operación se ejecuta en un agente en la nube. - Posible causa: Los agentes en la nube pueden resolver rutas UNC usando una dirección IP pública pero no pueden resolver nombres de host de servidor en rutas UNC.
- Resolución:
- Reemplaza el nombre del servidor en la ruta UNC con la dirección IP pública del servidor (por ejemplo,
\\192.0.2.1\share). - Si se requiere resolución de nombres de servidor en rutas UNC, utiliza un agente privado en su lugar.
- Reemplaza el nombre del servidor en la ruta UNC con la dirección IP pública del servidor (por ejemplo,
Recurso compartido de archivos: Los archivos mayores a 2 GB pueden fallar al recuperarse
- Síntoma: Una actividad de Lectura de File Share puede fallar al recuperar archivos individuales mayores a 2 GB. Los archivos más pequeños se recuperan sin problemas.
- Causa posible: El conector File Share tiene una limitación conocida con archivos individuales mayores a 2 GB.
- Resolución: No existe una opción de configuración que elimine este límite. Como solución alternativa, divide el archivo en segmentos más pequeños en la fuente para que cada archivo sea menor a 2 GB antes de que la actividad de Lectura de File Share lo recupere.
Almacenamiento local: No disponible en agentes en la nube
- Síntoma: Una operación que utiliza un conector de Local Storage falla cuando se ejecuta en un agente en la nube.
- Causa posible: Local Storage accede al sistema de archivos de la máquina donde está instalado el agente. Los agentes en la nube se ejecutan en un entorno alojado y no exponen un sistema de archivos local para este propósito.
- Resolución:
- Utiliza agentes privados para cualquier operación que requiera el conector Local Storage. Local Storage está deshabilitado en agentes privados de forma predeterminada, así que también habilítalo en el archivo de configuración del agente privado (consulta Habilitar ubicación de archivo local).
- Para flujos de trabajo de agentes en la nube, reemplaza Local Storage con Temporary Storage o un conector de almacenamiento externo (File Share, FTP o Cloud Datastore).
Almacenamiento temporal: Archivos faltantes cuando se leen en una operación posterior
- Síntoma: Los archivos de Temporary Storage escritos por una operación faltan cuando una operación posterior intenta leerlos.
- Causas posibles:
- El servicio de limpieza de Harmony elimina los archivos de Temporary Storage después de 24 horas de forma predeterminada.
- Cada agente en un grupo de agentes tiene su propio Temporary Storage local. Se garantiza que las operaciones en la misma cadena de operaciones se ejecuten en el mismo agente, pero una operación posterior que no está en la misma cadena puede enviarse a un agente diferente y acceder a una instancia diferente de Temporary Storage, por lo que no encuentra el archivo, independientemente de la ventana de 24 horas. Consulta Notas importantes.
- Resolución:
- Vincula las operaciones que deben compartir archivos de Temporary Storage en la misma cadena de operaciones utilizando acciones de operaciones, donde el comportamiento de Temporary Storage es consistente y confiable.
- Para agentes privados, la frecuencia de limpieza se puede ajustar en la sección
[FileCleanup]dejitterbit.conf. Consulta[FileCleanup]. - Si los archivos no se pueden consumir dentro de la misma cadena o deben persistir más de 24 horas, utiliza un conector de almacenamiento persistente accesible a todos los agentes (como File Share, FTP o Cloud Datastore) en lugar de Temporary Storage.
Almacenamiento temporal: Caracteres restringidos en rutas de archivos
- Síntoma: Una actividad de Lectura o Escritura de Temporary Storage falla cuando la ruta del archivo contiene ciertos caracteres especiales.
- Causa posible: Los siguientes caracteres no son compatibles en rutas de archivos de Temporary Storage:
~,%,$,",<,>,:,? - Resolución:
- Elimina o reemplaza los caracteres no compatibles en la ruta del archivo. Los siguientes caracteres son compatibles:
!,@,#,^,&,*,(,),[,],',; - Tanto
/como\se aceptan como separadores de ruta.
- Elimina o reemplaza los caracteres no compatibles en la ruta del archivo. Los siguientes caracteres son compatibles:
Almacenamiento temporal: Límite de tamaño de archivo de 50 GB en agentes en la nube
- Síntoma: una actividad de Escritura de Almacenamiento Temporal falla al escribir archivos grandes a través de un agente en la nube.
- Posible causa: los agentes en la nube imponen un tamaño máximo de archivo de 50 GB por archivo para el Almacenamiento Temporal.
- Resolución:
- Usa un agente privado para flujos de trabajo que necesiten escribir archivos individuales mayores a 50 GB en el Almacenamiento Temporal.
- Si solo están disponibles agentes en la nube, divide los conjuntos de datos grandes en varios archivos menores a 50 GB antes de escribir en el Almacenamiento Temporal.
HTTP v2: Espacios codificados como + en lugar de %20
- Síntoma: Las llamadas a la API REST que utilizan el conector HTTP v2 fallan en el sistema de destino porque los espacios en la URL se codifican como
+en lugar de%20, lo que causa que el destino devuelva un error de recurso no encontrado. - Resolución:
- En la conexión HTTP v2, habilita la opción Codificar URL de solicitud. A continuación, el conector codifica la URL de la solicitud, codificando los espacios como
%20. - Proporciona la URL de la solicitud completamente sin codificar. No precodifiques caracteres ni apliques la función
URLEncodea la URL, porque los caracteres ya codificados se codifican doble cuando Codificar URL de solicitud está habilitado (por ejemplo,example+string%20valuese convierte enexample%20string%2520value).
- En la conexión HTTP v2, habilita la opción Codificar URL de solicitud. A continuación, el conector codifica la URL de la solicitud, codificando los espacios como
HTTP v2: Código de estado de respuesta no disponible en variables de Jitterbit
- Síntoma: Los scripts que leen variables de origen o destino de Jitterbit para capturar el código de estado de respuesta HTTP después de ejecutar una actividad de HTTP v2 no reciben ningún valor. El mismo enfoque funciona con el conector HTTP pero no con HTTP v2.
- Causa posible: El conector HTTP v2 no completa las variables de origen o destino de Jitterbit. Los datos de respuesta, incluido el código de estado HTTP, se devuelven a través del esquema de respuesta de la actividad en su lugar.
- Resolución:
- Para capturar el código de estado usando el esquema de respuesta predeterminado, asigna el campo
statusCode, que se encuentra bajo el nodoresponseItem/errorde la respuesta y contiene el código de estado HTTP (por ejemplo,200,403). Para obtener detalles sobre la estructura del esquema de respuesta, consulta la documentación de configuración de cualquier actividad de HTTP v2. - Para capturar el código de estado cuando se utiliza un esquema de respuesta personalizado, habilita Incluir propiedades adicionales de la respuesta HTTP en el esquema en la configuración de la actividad. Esto envuelve el esquema con una estructura definida por Jitterbit que incluye
__jitterbit_api_statuscode__(el código de estado) y__jitterbit_api_errorbody__(el cuerpo de la respuesta para solicitudes sin éxito). - Para que el código de estado esté disponible cuando la API devuelve una respuesta sin éxito, habilita Ignorar error de operación en caso de código de estado sin éxito en la configuración opcional de la actividad. Sin este ajuste, la operación falla en respuestas sin éxito antes de que se puedan asignar los datos de respuesta.
- Para capturar el código de estado usando el esquema de respuesta predeterminado, asigna el campo
HTTP v2: Espacios de nombres XML reescritos al usar un esquema de solicitud personalizado
- Síntoma: Una operación de HTTP v2 que envía una carga útil XML a un servicio web SOAP o XML falla con un error del servidor (como
500 Internal Server Error) aunque la misma carga útil se ejecuta correctamente cuando se envía desde Postman o SoapUI. Al inspeccionar el cuerpo de la solicitud recibido por el destino, se observa que las declaraciones de espacios de nombres XML se han consolidado en el elemento raíz y los prefijos de espacio de nombres originales se han reemplazado con otros genéricos (por ejemplo,soapenv:Envelopese convierte enEnvelope xmlns="...", y los prefijos de elemento se renumeran comons,ns1,ns2). - Causa posible: Cuando se utiliza un esquema de solicitud personalizado en la configuración de la actividad HTTP v2, la transformación normaliza el XML de forma predeterminada, moviendo todas las declaraciones de espacios de nombres al nodo raíz y reasignando sus prefijos. Los servicios SOAP y otros puntos finales XML que validan la coherencia de prefijos de espacios de nombres rechazan la carga útil modificada.
-
Resolución:
-
En la versión del agente 12.8 o posterior, establece
jitterbit.target.xml.preserve.namespace.prefixentrueen un paso de script anterior a la transformación, para conservar los prefijos de espacios de nombres del XML de origen en lugar de reasignar otros genéricos:$jitterbit.target.xml.preserve.namespace.prefix = true; -
Si tus agentes privados son anteriores a la versión 12.8, o el destino también rechaza la consolidación de declaraciones de espacios de nombres en el elemento raíz, utiliza el esquema de solicitud predeterminado en lugar de uno personalizado y asigna la carga útil XML completa como cadena al campo
bodydel esquema. La carga útil se trata entonces como una cadena y no como XML analizado, por lo que sus declaraciones de espacios de nombres se conservan. El esquema de respuesta aún puede ser un esquema personalizado.
-
HTTP v2: Encabezado de autorización duplicado causa error 400 Bad Request
- Síntoma: las operaciones del conector HTTP v2 fallan con un error 400 cuando tanto la autenticación a nivel de conexión como un encabezado de solicitud
Authorizationdefinido manualmente se configuran en la misma conexión o actividad. - Posible causa: cuando se configura autenticación en una conexión HTTP v2 (por ejemplo, Basic u OAuth), el conector agrega automáticamente un encabezado
Authorizationa cada solicitud. Agregar manualmente un segundo encabezadoAuthorizationgenera dos encabezados en conflicto, que la mayoría de los servidores rechazan con un error 400. - Resolución:
- Elimina cualquier encabezado
Authorizationagregado manualmente de los encabezados de solicitud en la configuración de actividad o conexión. - Usa solo la configuración de autenticación integrada en la conexión para manejar la autorización. No agregues un encabezado
Authorizationmanual junto con la autenticación configurada. - Si necesitas establecer el encabezado
Authorizationde forma dinámica a nivel de actividad, establece el tipo de autenticación de la conexión en No Auth y configura el encabezado de solicitudAuthorizationde la actividad según sea necesario.
- Elimina cualquier encabezado
HTTP v2: Valor JSON en una variable de encabezado de solicitud falla al analizarse
-
Síntoma: una actividad de HTTP v2 que lee un valor de encabezado de solicitud de una variable de proyecto que contiene una cadena JSON falla con un error de análisis:
Expected a ',' or ']' at 139 [character 140 line 1]El mismo JSON funciona cuando se pega directamente en la columna Valor de la tabla Encabezados de solicitud.
-
Posible causa: cuando se lee un valor de encabezado de solicitud desde una variable de proyecto, el conector HTTP v2 no escapa las comillas incrustadas de la forma en que lo hace cuando escribes el valor directamente en la tabla Encabezados de solicitud. Las comillas sin escape rompen la cadena de encabezado antes de llegar al destino.
- Resolución:
- Al almacenar JSON en una variable de proyecto que se usará como valor de encabezado, escapa cada comilla doble con una barra invertida. Por ejemplo, almacena el valor como
{\"success\": \"true\"}en lugar de{"success": "true"}. - Si el contenido JSON es estático, pégalo directamente en la columna Valor de la tabla Encabezados de solicitud en lugar de usar una variable. El conector aplica el escape necesario en esa ruta.
- Al almacenar JSON en una variable de proyecto que se usará como valor de encabezado, escapa cada comilla doble con una barra invertida. Por ejemplo, almacena el valor como
HTTP y HTTP v2: URL contiene múltiples caracteres ?
- Síntoma: Una operación de HTTP o HTTP v2 falla en el sistema de destino. Los registros del agente muestran que la URL de solicitud contiene más de un
?entre segmentos, por ejemplohttps://api.example.com/endpoint?param1=A?param2=B. - Posible causa: Los parámetros de consulta se declararon en dos lugares: anexados directamente a la ruta de URL y también agregados a la tabla Request Parameters de la actividad. El conector concatena ambos conjuntos, insertando un segundo
?en lugar de un&. - Resolución:
- Elimina cualquier segmento de cadena de consulta de la ruta de URL. La URL base debe contener solo la ruta misma (por ejemplo,
https://api.example.com/endpoint). - Define cada parámetro de consulta en la tabla Request Parameters de la actividad. El conector inserta los caracteres
?y&automáticamente al construir la URL final.
- Elimina cualquier segmento de cadena de consulta de la ruta de URL. La URL base debe contener solo la ruta misma (por ejemplo,
HTTP v2: Codificación de URL doble cuando "Codificar URL de solicitud" está habilitado
- Síntoma: Las llamadas a la API REST realizadas a través del conector HTTP v2 fallan en el sistema de destino porque los parámetros de URL aparecen con codificación doble en la solicitud saliente (por ejemplo, un espacio
%20se convierte en%2520). - Posible causa: Cuando Encode request URL está habilitado en la configuración de conexión de HTTP v2, el conector codifica la URL completa antes de enviarla. Si los parámetros de URL ya contienen caracteres codificados en porcentaje, esos caracteres se codifican una segunda vez.
- Resolución:
- Deshabilita Encode request URL en la configuración de conexión de HTTP v2 cuando la URL o los parámetros ya están codificados o se construyen mediante la función
URLEncode. - Si Encode request URL debe permanecer habilitado, asegúrate de que los parámetros pasados a la URL no estén precodificados antes de llegar a la conexión.
- Deshabilita Encode request URL en la configuración de conexión de HTTP v2 cuando la URL o los parámetros ya están codificados o se construyen mediante la función
HTTP v2: La operación falla cuando la URL base se redirige
- Síntoma: Una operación de HTTP v2 falla inmediatamente cuando la Base URL configurada devuelve una respuesta de redirección (3xx).
- Posible causa: Follow redirects está deshabilitado en la configuración de conexión de HTTP v2, por lo que las respuestas de redirección se tratan como fallos en lugar de seguirse automáticamente.
- Resolución: En la configuración de conexión de HTTP v2, habilita Follow redirects para permitir que el conector siga automáticamente las respuestas de redirección a la URL de destino final.
HTTP v2: Las variables en la ruta de la actividad no se resuelven
- Síntoma: Una actividad de HTTP v2 utiliza una variable global, de proyecto o de Jitterbit en su campo Path, pero en tiempo de ejecución la variable se envía literalmente (sin resolver) en lugar de reemplazarse con su valor.
- Posible causa: Se ingresó una URL completa (una que incluye el protocolo y host, como
https://api.example.com/...) en el campo Path. Las variables no se admiten en URLs completas. Solo se resuelven en una ruta parcial que se anexa a la Base URL de la conexión. - Resolución:
- En la conexión de HTTP v2, establece la Base URL en la porción de protocolo y host del endpoint (por ejemplo,
https://api.example.com). - En el campo Path de la actividad, ingresa solo la ruta parcial que sigue a la URL base, y coloca la variable dentro de esa ruta parcial (por ejemplo,
/records/[recordId]). El conector resuelve la variable y anexa el resultado a la Base URL en tiempo de ejecución.
- En la conexión de HTTP v2, establece la Base URL en la porción de protocolo y host del endpoint (por ejemplo,
HTTP: Envía null como la cadena "null"
- Síntoma: Una actividad HTTP POST o PUT envía campos asignados con la función
Nullcomo la cadena"null"(u los omite) en lugar de emitir un literal JSONnull. Esto ocurre cuando el esquema de solicitud está definido en la actividad. - Posible causa: Cuando el esquema de solicitud está definido en la actividad HTTP, el conector no serializa un
Nullasignado como un JSONnull. Cuando el esquema está definido en la transformación en su lugar, sin ningún esquema de solicitud proporcionado en la actividad, el conector envía unNullasignado como un JSONnullcorrectamente. - Resolución:
- Migra la actividad al conector HTTP v2, que serializa
Nullcorrectamente. Jitterbit recomienda convertir conexiones y actividades HTTP existentes a HTTP v2. - Si la actividad debe permanecer en HTTP, define el esquema de solicitud en la transformación en lugar de en la actividad y deja el esquema de solicitud de la actividad sin establecer. Con el esquema definido en la transformación, el conector serializa un
Nullasignado a un JSONnullcorrectamente.
- Migra la actividad al conector HTTP v2, que serializa
LDAP Delete Entry falla cuando la entrada de destino tiene entradas secundarias
- Síntoma: Una actividad Eliminar entrada de LDAP falla con un error del servidor LDAP (por ejemplo,
notAllowedOnNonLeafo un mensaje que indica que la entrada no es un nodo hoja). - Posible causa: El protocolo LDAP no permite eliminar una entrada que tiene entradas secundarias (subordinadas). La entrada debe ser un nodo hoja sin secundarios para que la eliminación tenga éxito.
- Resolución:
- Antes de eliminar la entrada principal, elimina primero todas las entradas secundarias. Recorre la jerarquía desde las entradas más profundas hacia arriba.
- Si se requiere eliminar un subárbol completo, implementa un script que identifique y elimine entradas desde la parte inferior del árbol hacia arriba, utilizando
RunOperationcon la actividad Eliminar entrada de LDAP para cada entrada.
LDAP Search Entry: La expresión de filtro distingue mayúsculas de minúsculas en algunos servidores
- Síntoma: Una actividad Buscar entrada de LDAP no devuelve resultados o un error, aunque las entradas consultadas existan en el directorio.
- Posible causa: Algunos servidores LDAP requieren que los nombres de atributo en expresiones de filtro coincidan con la capitalización exacta utilizada por el esquema de ese servidor. La expresión de filtro precargada por Studio utiliza mayúsculas y minúsculas de título para la clase estructural (por ejemplo,
ObjectClass), pero algunos servidores requieren una capitalización diferente (por ejemplo,objectClass). - Resolución:
- En la configuración de la actividad Buscar entrada de LDAP, revisa el campo Expresión de filtro precargado.
- Ajusta la capitalización de los nombres de atributo para que coincida con lo que el servidor LDAP de destino espera. Por ejemplo, cambia
ObjectClassaobjectClasssi el servidor requiere minúsculas. - Consulta la documentación o definición de esquema de tu servidor LDAP para conocer las convenciones de nomenclatura de atributos requeridas.
Microsoft SharePoint Online: Conexiones de esquema SOAP fallando después del retiro de IDCRL
- Síntoma: Las operaciones que utilizan un conector Microsoft SharePoint Server con el tipo de conexión de esquema SOAP han comenzado a fallar o devolver errores de autenticación al conectarse a SharePoint Online.
- Causa probable: Microsoft retiró el método IDCRL (Identity Client Runtime Library) utilizado por las conexiones de esquema SOAP a SharePoint Online. Después del 1 de mayo de 2026, se espera que las operaciones que utilicen el esquema SOAP de SharePoint para conexiones de SharePoint Online fallen.
- Resolución:
- En Studio, abre cada conexión de SharePoint afectada y cambia la configuración de Schema de SOAP a REST.
- Reconfigura cualquier actividad que haya utilizado el esquema SOAP para utilizar operaciones REST equivalentes.
- Prueba y redeploy las operaciones afectadas.
- Para obtener detalles sobre la migración, consulta la documentación del conector Microsoft SharePoint Server.
Microsoft Dynamics 365 Business Central v2: Nombres de tipo incompatibles con metadatos
- Síntoma: Las operaciones que utilizan el conector Microsoft Dynamics 365 Business Central v2 fallan con errores que indican que los nombres de tipo en la carga útil no son compatibles con los metadatos de OData.
- Causa probable: Ciertos puntos finales de la API de OData de Dynamics 365 Business Central requieren anotaciones de tipo de OData en la carga útil de la solicitud. De forma predeterminada, el conector no incluye estas anotaciones, lo que causa errores de incompatibilidad de tipo para esos puntos finales.
- Resolución:
- Abre la configuración de la actividad Update de Microsoft Dynamics 365 Business Central v2.
- En Configuración opcional, habilita Set OData type on payload.
- Guarda la actividad y vuelve a probar las operaciones afectadas.
Microsoft Entra ID: Atributos de extensión no seleccionables como condiciones de filtro de consulta
- Síntoma: Al configurar una actividad Query de Microsoft Entra ID, el campo
onPremisesExtensionAttributesy sus campos de atributo de extensión secundarios (por ejemplo,extensionAttribute1a través deextensionAttribute15) no aparecen en el selector de Object Fields en el paso 3 y no se pueden seleccionar como condiciones de filtro de cláusula condicional. - Causa probable:
onPremisesExtensionAttributeses un objeto de tipo complejo (anidado). El selector de Object Fields del paso 3 expone solo campos de tipos de datos primitivos; los campos de tipo complejo se excluyen de la lista de selección. - Resolución: No es necesario seleccionar los campos
onPremisesExtensionAttributesen el paso 3 para que se devuelvan. Aparecen en el esquema de salida de la actividad en el paso 4 y se rellenan en tiempo de ejecución cuando se ejecuta la operación. Para acceder a los valores de atributos de extensión, asigna desdeonPremisesExtensionAttributesy sus campos secundarios en la transformación.
Actividad de actualización de Microsoft Entra ID: Campos DateTime rechazados con error de tipo Edm.String
- Síntoma: Una actividad Update de Microsoft Entra ID falla con:
Se encontró un valor que tiene un nombre de tipo incompatible con los metadatos.
El valor especificó su tipo como 'Edm.String', pero el tipo especificado en los metadatos es 'Edm.DateTimeOffset'.
[HTTP/1.1 400 Bad Request]
- Causa posible: El conector envía valores de campos DateTime (como
employeeHireDate) sin la anotación@odata.typerequerida por la API de Microsoft Graph. Sin la anotación, el valor se interpreta comoEdm.Stringen lugar deEdm.DateTimeOffset, lo que causa un error 400. - Resolución:
- Abre la configuración de la actividad Update de Microsoft Entra ID.
- En el paso 1, expande Configuración opcional y habilita Establecer tipo OData en la carga.
- Guarda la actividad, vuelve a implementar y vuelve a ejecutar la operación.
Consulta de Microsoft Entra ID: "Cláusula de filtro de consulta no compatible o no válida" en propiedades filtradas
-
Síntoma: Una actividad Consulta de Microsoft Entra ID falla cuando se aplica una condición de filtro en el paso 3:
(Request_UnsupportedQuery) Unsupported or invalid query filter clause specified for property '<property>' of resource '<object>'. [HTTP/1.1 400 Bad Request]La misma consulta se ejecuta correctamente cuando no se aplica filtro.
-
Causa posible: El filtrado en ciertas propiedades de Microsoft Entra ID (como
companyNameycreatedDateTime) utiliza la capacidad de consulta avanzada de la API de Microsoft Graph, que requiere$count=trueen la cadena de consulta. Sin ella, la API rechaza el filtro incluso cuando la sintaxis es correcta. El conector incluye automáticamente el encabezado requeridoConsistencyLevel: eventual, pero$count=truedebe agregarse por separado. - Resolución: Elige una de las siguientes opciones según la pestaña utilizada en el paso 3:
- Pestaña Básica: Selecciona la casilla Incluir recuento. Esto agrega
$count=truea la consulta automáticamente. -
Pestaña Avanzada: Agrega
&$count=truemanualmente a la cadena de filtro. Por ejemplo:$filter=companyName eq 'Example Corp'&$count=true
- Pestaña Básica: Selecciona la casilla Incluir recuento. Esto agrega
Para ver la lista de propiedades que requieren sintaxis de consulta avanzada, consulta Advanced query capabilities on Microsoft Entra ID objects en la documentación de Microsoft Graph.
Las operaciones de Microsoft Dynamics AX 2012 fallan con "Logon failed"
-
Síntoma: Las operaciones que utilizan el conector Microsoft Dynamics AX con AX 2012 fallan en tiempo de ejecución, incluso aunque la prueba de conexión sea exitosa en Studio. El registro del servicio REST del conector Jitterbit Dynamics AX 2012 contiene:
The server has rejected the client credentials.The logon attempt failed -
Causa: El campo Nombre de dominio en la conexión AX 2012 no está configurado con el valor correcto. La autenticación de AX 2012 requiere que el Nombre de dominio sea la extensión del nombre de dominio DNS (por ejemplo,
tuempresa.com), no un nombre de dominio corto o NetBIOS. Un valor de dominio incorrecto hace que AX rechace las credenciales de otra manera válidas con un error de inicio de sesión, incluso cuando la prueba de conexión sea exitosa. - Resolución:
- Abre la conexión Dynamics AX 2012 en Studio.
- Configura el campo Nombre de dominio con la extensión del nombre de dominio DNS (por ejemplo,
tuempresa.com), no un nombre de dominio corto/NetBIOS. - Confirma que el Inicio de sesión sea el nombre de usuario de la cuenta de servicio de AX con los privilegios requeridos y vuelve a ingresar la Contraseña para descartar un valor obsoleto.
- Prueba la conexión y luego vuelve a ejecutar la operación.
NetSuite: Error de URL del centro de datos
-
Síntoma: Una conexión de NetSuite que antes se probaba con éxito ahora falla con este error:
Connector Error: Error getting the data center URL.
Caused by: org.jitterbit.integration.server.engine.connector.exception.NetSuiteWebServiceRuntimeException: FaultString:
In this account, you must use account-specific domains with this SOAP web services endpoint. You can use the SOAP getDataCenterUrls operation to obtain the correct domain. Or, go to Setup > Company > Company Information in the NetSuite UI. Your domains are listed on the Company URLs tab.
En algunas circunstancias, puede aparecer este error en su lugar:
You are not requesting the correct data center for your company.
-
Causa: Debido a los cambios realizados por NetSuite, algunos formatos de URL de WSDL que antes se permitían ya no se aceptan, incluidas las URL de WSDL genéricas y específicas del centro de datos. Por ejemplo:
- URL de WSDL genérica:
https://webservices.netsuite.com/wsdl/v2025_1_0/netsuite.wsdl - URL de WSDL específica del centro de datos:
https://webservices.na3.netsuite.com/wsdl/v2025_1_0/netsuite.wsdl
- URL de WSDL genérica:
-
Solución alternativa: Cambie la URL de WSDL para utilizar un dominio específico de la cuenta:
- URL de WSDL específica de la cuenta:
https://abcdef123456.suitetalk.api.netsuite.com/wsdl/v2025_1_0/netsuite.wsdl
Para obtener instrucciones sobre cómo encontrar el dominio específico de la cuenta de NetSuite y usarlo en la URL de WSDL, consulte Usar una URL de WSDL específica de la cuenta de NetSuite.
- URL de WSDL específica de la cuenta:
NetSuite: INSUFFICIENT_PERMISSION a pesar de que la prueba de conexión fue exitosa
- Síntoma: Aunque la prueba de una conexión de NetSuite se realice con éxito, es posible que reciba un error
INSUFFICIENT_PERMISSIONal ejecutar operaciones que contienen actividades que utilizan esa conexión. - Solución alternativa: Al generar tokens de acceso, utilice un rol de Full Access o Administrator, o asegúrese de que se permitan los permisos apropiados para el rol que se esté utilizando. Encontrará instrucciones detalladas en la documentación de NetSuite Primeros pasos con la autenticación basada en token.
NetSuite: La conexión de sandbox falla después de actualizar el sandbox
- Síntoma: Una conexión de NetSuite configurada para una cuenta de sandbox de NetSuite falla con un error de autenticación después de actualizar el entorno de sandbox.
- Causa: Cada vez que se actualiza un sandbox de NetSuite, todos los tokens de autenticación basada en tokens (TBA) asociados con ese sandbox se invalidan. La conexión sigue utilizando los tokens anteriores, que NetSuite ya no acepta.
- Resolución: Después de cada actualización del sandbox, genere nuevos tokens TBA para la cuenta de sandbox y actualice los campos Clave de token y Secreto de token en la conexión de NetSuite. Para obtener instrucciones sobre cómo obtener los nuevos valores de token, consulte Reunir valores para usar NetSuite TBA.
NetSuite: Los campos personalizados no aparecen en el esquema de actividad
- Síntoma: Los campos personalizados de un objeto de NetSuite no están presentes en el esquema de transformación de un agente privado, aunque esos campos existan en NetSuite.
- Causa: El conector de NetSuite expone campos personalizados para muchos objetos de forma predeterminada, pero algunos objetos requieren una configuración explícita en el archivo de configuración del conector de NetSuite del agente.
- Resolución: Agregue el objeto al archivo de configuración
netsuiteconfig.xmlen el agente privado. Consulte Exponer campos personalizados en el conector de NetSuite para obtener instrucciones completas, incluida la forma de manejar objetos con más de 1,000 campos personalizados.
NetSuite: Los segmentos personalizados no aparecen o no son compatibles en búsquedas avanzadas
- Síntoma: Los segmentos personalizados no son visibles en el esquema de la actividad, o los segmentos personalizados de tipo Lista/Registro no están disponibles en una búsqueda avanzada.
- Causa: Los segmentos personalizados requieren permisos específicos en la cuenta de usuario de NetSuite. Además, el tipo de segmento Lista/Registro no es compatible en búsquedas avanzadas, solo lo es el tipo Selección Múltiple.
- Resolución: Consulte Segmentos personalizados en la página de la actividad Búsqueda de NetSuite para conocer los requisitos de permisos y las limitaciones conocidas.
NetSuite: Los campos de cuerpo personalizados no son visibles debido a permisos de rol faltantes
- Síntoma: Los campos personalizados del cuerpo de una transacción (por ejemplo, campos agregados a un pedido de venta u otro registro de transacción) no aparecen en el esquema de salida de la actividad de Búsqueda de NetSuite, aunque los campos existan en la instancia de NetSuite y la prueba de conexión se realice correctamente.
- Posible causa: El rol de NetSuite utilizado por la integración no tiene el permiso View para Custom Body Fields. El conector de NetSuite llama a la acción SOAP
getListpara recuperar las definiciones de campos personalizados; una infracción de permisos en esa llamada provoca que los campos se omitan por completo del esquema. - Resolución:
- En su cuenta de NetSuite, abra el rol asignado al usuario de integración y otorgue al menos el permiso View para Custom Body Fields.
- Guarde el rol y espere unos minutos para que el cambio de permisos surta efecto.
- En Studio, cree una nueva actividad de Búsqueda de NetSuite o importe el proyecto en un nuevo ambiente de proyecto para borrar el esquema en caché. Los campos personalizados del cuerpo deberían aparecer ahora en el esquema de salida.
NetSuite: Las búsquedas guardadas no aparecen en el menú desplegable
- Síntoma: Al configurar una actividad de Búsqueda de NetSuite utilizando un tipo de búsqueda Búsqueda Guardada, el menú desplegable Seleccionar una Búsqueda Guardada aparece vacío o no muestra todas las búsquedas guardadas esperadas.
- Causa: La API de NetSuite limita las respuestas a 1,000 registros por solicitud. Cuando un objeto tiene más de 1,000 búsquedas guardadas, el menú desplegable no puede mostrarlas todas y puede aparecer vacío.
- Resolución: Utilice la opción Proporcionar ID de Script de Búsqueda Guardada para omitir el menú desplegable:
- En la sección Seleccionar una Búsqueda Guardada de la configuración de la actividad, seleccione Proporcionar ID de Script de Búsqueda Guardada.
- Ingrese directamente el ID de script de la búsqueda guardada de destino. El ID de script se encuentra en la interfaz de NetSuite, en la página de detalles de la búsqueda guardada.
NetSuite: El botón Prueba de consulta de búsqueda expandida está deshabilitado
- Síntoma: Al configurar una búsqueda expandida en la actividad de Búsqueda de NetSuite, el botón Probar Consulta aparece atenuado y no se puede hacer clic en él.
- Causa: Una búsqueda expandida requiere una condición de consulta sobre un objeto relacionado. El botón Probar Consulta se desactiva cuando no se ha agregado ninguna condición sobre un objeto relacionado.
- Resolución: Agregue al menos una condición que filtre sobre un objeto relacionado. Si la búsqueda solo necesita filtrar por los campos propios del objeto actual, utilice un tipo de búsqueda Básica en lugar de una búsqueda expandida.
NetSuite: Faltan campos de fórmula de búsqueda guardada en la salida de actividad
- Síntoma: Una actividad de Búsqueda de NetSuite que utiliza una búsqueda guardada devuelve la cantidad esperada de registros en Probar Consulta, pero las columnas basadas en fórmulas o en uniones complejas (por ejemplo, campos
customSearchJoin) faltan en la salida de la actividad y en el mapeo de la transformación, aunque esas columnas aparezcan en la búsqueda guardada dentro de la interfaz de NetSuite. - Causa: Las columnas de la búsqueda guardada basadas en fórmulas se calculan a nivel de la interfaz de NetSuite y no se incluyen en la respuesta SOAP que lee el conector. Como resultado, esos valores no aparecen en la salida de la actividad aunque la búsqueda devuelva registros.
- Resolución:
- Cuando sea posible, reconstruya la búsqueda guardada utilizando campos almacenados (no basados en fórmulas), ya que los valores calculados por fórmula pueden no devolverse a través de la API.
- En Studio, abra la actividad de Búsqueda de NetSuite y, en la primera página de configuración, seleccione la opción Búsqueda Guardada (utiliza una búsqueda reutilizable que ya ha definido en NetSuite).
- Seleccione la búsqueda guardada en el menú desplegable Seleccionar una Búsqueda Guardada.
- Continúe con las páginas restantes y ejecute la operación para recuperar todos los datos.
NetSuite: Error de análisis en Prueba de consulta cuando el filtro usa una variable de proyecto
-
Síntoma: Cuando el filtro de una actividad de Búsqueda de NetSuite usa una variable de proyecto para un valor de fecha o fecha y hora (como
lastModifiedDate), al hacer clic en Probar Consulta en la configuración de la actividad se devuelve un error 500 que hace referencia a un formato de fecha no válido. La misma operación se ejecuta correctamente en tiempo de ejecución.Connector Error: FaultString: java.text.ParseException: Invalid dateTime format: [lastModifiedDate] -
Causa: Probar Consulta no resuelve las variables de proyecto. Envía la referencia literal de la variable (por ejemplo,
[lastModifiedDate]) como valor de filtro, que NetSuite rechaza como una fecha no válida. En tiempo de ejecución, el agente sustituye el valor real de la variable, por lo que la operación en sí se ejecuta correctamente. - Resolución: Para probar o guardar cambios en la actividad sin eliminar la variable, agregue un valor predeterminado temporal a la referencia de la variable en la condición del filtro:
- En el filtro, cambie la referencia de la variable de
[my_date_variable]a[my_date_variable{2023-01-01T00:00:00.000Z}](utilizando la fecha y hora ISO 8601 adecuada como valor predeterminado). - Haga clic en Probar Consulta. La prueba ahora se realiza correctamente porque se sustituye una fecha válida en lugar de la variable no resuelta.
- Guarde cualquier otro cambio en la actividad. El valor predeterminado puede permanecer en su lugar; en tiempo de ejecución, el agente siempre utiliza el valor actual de la variable de proyecto.
- En el filtro, cambie la referencia de la variable de
NetSuite: Búsqueda guardada con campos de resultado como salida requiere agente 11.49 o posterior
- Síntoma: En la actividad de Búsqueda de NetSuite, la opción Búsqueda Guardada con campos de resultado como salida es visible en la interfaz de la actividad, pero las operaciones que la utilizan fallan con un error 500 al ejecutarse en un agente privado más antiguo.
- Causa: La función Búsqueda Guardada con campos de resultado como salida se introdujo en la versión 11.49 del agente. Los agentes privados en versiones anteriores muestran la opción en la interfaz, pero no tienen la compatibilidad en tiempo de ejecución para ejecutarla.
- Resolución:
- Confirme la versión del agente en la pestaña Privado de la página Agentes de la Consola de Administración.
- Actualice los agentes privados a la versión 11.49 o posterior para usar esta opción. Los agentes en la nube se mantienen actualizados automáticamente.
- Si no es posible actualizar el agente privado, reconfigure la actividad para usar Búsqueda Guardada en su lugar. Este modo es compatible con versiones anteriores del agente.
NetSuite: La actividad Update devuelve INVALID_KEY_OR_REF cuando el XML de origen pierde internalId
-
Síntoma: Una actividad de Actualización de NetSuite se completa sin generar una excepción, pero no se actualiza ningún registro en NetSuite. La carga útil de la respuesta contiene el estado SOAP
INVALID_KEY_OR_REF. Este problema suele aparecer cuando un script de transformación usaGetXMLStringpara construir la carga útil de actualización a partir de una respuesta de búsqueda anterior.<writeResponse> <platformCore:status isSuccess="false"> <platformCore:statusDetail type="ERROR"> <platformCore:code>INVALID_KEY_OR_REF</platformCore:code> <platformCore:message>The specified key is invalid.</platformCore:message> </platformCore:statusDetail> </platformCore:status> <baseRef> <platformCore:RecordRef type="invoice"></platformCore:RecordRef> </baseRef> </writeResponse> -
Causa:
GetXMLStringserializa un nodo XML, pero no conserva los atributos del elemento raíz. Cuando elinternalIddel registro de origen se almacena como un atributo en el nodo raíz del registro de NetSuite (por ejemplo, en el elementoInvoice), se elimina de la cadena resultante y la actividad Actualización ve una referencia de registro vacía. -
Resolución: Capture el
internalIddel registro de origen por separado y luego vuelva a agregarlo al XML serializado antes de pasar la carga útil a la actividad Actualización:- En el script de transformación, asigne el
internalIdde origen a una variable. - Llame a
GetXMLStringpara construir el XML del registro. -
Use
Replacepara insertarinternalId="..."en el elemento raíz. Para un registro de Invoice:<trans> $invoiceInternalId = searchResponse$searchResult$recordList$record.Invoice$internalId; $MyRecord = GetXMLString([searchResponse$searchResult$recordList$record.]); $MyRecord = Replace($MyRecord, "<Invoice>", '<Invoice internalId="' + $invoiceInternalId + '">'); </trans> -
Pase
MyRecordal siguiente paso.
- En el script de transformación, asigne el
NetSuite: Las operaciones fallan debido a límites de registros de API
- Síntoma: Una operación que utiliza el conector de NetSuite falla o procesa menos registros de los esperados porque los datos de origen superan el límite de registros por llamada impuesto por la API de NetSuite.
- Causa: La API de NetSuite aplica limitaciones de tamaño a la cantidad de registros por solicitud. Cuando se envían más registros en una sola llamada de los que permite el límite, NetSuite rechaza el excedente.
- Resolución:
- Habilite la fragmentación en la operación en Opciones de operación. Cuando el origen es una actividad de NetSuite, la fragmentación divide los datos durante la transformación en lugar de al recuperarlos. Cada fragmento se escribe en un archivo temporal y los archivos se combinan en el destino final después de procesar todos los fragmentos.
- Cuando el destino es una actividad de NetSuite, cada fragmento de origen produce un fragmento de destino, y la transformación se aplica por separado a cada uno. Los fragmentos de destino resultantes se combinan luego.
- Para obtener instrucciones y mejores prácticas, consulte Habilitar fragmentación.
- Para obtener información de referencia más detallada, consulte información detallada sobre el fragmentado.
NetSuite: Se superó el límite de solicitudes concurrentes
- Síntoma: Las operaciones de NetSuite de alto volumen fallan con uno de los siguientes errores:
- Solicitudes RESTlet:
HTTP error code: 400 Bad Request/SuiteScript error code: SSS_REQUEST_LIMIT_EXCEEDED - Solicitudes de servicios web:
ExceededConcurrentRequestLimitFaultoExceededRequestLimitFault
- Solicitudes RESTlet:
- Causa: NetSuite aplica una gobernanza de concurrencia por cuenta, que limita el total combinado de solicitudes simultáneas de servicios web y RESTlet. El límite depende de su nivel de servicio y de la cantidad de licencias de SuiteCloud Plus. Por ejemplo, el nivel de servicio 1 con cinco licencias de SuiteCloud Plus permite 65 solicitudes simultáneas (15 + (5 × 10)). Superar este límite hace que NetSuite rechace el excedente de solicitudes.
- Resolución:
- Para agentes privados, establezca
MaxNumberOfOperationThreadsen la sección[OperationEngine]dejitterbit.confen un valor que mantenga el total de solicitudes simultáneas a NetSuite dentro del límite de gobernanza de su cuenta. - Diseñe las operaciones para serializar las solicitudes cuando sea posible, o implemente una lógica de reintento que espere y reintente cuando se reciba la respuesta
WS_CONCUR_SESSION_DISALLOWED. - Revise sus aplicaciones cliente de NetSuite para confirmar que manejan correctamente los códigos de error de concurrencia.
- Para obtener más detalles sobre los límites de gobernanza por nivel, revise las notas de lanzamiento de NetSuite 2017.2 (páginas 71 a 72).
- Para agentes privados, establezca
NetSuite: Las operaciones fallan después de actualizar la URL de WSDL
- Síntoma: Después de actualizar la URL de descarga de WSDL en una conexión de NetSuite para hacer referencia a una versión de WSDL más reciente, todas las operaciones que utilizan las actividades de esa conexión fallan en tiempo de ejecución.
- Causa: Cambiar la URL de descarga de WSDL actualiza la conexión, pero no actualiza los esquemas de datos que utilizan las transformaciones existentes. Las transformaciones siguen haciendo referencia a los campos de esquema de la versión anterior de WSDL, que son incompatibles con la nueva versión.
- Resolución: Para actualizar correctamente la versión de WSDL, siga los pasos en Cambiar la versión de WSDL. Este procedimiento actualiza tanto la URL de la conexión como los esquemas de datos utilizados por todas las actividades afectadas, evitando fallos en tiempo de ejecución causados por discrepancias de esquema.
NetSuite Create, Update u Upsert falla con "no es un valor válido para Country"
-
Síntoma: Una actividad Crear, Actualizar o Realizar upsert de NetSuite falla cuando el valor de origen de un campo de país no coincide con un valor enum
Countryde NetSuite:FaultString: org.xml.sax.SAXException: <country_value> is not a legal value for {urn:types.common_<version>.platform.webservices.netsuite.com}Country -
Causa posible: La API SuiteTalk de NetSuite requiere que
Country(y otros campos enumerados) sea uno de los valores enum predefinidos del WSDL (por ejemplo,_unitedStates). Se rechaza un nombre de país para mostrar, un código de país ISO o cualquier valor que no coincida exactamente con el enum del WSDL. - Solución:
- En la transformación que se asigna al objetivo de NetSuite, traduce el valor de país de origen al valor enum correspondiente de NetSuite antes de escribir. Un diccionario de referencia cruzada, una sentencia
Caseo una tabla de búsqueda funcionan para esto. - Construye la referencia cruzada a partir del enum
Countrydefinido en el WSDL de SuiteTalk de NetSuite que utiliza el conector. Los valores válidos cambian entre versiones de WSDL, así que siempre verifica contra la versión de WSDL configurada actualmente en la conexión. - Aplica el mismo enfoque a cualquier otro campo respaldado por un enum de NetSuite (por ejemplo,
State,Currency) donde los valores de origen aún no coinciden con el enum del WSDL.
- En la transformación que se asigna al objetivo de NetSuite, traduce el valor de país de origen al valor enum correspondiente de NetSuite antes de escribir. Un diccionario de referencia cruzada, una sentencia
Los conjuntos de entidades de OData v2 no se cargan con "No entity sets found"
-
Síntoma: La configuración de una actividad Consulta de OData que apunta a un servicio OData v2.0 devuelve un error al recuperar la lista de objetos, aunque la prueba de conexión sea exitosa:
An error occurred while fetching the data: Error while generating for query activity object list. The Exception is No entity sets found for the address provided. -
Causa posible: La compatibilidad con servicios OData V2 se agregó al conector OData en la versión del agente 11.59, a través de la configuración de conexión OData version. En agentes anteriores a la versión 11.59, el conector solo admite OData V4, por lo que una conexión que apunta a un servicio OData V2 no puede completar la lista de objetos. La misma falla ocurre en la versión 11.59 o posterior si OData version se deja en V4 para un servicio OData V2.
- Solución:
- Para agentes privados, actualiza a la versión 11.59 o posterior. Los agentes en la nube reciben la actualización automáticamente.
- En la conexión OData, establece OData version en V2 (el valor predeterminado es V4). Guarda y vuelve a probar la conexión.
- Reabre la actividad Consulta de OData. Los conjuntos de entidades deberían cargarse ahora.
OData: Microsoft Dynamics 365 devuelve solo los datos de la empresa predeterminada
- Síntoma: Una conexión OData a un punto final de Microsoft Dynamics 365 Finance and Operations devuelve datos solo para la empresa predeterminada del usuario, por lo que faltan registros de otras empresas en los resultados.
- Causa posible: Por defecto, un punto final OData de Dynamics 365 Finance and Operations devuelve solo los datos que pertenecen a la empresa predeterminada del usuario. Para dar a la conexión un alcance entre empresas (ampliado), se debe añadir una cláusula de filtro entre empresas a la URL de metadatos OData de la conexión (la URL
$metadata). En la URL de metadatos,?cross-company=truepor sí solo no aplica el alcance ampliado. - Solución: En la conexión OData, añade una cláusula de filtro
dataAreaIda la URL de metadatos OData, reemplazandousrtcon tu identificador de área de datos, y luego guarda y vuelve a probar:
?$filter=dataAreaId eq 'usrt'&cross-company=true
Para obtener información de fondo sobre cómo Dynamics 365 delimita los datos de OData por empresa, consulta la documentación de Microsoft sobre comportamiento entre empresas.
Oracle EBS: Error de conexión "el archivo JAR del proveedor personalizado no está presente"
-
Síntoma: La conexión a una instancia de Oracle E-Business Suite (EBS) falla con:
Error connecting to Oracle EBS instance. Error is: The custom provider JAR file is not present in the Jitterbit Private Agent or it is not in the right location ($JITTERBIT_HOME/Connectors/Providers) -
Causa posible: El conector Oracle EBS requiere que el controlador JDBC de Oracle (
ojdbc8.jar) se coloque manualmente en el agente privado. Este archivo no se incluye con el agente y debe agregarse antes de que la conexión pueda realizarse correctamente. - Resolución:
- Descarga
ojdbc8.jardel sitio web de Oracle (se requiere una cuenta de Oracle). - Coloca
ojdbc8.jaren el directorio$JITTERBIT_HOME/Connectors/Providers/en el host del agente privado. - Reinicia todos los agentes en el grupo de agentes.
- Prueba nuevamente la conexión de Oracle EBS.
- Descarga
Salesforce: Las operaciones fallan debido a límites de registros de API
-
Síntoma: Una actividad estándar de Salesforce (como Upsert) falla o procesa menos registros de lo esperado porque los datos de origen exceden el límite de registros por llamada. La operación puede fallar con:
EXCEEDED_ID_LIMIT: record limit reached. cannot submit more than 200 records into this call -
Causa: Las actividades estándar de Salesforce aceptan un máximo de 200 registros por llamada. Cuando se envían más registros en una sola llamada, Salesforce rechaza el exceso. Esto puede ocurrir de dos formas: la fragmentación no está habilitada, o está habilitada pero el origen no puede respetarla. La fragmentación se respeta solo cuando el origen es un conector nativo. Con cualquier otro origen, como HTTP v2, todos los registros se envían en una sola llamada independientemente del tamaño de fragmento configurado. Consulta La fragmentación requiere un conector nativo como origen.
- Resolución:
- Habilita la fragmentación en la operación y establece el tamaño de fragmento en 200 o menos. Para obtener instrucciones, consulta Habilitar fragmentación.
- Confirma que el tamaño de fragmento se aplique realmente a los datos de origen. Cuando el origen es una carga útil grande producida por otra actividad, verifica que la operación la divida en llamadas de 200 registros o menos. Si el límite se sigue excediendo a pesar de un tamaño de fragmento correcto, contacta con el soporte de Jitterbit.
- Para actividades masivas de Salesforce, aumenta el tamaño de fragmento predeterminado de 200 a un valor mayor, como 10,000, ya que las actividades masivas están diseñadas para manejar volúmenes altos de registros.
La fragmentación divide los datos durante la transformación en lugar de hacerlo en la recuperación. Cuando el origen es una actividad de Salesforce, cada fragmento se escribe en un archivo temporal y los archivos se combinan en el destino final después de procesar todos los fragmentos. Cuando el destino es una actividad de Salesforce, cada fragmento de origen produce un fragmento de destino, con la transformación aplicada por separado a cada uno, y los fragmentos de destino resultantes se combinan posteriormente. Para más detalles, consulta Información detallada sobre fragmentación.
Salesforce, Service Cloud y ServiceMax: La autenticación multifactor impide conexiones de autenticación básica
- Síntoma: Una conexión que utiliza Autenticación básica con el conector Salesforce, Salesforce Service Cloud o ServiceMax falla en la prueba de conexión, o se conecta pero falla en las operaciones con un error de autenticación.
- Causa: Estos conectores comparten la misma base de código y se autentican en una organización de Salesforce. La autenticación básica requiere una cuenta de Salesforce cuyo conjunto de permisos asignado no incluya el permiso Autenticación multifactor para inicios de sesión de API. Cuando se asigna ese permiso (MFA activo para la cuenta), las conexiones de autenticación básica fallan.
- Resolución:
- En Salesforce, revisa el conjunto de permisos asignado al usuario de inicio de sesión de integración del sistema y confirma que Autenticación multifactor para inicios de sesión de API no esté seleccionado. Los tipos de inicio de sesión de integración del sistema están exentos del requisito de MFA de Salesforce. Para más detalles, consulta las Preguntas frecuentes sobre autenticación multifactor de Salesforce.
- Si no se puede eliminar MFA del usuario de integración, cambia la conexión a autenticación OAuth 2.0 de dos patas.
Nota
El uso de OAuth 2.0 de dos patas requiere la versión del agente 11.59 o posterior. En agentes 12.x, requiere 12.3 o posterior para el conector de Salesforce, y 12.4 o posterior para los conectores de Salesforce Service Cloud y ServiceMax.
Certificado de Salesforce: Falta de coincidencia del Nombre Alternativo del Sujeto (SAN)
-
Síntoma: Una conexión de Salesforce a un sandbox u organización con dominios mejorados habilitados falla con:
Certificate for <url> doesn't match any of the subject alternative names -
Posibles causas:
- El certificado no incluye la URL de MyDomain o sandbox de Salesforce en sus Nombres Alternativos del Sujeto.
- La casilla Sandbox en la configuración de conexión de Salesforce no está activada correctamente.
-
Resolución:
- Inspecciona las entradas SAN del certificado usando OpenSSL:
openssl x509 -in cert.crt -text -noout. Confirma que la sección Nombre Alternativo del Sujeto incluya tu URL de MyDomain de Salesforce. - En la configuración de conexión de Salesforce en Studio, verifica que la casilla Sandbox esté correctamente configurada para tu organización de destino.
- Si la URL de Salesforce no está presente en los SAN, regenera el certificado para incluir el dominio específico.
- Si la misma conexión funciona en un grupo de agentes en la nube pero falla en un agente privado, la causa podría ser una extensión SNI faltante en el protocolo de enlace TLS del agente. Consulta La conexión al sandbox de Salesforce falla con falta de coincidencia de certificado.
- Inspecciona las entradas SAN del certificado usando OpenSSL:
Conexión, configuración u operación de Salesforce falla intermitentemente con SERVER_UNAVAILABLE
-
Síntoma: Una prueba de conexión de Salesforce, configuración de actividad u operación falla intermitentemente con:
SERVER_UNAVAILABLE: server temporarily unavailablePor ejemplo, esto puede ocurrir al seleccionar un objeto durante la configuración de la actividad.
-
Posible causa: Salesforce devuelve este código de fallo cuando su propio servidor no puede procesar temporalmente la solicitud; el conector lo reporta con este mensaje genérico en lugar de pasar texto más específico de Salesforce.
- Resolución: Reintenta la prueba de conexión, el paso de configuración u operación, esperando más tiempo entre cada intento si continúa fallando. Si el error persiste u ocurre frecuentemente, consulta Salesforce Trust para verificar si hay un incidente reportado que afecte tu instancia, o contacta al Soporte de Salesforce. Un escenario relacionado se describe en el artículo de Salesforce SERVER_UNAVAILABLE: Too Many Requests Waiting for Connections.
Salesforce: El esquema de datos no incluye campos agregados recientemente
- Síntoma: Un campo agregado recientemente a un objeto de Salesforce no aparece en el esquema de transformación al configurar una actividad de Salesforce.
- Causa: El esquema de datos se almacena en caché desde la última vez que se configuró la actividad y no se actualiza automáticamente.
- Resolución: Abre la configuración de la actividad y avanza a través de cada paso. Realiza al menos un cambio menor (como agregar y eliminar un carácter del nombre de la actividad) para forzar una recarga del esquema. Haz clic en Finalizado para guardar la configuración actualizada.
Salesforce: El mapeo automático no asigna campos cuando una actividad de Salesforce es el destino
- Síntoma: Cuando una actividad de Salesforce (como Insertar o Actualizar o insertar) se utiliza como destino de una transformación, usar Automap no asigna ningún campo.
- Causa: El esquema de la actividad de Salesforce incluye un nodo raíz adicional encima de los campos del objeto cuando se refleja el esquema. Este nodo raíz adicional impide que automap coincida los campos de origen con los campos de destino correctos.
- Resolución:
- En el lienzo de transformación, localiza el nodo de objeto de nivel superior en el lado del destino (por ejemplo, Cuenta).
- Arrastra el nodo de origen correspondiente para alinearlo manualmente.
- Con los nodos alineados, ejecuta Automap nuevamente. Los campos bajo el nodo se asignarán automáticamente.
Actividad de consulta de Salesforce: La consulta padre-hijo genera esquema jerárquico
- Síntoma: Una actividad de consulta de Salesforce que utiliza una consulta SOQL de relación padre-hijo genera un esquema de respuesta jerárquico. Cuando este esquema se refleja en el lado del destino de una transformación, la salida es XML jerárquico en lugar de una estructura plana.
- Causa: El esquema jerárquico refleja la relación padre-hijo en la consulta. Reflejar el esquema de origen en el destino de la transformación preserva esa jerarquía en la salida.
- Resolución:
- Para producir una salida plana, define un esquema plano en el lado del destino de la transformación en lugar de reflejar el esquema de origen.
- Si accedes a los resultados de la consulta en un script, los datos ya están disponibles como una estructura plana sin ninguna configuración adicional.
Salesforce: La operación de actualización masiva falla para algunos registros (ID externo duplicado)
- Síntoma: Una operación Upsert o Bulk Upsert de Salesforce se completa pero reporta fallos en algunos registros.
- Causa: Múltiples registros de origen comparten el mismo valor de ID externo. Cuando el ID externo no es único, Salesforce devuelve un error y el upsert falla para esos registros.
- Resolución:
- Revisa el archivo de fallos en la página Runtime de la Consola de Administración (pestaña Activity Logs) para identificar qué registros fallaron.
- Asegúrate de que el campo utilizado como ID externo tenga un valor único para cada registro. Consulta Crear un ID externo de Salesforce para Jitterbit.
Actividad de inserción o actualización de Salesforce: El campo de ID de registro no se puede asignar
- Síntoma: Una transformación incluye una asignación al campo Record ID de Salesforce en una actividad Insert o Update, pero la operación no utiliza el valor asignado.
- Causa: El campo Record ID de Salesforce no puede contener una asignación en las actividades Insert y Update. Salesforce asigna el Record ID automáticamente al insertar; la actividad Update identifica registros por su ID de Salesforce existente, que no es un campo de destino asignable.
- Resolución: Elimina la asignación al campo Record ID de la transformación. Si el objetivo es actualizar un registro específico por su ID de Salesforce, verifica que los datos de origen proporcionen ese ID y que la actividad Update esté configurada para coincidir con él.
Actividades de escritura masiva de Salesforce: Se omite el primer registro de datos cuando el origen no tiene fila de encabezado
- Síntoma: Una actividad de escritura masiva de Salesforce (Bulk Insert, Bulk Upsert, Bulk Update, Bulk Delete o Bulk Hard Delete) se ejecuta sin error pero se escriben menos registros de lo esperado en Salesforce. Cuando el origen contiene solo un registro de datos, no se escribe ningún registro.
- Causa: Las actividades de escritura masiva de Salesforce siempre tratan la primera fila de datos de origen como la fila de encabezado de columna. Este comportamiento no se puede cambiar. Si el archivo de origen no incluye una fila de encabezado dedicada, el primer registro de datos se consume como encabezado y no se escribe en Salesforce.
- Resolución:
- Asegúrate de que los datos de origen incluyan una fila de encabezado como primera fila. Los valores del encabezado deben coincidir con los nombres de columna definidos en la asignación de campos de la actividad.
- Verifica que las filas de datos comiencen en la segunda fila, inmediatamente después del encabezado.
Los pasos de operación de actividad masiva de Salesforce se muestran como "Incompleto" sin datos de entrada o salida
- Síntoma: Al ver un registro de operación que incluye una actividad masiva de Salesforce (Bulk Insert, Bulk Upsert, Bulk Update, Bulk Delete o Bulk Hard Delete), la entrada del paso de operación de la actividad masiva muestra un estado de Incomplete y no muestra datos de entrada o salida, incluso cuando la operación se completó exitosamente y se procesaron registros.
- Causa: Las actividades masivas de Salesforce no generan datos de entrada y salida de componentes en el registro de operación. El estado Incomplete en el paso de actividad y la ausencia de datos de entrada y salida son comportamiento esperado para todas las actividades masivas, independientemente de si el procesamiento fue exitoso.
- Resolución:
- Para determinar si se procesaron registros y si ocurrieron errores, revisa las entradas de texto en el registro de operación para buscar mensajes de error o confirmación de procesamiento exitoso.
- Para agentes privados, también puedes descargar resultados detallados por registro: en la Consola de Administración, ve a la página Runtime, selecciona la ejecución, abre la pestaña Activity Logs y descarga el archivo de resultados.
Las actividades masivas de Salesforce fallan cuando se activan mediante una solicitud de API o SOAP
-
Síntoma: Una actividad masiva de Salesforce (Bulk Query, Bulk Update, Bulk Insert, Bulk Upsert, Bulk Delete o Bulk Hard Delete) falla inmediatamente durante la inicialización con:
Failed to initialize the operation: Failed to get the operation with OperationID = [ID].
A database exception occurred. The reported error was:
ERROR: null value in column "organization_id" of relation "bulkloadinstancetab" violates not-null constraint
La misma actividad masiva se ejecuta sin problemas cuando se activa de forma independiente o a través de otros medios.
-
Causa posible: Las operaciones activadas mediante una solicitud de API o SOAP (como un flujo de mensaje saliente de Salesforce) no admiten actividades masivas de Salesforce. En este contexto, el ID de la organización no está disponible para el subsistema de carga masiva, lo que causa el error de restricción de base de datos durante la inicialización.
- Resolución: Reemplaza la actividad masiva con la actividad estándar de Salesforce equivalente en operaciones que forman parte de una cadena activada por API o SOAP. Por ejemplo, reemplaza una Bulk Query con una actividad estándar de Query, o una Bulk Update con una actividad estándar de Update. Las actividades estándar funcionan correctamente en este contexto.
Eventos de Salesforce: Los eventos no se pueden habilitar después del reinicio del agente
- Síntoma: Después de reiniciar o reinstalar un agente privado, los eventos del conector Eventos de Salesforce no se habilitan, incluso cuando las credenciales de conexión son correctas.
- Causa posible: Después de un reinicio, es posible que el archivo JAR del conector aún no esté presente en el agente. Habilitar un evento requiere que el conector se descargue primero en el agente.
- Resolución:
- Abre la configuración de conexión de Eventos de Salesforce en Studio.
- Haz clic en Test para probar la conexión. Esto fuerza la descarga del JAR del conector al agente.
- Después de que la prueba de conexión sea exitosa, intenta habilitar el evento nuevamente.
Eventos de Salesforce: Limitaciones de actividad de escucha
Los siguientes comportamientos de las actividades de escucha de Eventos de Salesforce (Suscribirse a evento y las actividades de eventos CDC de Inserción, Actualización y Eliminación) son esperados y no indican un defecto del conector:
- Los eventos no se pueden habilitar porque se alcanzó el número máximo de suscriptores. La instancia de Salesforce limita el número de clientes simultáneos (suscriptores). Cuando se alcanza ese límite, no se pueden habilitar más eventos. Reduce el número de suscriptores activos conectados a la instancia.
- Los símbolos de medida como
$y%faltan en la respuesta. Estos símbolos no se devuelven por diseño de la API de Salesforce. - Los campos sin modificar se devuelven como null en las respuestas de Captura de datos de cambios (CDC). Para actividades de CDC, solo se rellenan los campos modificados; los campos sin modificar se devuelven como null, por diseño de la API de Salesforce.
Múltiples actividades de SAP en una operación fallan en tiempo de ejecución
- Síntoma: Una operación que contiene más de una actividad de SAP o que combina una actividad de SAP con una actividad de NetSuite, Salesforce, Salesforce Service Cloud, ServiceMax o SOAP se implementa sin errores de validación pero falla al ejecutarse.
- Causa posible: Las operaciones que mezclan estos tipos de actividades parecen válidas en Studio y se pueden implementar correctamente, pero estas combinaciones no se admiten en tiempo de ejecución. Las reglas de validación de operaciones no marcan este patrón como un error en tiempo de diseño. Se trata de un problema conocido de Studio documentado.
- Resolución:
- Diseña cada operación para que contenga solo una actividad de SAP, sin otras actividades de SAP, NetSuite, Salesforce, Salesforce Service Cloud, ServiceMax o SOAP en la misma operación.
- Si se necesitan datos de múltiples sistemas en un único flujo de trabajo, divide la lógica en operaciones separadas y encadénalas usando acciones de operación.
SAP RFC: "Sin autorización de RFC para el módulo de función BAPI_TRANSACTION_COMMIT"
-
Síntoma: Una actividad de RFC de SAP falla en tiempo de ejecución con:
JCoException occurred No RFC authorization for function module BAPI_TRANSACTION_COMMIT -
Causas posibles:
- La cuenta de usuario de SAP en la conexión no tiene autorización S_RFC para
BAPI_TRANSACTION_COMMITo sus grupos de funciones relacionados. - El módulo de función
BAPI_TRANSACTION_COMMITno está configurado como habilitado para acceso remoto en el sistema SAP. - La transformación de solicitud anterior a la actividad no establece el campo de control de confirmación.
- La cuenta de usuario de SAP en la conexión no tiene autorización S_RFC para
-
Resolución:
- En el sistema SAP, confirma que el módulo de función
BAPI_TRANSACTION_COMMITestá habilitado para acceso remoto. - En la transformación de solicitud que precede a la actividad de RFC de SAP, establece el campo
BAPI_COMMITentrue. - Verifica que la cuenta de usuario de SAP referenciada en la conexión tenga autorización S_RFC para
BAPI_TRANSACTION_COMMITy todos los grupos de funciones relacionados. - Si el problema persiste, comunícate con tu administrador de BASIS de SAP para que revise las asignaciones de objetos de autorización del usuario.
- En el sistema SAP, confirma que el módulo de función
Conexión a SAP falla con "Clave de idioma inválida"
-
Síntoma: Una conexión de SAP falla durante la inicialización con un error sobre la clave de idioma:
Connector Error: AdapterResourceException: Error while creating Destination. 00024Invalid language key when configuring the text environment. -
Causa posible: El código de Idioma configurado en el punto de conexión de SAP no es válido para el sistema SAP de destino: el código no está instalado o no se admite en ese sistema, o está mal escrito o tiene incorrecta capitalización (por ejemplo,
enen lugar deEN). SAP rechaza la clave no válida al inicializar el entorno de texto del destino. - Resolución:
- Edita el punto de conexión de SAP en Studio y establece el campo Idioma en un código de idioma válido de dos letras (por ejemplo,
ENpara inglés). - Verifica que el valor coincida con un idioma instalado y activo en el sistema SAP de destino. Si tienes dudas, confirma el idioma predeterminado del usuario de integración en el perfil de usuario de SAP y utiliza ese.
- Prueba la conexión desde Studio para confirmar que la inicialización se realiza correctamente antes de volver a implementar la operación.
- Edita el punto de conexión de SAP en Studio y establece el campo Idioma en un código de idioma válido de dos letras (por ejemplo,
ServiceNow: Las primeras ejecuciones de operaciones son lentas después del reinicio del agente o en agentes en la nube
-
Síntoma: Las operaciones que utilizan el conector ServiceNow se ejecutan lentamente en dos escenarios:
- En agentes privados, la primera operación después del reinicio del agente puede tardar varios minutos; las ejecuciones posteriores son rápidas.
- En agentes en la nube, las ejecuciones son intermitentemente lentas, tardando minutos cada vez que se actualiza la caché de metadatos del conector.
Esto puede causar tiempos de espera de API en cascada.
-
Posible causa: El conector almacena en caché los metadatos de ServiceNow de forma agresiva. Después de un reinicio del agente en un agente privado (o en cada ejecución de un agente en la nube que no conservó la caché), la primera operación debe reconstruir la caché, lo que tarda varios minutos.
- Solución:
- En un agente privado, mitigar la lentitud posterior al reinicio agregando
getcolumnsmetadata=onUsea las Opciones avanzadas del endpoint de ServiceNow. Esta configuración solo es efectiva en agentes privados. - Para un rendimiento consistente en agentes en la nube, llamar a la API REST de ServiceNow a través del conector HTTP v2 en lugar de utilizar el conector de ServiceNow. El conector HTTP v2 no almacena en caché los metadatos y evita el retraso de reconstrucción.
- En un agente privado, mitigar la lentitud posterior al reinicio agregando
ServiceNow v2: Un objeto no se enumera por su nombre de conector de ServiceNow
- Síntoma: Un objeto que es seleccionable por un nombre familiar en el conector ServiceNow no se puede encontrar con ese mismo nombre en el conector ServiceNow v2.
- Causa: El uso de la API REST de ServiceNow por parte del conector ServiceNow v2 expone objetos utilizando el nombre real de la tabla backend de ServiceNow, que puede diferir del nombre utilizado para el mismo objeto en el conector de ServiceNow. Por ejemplo, el objeto denominado
Systemen el conector de ServiceNow corresponde aSysen el conector de ServiceNow v2. - Solución: En ServiceNow, buscar el nombre de tabla real del objeto en System Definition > Tables, luego buscar ese nombre en la configuración de actividad del conector de ServiceNow v2.
Shopify: Las selecciones del objeto Activity pueden cambiar después de una actualización de versión de API
- Síntoma: Después de cambiar la versión de API en una conexión de Shopify, una o más actividades de Shopify devuelven errores o se comportan de manera inesperada, y un objeto o subobjeto configurado parece haber cambiado.
- Posible causa: Shopify lanza nuevas versiones de API trimestralmente y depreca las versiones anteriores después de 12 meses. Al cambiar a una versión de API diferente, los objetos o subobjetos que no están disponibles en la nueva versión pueden dejar de ser seleccionables, lo que causa que la selección configurada de la actividad cambie cuando se actualiza la configuración.
- Solución:
- Después de cambiar la versión de API de Shopify en la conexión, abrir cada configuración de actividad de Shopify afectada.
- Hacer clic en Actualizar para recargar los objetos disponibles para la nueva versión de API.
- Revisar las selecciones de objeto y subobjeto para confirmar que reflejan tu intención en la nueva versión.
- Actualizar cualquier selección que cambió a los objetos de reemplazo correctos.
- Reimplementar y volver a probar las operaciones afectadas.
- Para obtener información sobre los plazos de deprecación de la versión de API de Shopify, consultar el registro de cambios de Shopify.
Snowflake: Error de espacio de memoria Java al consultar grandes volúmenes de datos
-
Síntoma: Una actividad Snowflake Query falla con el siguiente error cuando la consulta devuelve un gran número de filas:
Error executing query activity. Exception is Java heap spaceEl conector reporta el error en esta forma porque envuelve el error de Java subyacente, que aparece más abajo en el seguimiento de pila:
Caused by: java.lang.OutOfMemoryError: Java heap spaceSi este error ocurre en consultas que devuelven pocas filas, o el mismo agente también falla con errores de pila a través de otros conectores, la causa es más probable que sea la asignación general de pila del agente que el tamaño del conjunto de resultados. Consulta Java heap space:
OutOfMemoryError. -
Causa posible: El conector de Snowflake carga el conjunto completo de resultados de la consulta en memoria JVM antes de pasarlo a la transformación. Con conjuntos de resultados muy grandes, esto agota la pila JVM de Tomcat en el agente privado.
-
Resolución: Para volúmenes grandes de consultas, utiliza el conector de Base de datos con un controlador JDBC de Snowflake en lugar del conector de Snowflake. El conector de Base de datos no almacena en búfer el conjunto de resultados completo en memoria, por lo que puede manejar volúmenes de consultas mucho más grandes. Instala el controlador JDBC de Snowflake en el agente privado y luego configura una conexión de Base de datos que lo utilice. En el agente 12.x y versiones posteriores, esa conexión de Base de datos también necesita
enableArrowResultFormat=false&jdbc_query_result_format=jsonen su cadena de conexión; consulta Snowflake: Las operaciones fallan en el agente 12.x.Si necesitas mantener el conector de Snowflake, cualquiera de las siguientes opciones puede reducir la presión de memoria, aunque ninguna garantiza ser suficiente para conjuntos de datos de millones de filas:
- Divide la consulta en lotes utilizando las cláusulas SQL
LIMITyOFFSET, ejecutando la operación repetidamente con desplazamientos incrementales hasta que se procesen todas las filas. - Aumenta el tamaño del montón JVM de Tomcat en el agente privado (consulta Memoria del montón de Tomcat).
- Divide la consulta en lotes utilizando las cláusulas SQL
Snowflake: Las operaciones fallan en el agente 12.x
-
Síntoma: En un agente privado que ejecuta la versión 12.x, las operaciones que consultan Snowflake a través de un controlador JDBC de Snowflake (una conexión de Base de datos o un script
DBExecute) fallan en tiempo de ejecución, aunque la prueba de conexión sea exitosa. El error hace referencia a la capa de memoria Arrow del controlador, por ejemplo:JDBC driver internal error: exception creating result java.lang.ExceptionInInitializerError at net.snowflake.client.jdbc.internal.apache.arrow.memory.unsafe.UnsafeAllocationManagero:
JDBC driver internal error: exception creating result java.lang.NoClassDefFoundError: Could not initialize class net.snowflake.client.jdbc.internal.apache.arrow.memory.RootAllocator -
Posible causa: Por defecto, el controlador JDBC de Snowflake devuelve los resultados de las consultas en formato Apache Arrow, que no es compatible con la versión 12.x del agente y posteriores. Consulta el artículo de solución de problemas de Snowflake sobre este error del módulo Java para más detalles. La prueba de conexión no devuelve ningún conjunto de resultados, por lo que sigue siendo exitosa mientras que las consultas fallan. Actualizar la versión del controlador JDBC no lo resuelve.
-
Resolución: Establece
enableArrowResultFormatenfalseyjdbc_query_result_format(oJDBC_QUERY_RESULT_FORMAT) enjsonpara que el controlador devuelva los resultados en JSON en lugar de Arrow:- Conector de Base de datos: Agrega
enableArrowResultFormat=false&jdbc_query_result_format=jsona la cadena de conexión de Snowflake, en el campo Parámetros adicionales de la cadena de conexión (o el campo Cadena de conexión, si se selecciona Usar cadena de conexión). - Conector de Snowflake: En Configuración opcional > Propiedades personalizadas de la conexión, agrega
enableArrowResultFormatcon un valor defalse. Una filaJDBC_QUERY_RESULT_FORMATcon un valor deJSONya está presente allí por defecto.
Luego guarda, vuelve a probar la conexión y ejecuta nuevamente la operación.
En un agente privado, puedes aplicar la corrección a nivel de JVM para que no sea necesario repetirla por conexión, agregando
--add-opens=java.base/java.nio=ALL-UNNAMEDaCATALINA_OPTS:Agrega la siguiente línea a
/opt/jitterbit/tomcat/bin/setenv.sh:export CATALINA_OPTS="$CATALINA_OPTS --add-opens=java.base/java.nio=ALL-UNNAMED"Luego reinicia el agente.
- Abre el Editor del Registro y encuentra la siguiente clave:
- Conector de Base de datos: Agrega
HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\Apache Software Foundation\Procrun 2.0\Jitterbit Tomcat Server\Parameters\Java
- Abre la subclave Options.
- En el campo Value data, agrega
--add-opens=java.base/java.nio=ALL-UNNAMEDa las opciones de Java existentes. - Haz clic en Ok.
- Reinicia el agente.
Utiliza una de las siguientes estrategias para aplicar la configuración:
-
Actualiza el Dockerfile y reconstruye la imagen de Docker:
docker build -t my-agent . -
Inclúyelo en el comando
runde Docker:docker run -e CATALINA_OPTS="--add-opens=java.base/java.nio=ALL-UNNAMED" my-agent -
Inclúyelo en
docker-compose.ymly reinicia el contenedor:environment: - CATALINA_OPTS=--add-opens=java.base/java.nio=ALL-UNNAMED
Snowflake: Las conexiones basadas en contraseña fallan después de la deprecación de autenticación
-
Síntoma: Las operaciones que se conectan a Snowflake utilizando el tipo de autenticación Contraseña (Depreciada) han comenzado a fallar después de funcionar previamente, por ejemplo con:
HttpErrorResponse: Error opening connection. Exception is Failed to authenticate: MFA authentication is required, but none of your current MFA methods are supported for programmatic authentication. -
Posible causa: Snowflake está eliminando gradualmente la autenticación de un solo factor (solo contraseña), incluidas las cuentas de tipo
LEGACY_SERVICErequeridas para este tipo de autenticación. Snowflake migra cuentasLEGACY_SERVICEaTYPE=SERVICEde forma escalonada y por cuenta, lo que bloquea completamente la autenticación basada en contraseña; algunas cuentas también tienen habilitada la autenticación multifactor (MFA), que es incompatible con esta conexión completamente automatizada y programática ya que MFA requiere intervención humana. Consulta Contraseña (Depreciada) para conocer la cronología de depreciación. - Resolución: Actualiza la conexión del conector de Snowflake en Studio para usar autenticación OAuth o Par de claves, y configura la cuenta de usuario de Snowflake en consecuencia, asegurándote de que no esté inscrita en MFA.
Snowflake: La instancia de desarrollador está durmiendo, las tablas de metadatos no se están completando
- Síntoma: Al configurar una actividad de Snowflake, la lista de objetos disponibles no se rellena o aparece vacía, aunque la prueba de conexión sea exitosa.
- Posible causa: Las instancias de desarrollador de Snowflake entran en estado de suspensión cuando no se ha accedido a ellas recientemente. Aunque la prueba de conexión puede ser exitosa contra una instancia suspendida, es posible que la instancia no devuelva metadatos de tablas y objetos.
- Resolución:
- Inicia sesión en la interfaz web de Snowflake para activar la instancia.
- Reabre la conexión de Snowflake en Studio y haz clic en Probar para reintentar las credenciales.
- Reabre la configuración de la actividad para actualizar la lista de objetos disponibles.
Snowflake Query: La falta de coincidencia de mayúsculas en el nodo raíz del esquema plano genera error de ProcessFlatStream
-
Síntoma: Una actividad Query de Snowflake que utiliza un esquema plano falla en tiempo de ejecución con:
StartElement() error, starting element does not match with the root.
qName= "<table_name_lowercase>", root name="<TABLE_NAME_UPPERCASE>"

ProcessFlatStream error
Este error ocurre cuando la consulta incluye una cláusula WHERE, una cláusula LIMIT o una referencia de variable en una cláusula WHERE.
-
Posible causa: El conector de Snowflake devuelve el nombre de la tabla en minúsculas en la respuesta XML. Cuando Studio genera un esquema plano a partir de la consulta, el nombre del nodo raíz se crea en mayúsculas. La falta de coincidencia entre el nodo raíz del esquema (mayúsculas) y el nodo raíz de la respuesta XML (minúsculas) causa que falle el procesamiento de flujo plano.
- Resolución: Elige una de las siguientes opciones:
- En el esquema plano, cambia el nombre del nodo raíz a minúsculas para que coincida con la salida del conector. Por ejemplo, cambia el nombre de
SALES_ORDERSasales_orders. - Utiliza el esquema espejo con asignación predeterminada en lugar de un esquema plano construido manualmente. El esquema espejo obtiene su estructura directamente de la respuesta del conector y no tiene esta falta de coincidencia de mayúsculas y minúsculas.
- En el esquema plano, cambia el nombre del nodo raíz a minúsculas para que coincida con la salida del conector. Por ejemplo, cambia el nombre de
Snowflake Merge: stageName y fileContent faltan en el esquema de solicitud para etapas externas
- Síntoma: Una actividad Merge de Snowflake configurada contra una etapa externa muestra un esquema de solicitud sin los campos
stageNameyfileContent. La misma actividad configurada contra una etapa interna expone ambos campos. - Causa posible: Las etapas externas son referencias de solo lectura a archivos que ya existen en almacenamiento en la nube externo (S3, GCS o Azure Blob). La actividad Merge no puede cargar contenido de archivo en una etapa externa, por lo que el esquema omite los campos que impulsan esa carga.
- Resolución:
- Cuando la actividad apunta a una etapa externa, asegúrate de que los archivos de datos ya estén presentes en la ubicación de almacenamiento en la nube a la que hace referencia la etapa. La actividad Merge lee directamente de esos archivos; no se necesita un campo
fileContent. - Cuando necesites enviar contenido de archivo desde la operación, configura la actividad Merge para usar una etapa interna. El esquema entonces expone
stageNameyfileContent.
- Cuando la actividad apunta a una etapa externa, asegúrate de que los archivos de datos ya estén presentes en la ubicación de almacenamiento en la nube a la que hace referencia la etapa. La actividad Merge lee directamente de esos archivos; no se necesita un campo
Snowflake Insert o Merge: Errores de sintaxis SQL causados por caracteres especiales
-
Síntoma: Una actividad Snowflake Insert o Merge falla con un error de compilación SQL como:
SQL compilation error:
syntax error line 1 at position <n> unexpected '<token>'.
Los valores de columna también pueden parecer mal asignados, con datos de un campo apareciendo en la columna incorrecta.
-
Causas posibles:
- Los valores de campo que contienen comillas simples (por ejemplo, un valor como
corner's) no se escapan antes de incluirse en la carga SQL. La comilla sin escape termina la cadena prematuramente, causando que el resto del valor se interprete como sintaxis SQL en lugar de datos. - Un nombre de columna de destino contiene un carácter especial, como un guion (por ejemplo,
Zip-Code). Snowflake requiere que un identificador que contenga un carácter especial esté entre comillas; sin comillas, produce un error de sintaxis en el guion.
- Los valores de campo que contienen comillas simples (por ejemplo, un valor como
-
Resolución:
- Para valores que contienen comillas simples: En la Configuración opcional de la conexión de Snowflake, habilita Escape special characters. Esto escapa automáticamente las comillas simples en las cargas de actividades Insert e Invoke Stored Procedure. Para actividades Merge, o como alternativa para Insert, utiliza
SQLEscapeen la asignación de transformación para escapar las comillas simples en los valores de campo afectados antes de que lleguen a la actividad. - Para nombres de columna que contienen caracteres especiales: Confirma que Use quote for Snowflake identifiers está habilitado en la conexión (habilitado por defecto).
- Para valores que contienen comillas simples: En la Configuración opcional de la conexión de Snowflake, habilita Escape special characters. Esto escapa automáticamente las comillas simples en las cargas de actividades Insert e Invoke Stored Procedure. Para actividades Merge, o como alternativa para Insert, utiliza
Error de implementación SOAP: "No WSDL with locator"
-
Síntoma: La implementación de un proyecto que incluye una conexión SOAP, o una actividad SOAP Request o SOAP Response de API, falla con:
Failed to deploy - Internal Error: No WSDL with locator -
Posibles causas:
-
Se eliminó el WSDL, se reimportó o su referencia interna se dañó, por lo que el proyecto hace referencia a un identificador de WSDL que ya no existe.
-
El proyecto se implementó o se transfirió a otro entorno, antes de la versión 12.9 de Harmony, cuando la implementación de un proyecto podía eliminar archivos WSDL que seguían en uso. La versión 12.9 previene la eliminación, pero un WSDL eliminado antes debe cargarse nuevamente.
-
-
Resolución:
-
Recarga el WSDL del componente afectado:
- Para una conexión SOAP, abre la conexión y selecciona Upload URL o Upload file (no Select existing), recarga el WSDL, revisa la configuración de Port y Select methods, luego haz clic en Save Changes.
- Para una actividad SOAP Request o SOAP Response de API, abre la actividad y recarga el WSDL en el paso 1 de su configuración.
-
Revisa las transformaciones que heredan esquemas del WSDL recargado y regeneralas si es necesario.
-
Vuelve a implementar el proyecto.
-
Si el proyecto tiene varios WSDLs y no está claro cuál se ve afectado, consulta Solución de problemas de conexión SOAP para identificarlo desde una exportación JSON.
-
SOAP WSDL: schemaLocation debe utilizar referencias relativas
- Síntoma: Una conexión SOAP que hace referencia a un WSDL con archivos de esquema XSD importados falla al cargarse o produce errores de resolución de esquema en tiempo de diseño.
- Posible causa: El WSDL utiliza URLs absolutas en sus atributos
schemaLocationpara archivos XSD importados (por ejemplo,http://example.com/schema.xsd). El agente no puede obtener esquemas desde URLs remotas absolutas al cargar un WSDL importado localmente. - Resolución:
- Edita el WSDL para que todas las referencias de
schemaLocationusen rutas relativas (por ejemplo,schema.xsden lugar dehttp://example.com/schema.xsd). - Coloca todos los archivos XSD referenciados en el mismo directorio que el WSDL e importa nuevamente el WSDL en la conexión SOAP.
- Edita el WSDL para que todas las referencias de
El conector SOAP reescribe los prefijos y la estructura del espacio de nombres XML
- Síntoma: El sobre XML que produce una actividad SOAP no coincide con los prefijos de espacio de nombres literales o la estructura del WSDL fuente (por ejemplo, el conector sustituye
xmlns:ns1porxmlns:glob). Los servicios SOAP estrictos que comparan el texto exacto del prefijo rechazan la solicitud. - Posible causa: El motor de transformación procesa los mensajes SOAP como XML estructurado, no como texto literal. Produce una carga útil semánticamente equivalente que puede usar diferentes prefijos de espacio de nombres que el WSDL fuente.
- Resolución: Para servicios SOAP que requieren una estructura XML literal, omite el conector SOAP y crea la carga útil de la solicitud como cadena:
- Crea una conexión HTTP v2 que apunte a la URL del servicio SOAP.
- En una transformación, construye el sobre SOAP como una cadena, concatenando literales de cadena y valores asignados con el operador
+. También puedes leer una plantilla de un archivo y sustituir valores dinámicos conReplace. - En la actividad POST de HTTP v2, usa el esquema de solicitud predeterminado (no cargues un esquema de solicitud personalizado) y asigna el sobre SOAP construido al campo
bodyde ese esquema. El conector envía el valorbodytal cual, preservando el XML literal. - Establece el encabezado Content-Type en
text/xmloapplication/soap+xml, y establece el encabezadoSOAPActionsi el servicio lo requiere. - Lee la respuesta del servicio desde el campo
responseContentdel esquema de respuesta predeterminado de la actividad.
SOAP: Los mensajes MTOM/XOP no son compatibles
- Síntoma: El conector SOAP no es compatible con mensajes SOAP MTOM/XOP (Mecanismo de optimización de transmisión de mensajes).
- Resolución: Usa la solución alternativa en Compatibilidad con mensajes SOAP MTOM/XOP usando Jitterbit Studio, que crea la solicitud MTOM fuera del conector SOAP.
VTEX: La prueba de conexión falla con "You don't have permission to access this resource"
-
Síntoma: Una prueba de conexión de VTEX falla con un error de permisos en Studio aunque las mismas credenciales funcionan en herramientas externas como Postman.
You don't have permission to access this resource -
Posible causa: La clave de usuario o aplicación de VTEX asociada con la conexión carece de uno o más permisos que el conector usa para validar la conexión. Estos permisos son más estrictos que los necesarios para el acceso básico a datos.
- Resolución:
- En el portal de administración de VTEX, abre el perfil de acceso asignado al usuario o clave de aplicación que Jitterbit está usando.
- Confirma que el perfil de acceso incluye la característica License Manager con acceso al recurso Get account by identifier.
- Guarda el perfil y vuelve a probar la conexión de VTEX en Studio.
Workday: WSDL v42.0 y v42.1 devuelven errores para servicios específicos
- Síntoma: Las operaciones que usan el conector Workday configurado con la versión WSDL 42.0 o 42.1 fallan al acceder a los servicios web Human_Resources o Resource_Management.
- Posible causa: Se sabe que WSDL v42.0 devuelve errores para los servicios Human_Resources (v42.0) y Resource_Management (v42.0). Se sabe que WSDL v42.1 devuelve errores para el servicio Human_Resources (v42.1). Estos son problemas conocidos específicos de esas versiones de WSDL.
- Resolución:
- En la configuración de la conexión de Workday, cambia la versión de WSDL a 41.x o 43.0 o posterior para operaciones que usan los servicios Human_Resources o Resource_Management.
- Prueba la conexión y vuelve a ejecutar las operaciones afectadas para confirmar que el problema se ha resuelto.
Workday: La prueba de conexión falla con "The task submitted is not authorized"
-
Síntoma: Una prueba de conexión de Workday falla con:
Error occurred while opening connection. The Exception is Processing error occurred. The task submitted is not authorized.Este error puede ocurrir tanto con autenticación Basic Auth como con JWT Bearer. Ten en cuenta que las operaciones pueden ejecutarse correctamente en tiempo de ejecución incluso cuando la prueba de conexión devuelve este error, porque la prueba llama a un servicio específico de Workday (
Get_Message_Template_Translation_Request) que requiere un permiso que la ISU podría no tener, mientras que las operaciones reales de integración llaman a servicios diferentes. -
Causas posibles:
- El Usuario del Sistema de Integración (ISU) no ha sido asignado al grupo de seguridad Setup Administrator en Workday. La llamada de prueba de conexión del conector se rechaza si la ISU carece de esta membresía de grupo de seguridad.
- El campo Workday Host contiene un valor incorrecto. Un host incorrecto causa que la conexión falle antes de que se intente la autenticación.
-
Resolución:
- Verifica que el valor de Workday Host en la configuración de conexión sea correcto. El host debe ser la URL base de tu tenant de Workday (por ejemplo,
https://wd5-impl-services1.workday.com/). Puedes confirmar el valor correcto desde la página View API Client de Workday. - En la instancia de Workday, abre la tarea Assign Users to User-based Security Group, selecciona Setup Administrator y confirma que la ISU aparece listada en System Users. Si no es así, agrega la ISU. Para ver los pasos completos, consulta Requisitos previos.
- Confirma que la tarea Configure Web Service Security también se haya completado para la ISU, como se describe en la página Requisitos previos.
- Vuelve a probar la conexión.
- Verifica que el valor de Workday Host en la configuración de conexión sea correcto. El host debe ser la URL base de tu tenant de Workday (por ejemplo,
Chunking requiere un conector nativo como origen
- Síntoma: Una operación con segmentación habilitada envía todos los registros al destino en un solo lote en lugar de respetar el tamaño de segmento configurado. Los errores del destino indican que se superó el límite de lotes (por ejemplo, Salesforce devuelve
EXCEEDED_ID_LIMIT: record limit reached. cannot submit more than 200 records into this call). - Posible causa: La segmentación se respeta solo cuando el origen es un conector nativo. Las operaciones que utilizan orígenes nativos como HTTP, Database, Variable y Local Storage respetan la segmentación normalmente.
- Solución:
- Si la segmentación no es necesaria, desactívala en las opciones de operación.
- Si la segmentación es necesaria, divide la operación en dos:
- En la primera operación, lee del origen original y escribe en una actividad Write de Variable.
- En la segunda operación, lee de una actividad Read de Variable y escribe en el destino original con segmentación habilitada. Dado que el conector Variable es nativo, la segmentación funciona correctamente en esta operación. Para los pasos de configuración de segmentación, consulta Configurar segmentación de operación.
Agente desconectado o inaccesible
- Síntoma: La pestaña Privado de la página Agentes de la Consola de Administración muestra el agente como Desconocido o Detenido, o Studio muestra un error
Agent Not Running or Unreachable. -
Posibles causas:
- Los servicios de Jitterbit no se están ejecutando.
- Los servicios se están ejecutando pero el host del agente no puede alcanzar la nube de Harmony.
- Un proxy corporativo está impidiendo que el agente se conecte.
-
Resolución:
-
Si los servicios de Jitterbit no se están ejecutando, inícialos:
- Windows: Consulta Iniciar un agente Windows.
- Linux: Consulta Iniciar un agente Linux.
Si el servicio no se inicia, verifica lo siguiente para buscar mensajes de error:
- Windows:
C:\Program Files (x86)\Jitterbit Agent\logy el registro de Visor de eventos de Aplicación de Windows. - Linux:
/opt/jitterbit/log.
La cuenta que ejecuta los servicios de Jitterbit requiere derechos de administrador local en Windows y acceso completo al directorio de instalación de Jitterbit.
-
Si los servicios se están ejecutando pero no pueden alcanzar la nube de Harmony, verifica lo siguiente:
- La conectividad a Internet desde el host del agente funciona.
- El registro del agente (
jitterbit-agent.log) no contiene mensajes de error sobre conectividad en la nube. - El agente puede alcanzar el portal de Harmony en el puerto 443.
-
Si el agente se conecta a través de un proxy corporativo, verifica que el proxy esté configurado correctamente para el agente, incluyendo el dominio NTLM si el proxy utiliza autenticación NTLM. Consulta Servidor proxy para agentes privados de Jitterbit. El registro de denegación del servidor proxy es útil para diagnosticar qué está bloqueando el proxy.
-
Si los servicios del agente están en buen estado en el host (
jitterbit statusmuestra todos los servicios en ejecución) pero el agente cambia repetidamente a Desconocido, o alterna entre En ejecución, Desconocido y Detenido, es probable que la conexión o el proceso del agente se interrumpa entre latidos. Verifica las siguientes posibles causas:- Un dispositivo de red (firewall, puerta de enlace NAT o tiempo de inactividad de VM en la nube) puede estar cerrando la conexión saliente del agente entre latidos. Intenta reducir el intervalo de latido del agente (
agent.heart.beat.interval). Para agentes alojados en la nube, consulta Azure VM: Conexiones perdidas y errores de WebSocket/I/O, que también se aplica a otras redes restringidas como AWS. - El agente puede haber fallado bajo presión de memoria. Busca archivos de volcado de crash
OutOfMemoryErrorohs_err_pid. Consulta Espacio de heap de Java:OutOfMemoryError. - Si los agentes se migraron recientemente a un nuevo sistema operativo mientras se reutilizaba un grupo de agentes que anteriormente alojaba agentes en el SO anterior, el grupo reutilizado puede ser la causa. Consulta El agente muestra Desconocido o Detenido después de reutilizar un grupo de agentes en sistemas operativos.
- Un dispositivo de red (firewall, puerta de enlace NAT o tiempo de inactividad de VM en la nube) puede estar cerrando la conexión saliente del agente entre latidos. Intenta reducir el intervalo de latido del agente (
-
El agente muestra diferentes versiones o direcciones IP
- Síntoma: La pestaña Privado de la página Agentes de la Consola de Administración muestra diferentes versiones o direcciones IP para un agente privado, o los valores cambian de un lado a otro después de reiniciar los servicios.
- Causa posible: Es posible que la máquina host del agente se haya duplicado a nivel de infraestructura (por ejemplo, un clon de VM, imagen de disco, plantilla de máquina o snapshot creado después de que se instaló y registró el agente). El host duplicado lleva las mismas
credentials.txtdel agente, por lo que ambos hosts se autentican en Harmony como el mismo agente y se ejecutan en paralelo, colisionando. Dos agentes no pueden ejecutarse simultáneamente bajo las mismas credenciales. - Resolución:
- Confirma que se está ejecutando un duplicado. Detén el agente en el host que deseas mantener, espera 10 minutos y luego actualiza la pestaña Privado de la página Agentes de la Consola de Administración. Si el agente cambia de Detenido a En ejecución, otro host se está reportando bajo la misma identidad.
- Identifica y apaga el host duplicado.
- Si no se puede apagar el duplicado, desinstala el agente, crea un nuevo agente con un nombre diferente y reinstálalo en el host que deseas mantener.
- Verifica que el nuevo agente aparezca como En ejecución en la pestaña Privado de la página Agentes de la Consola de Administración.
- Elimina la entrada del agente anterior usando Acciones > Eliminar.
Falla de sincronización del agente: Los cambios del proyecto no se aplican
- Síntoma: Después de implementar cambios en Studio, el agente continúa ejecutando la versión anterior del proyecto, o una operación falla porque no se encuentra una conexión recién agregada en el agente.
-
Causas posibles:
- La implementación utilizó Implementación Configurable, que implementa solo los flujos de trabajo y operaciones seleccionados. Cualquier parte del proyecto fuera de esa selección permanece en su versión implementada anteriormente en el agente.
- El componente no se utiliza en el flujo lógico de un flujo de trabajo implementado. Los componentes no utilizados no se implementan, por lo que una conexión que ninguna operación implementada referencia no se envía al agente.
- Ocurrió un tiempo de espera de red o un error de autorización durante la sincronización.
- El espacio en disco bajo en el host del agente impidió que se escribieran los archivos del proyecto sincronizados.
-
Resolución:
- Vuelve a implementar el proyecto completo: en Studio, utiliza Implementar, que implementa todas las operaciones del proyecto, en lugar de una Implementación Configurable de solo flujos de trabajo u operaciones seleccionados.
- Reinicia los servicios del agente para forzar una sincronización nueva de todos los proyectos implementados.
- Revisa los registros del agente para tiempos de espera de red relacionados con la sincronización o errores de autorización.
- Verifica el espacio en disco disponible en el host del agente. Un disco lleno o casi lleno puede impedir que el agente escriba archivos de proyecto sincronizados. Consulta Espacio en disco y acumulación de registros.
Error 1722 en la instalación de Windows
-
Síntoma: La instalación del agente privado de Windows falla a mitad del proceso, con uno de estos errores del Instalador de Windows:
Error 1722. There is a problem with this Windows Installer package. A program run as part of the setup did not finish as expected. Contact your support personnel or package vendor. ...Error 1720. There is a problem with this Windows Installer package. A script required for this install to complete could not be run.Ambos errores significan que un paso en el instalador (una acción personalizada, nombrada en el mensaje de Error 1722) no se completó. La mayoría de las veces, el paso que falla es la configuración de PostgreSQL incluida en el instalador, en cuyo caso el registro del instalador también puede mostrar un error de script
KoGetDbServiceoKoInstallPostgreSQLNew, o[Microsoft][ODBC Driver Manager] Data source name not found and no default driver specified, y es posible que la base de datos PostgreSQL incluida y el servicio de Windowsjitterbitpostgresno se creen completamente. El mensaje puede nombrar una acción diferente, comoInstallVerboseLogShipper. -
Causas posibles:
- Una redistribución de Microsoft Visual C++ faltante o conflictiva (PostgreSQL incluido la requiere).
- Caracteres prohibidos en la contraseña de PostgreSQL.
- En una reinstalación, componentes de PostgreSQL restantes de un agente anterior. El desinstalador del agente no elimina PostgreSQL, el usuario de Windows
jitterbitpostgreso sus entradas del registro por diseño, y estos restos pueden impedir que la nueva configuración de PostgreSQL se complete (por ejemplo, la cuenta de serviciojitterbitpostgresno se puede recrear). - En una reinstalación o actualización, componentes restantes del envío de registros detallado de un agente anterior. Al igual que con PostgreSQL, una desinstalación estándar no elimina el servicio de envío de registros detallado ni sus archivos, y estos restos pueden causar que la acción
InstallVerboseLogShipperdel instalador falle. - En una actualización desde una instalación avanzada anterior donde PostgreSQL estaba configurado para ejecutarse bajo una cuenta de servicio de Windows distinta de
jitterbitpostgres(por ejemplo,NT AUTHORITY\NetworkService), la actualización podría fallar con Error 1720 en versiones del agente anteriores a la 12.10.
-
Resolución:
- Instala el Redistribuible de Microsoft Visual C++ de 64 bits para Visual Studio usando
vc_redist.x64.exe(compatible con Visual Studio 2015, 2017 y 2019) antes de instalar el agente y mantenlo instalado, ya que eliminarlo durante una limpieza también rompe la instalación. -
Si la contraseña de PostgreSQL contiene caracteres prohibidos, cambia la contraseña a una válida antes de reintentar la instalación.
Nota
En agentes privados 12.8 y posteriores, el instalador valida la contraseña de la cuenta de servicio de PostgreSQL (
jitterbitpostgres) contra las restricciones de caracteres en el momento de la entrada y te solicita que la corrijas antes de que se instale PostgreSQL. -
Si estás reinstalando después de un agente anterior, elimina completamente el PostgreSQL restante primero: sigue Desinstalar un agente privado de Windows, luego confirma que el usuario de Windows
jitterbitpostgres, el programa PostgreSQL, los directorios de datos y las claves del registro de PostgreSQL se hayan eliminado. - Si el mensaje de Error 1722 menciona la acción
InstallVerboseLogShipper, elimina el servicio de envío de registro detallado restante y sus archivos del agente anterior, luego desinstala el agente nuevamente y reinstala. -
Si la instalación anterior es una instalación avanzada con PostgreSQL ejecutándose bajo una cuenta de servicio distinta a
jitterbitpostgres, actualiza a la versión 12.10 del agente o posterior, lo que resuelve esto. En una versión anterior del agente, reconfigura el servicio PostgreSQL existente para ejecutarse bajo la cuenta de servicio de Windowsjitterbitpostgresantes de actualizar.Si la instalación sigue fallando después de una limpieza exhaustiva, contacta al soporte de Jitterbit.
- Instala el Redistribuible de Microsoft Visual C++ de 64 bits para Visual Studio usando
Servicio PostgreSQL eliminado después de una actualización fallida en Windows
-
Síntoma: Después de una actualización fallida del agente privado en Windows, el servicio PostgreSQL (
postgresql-x64-<VERSION>) ya no aparece en Servicios de Windows y los servicios del agente Jitterbit no se inician debido a una dependencia faltante. -
Causa: Esto ocurre con versiones del agente privado anteriores a 11.59 / 12.3 cuando se ingresa una contraseña incorrecta durante la actualización y el instalador no revierte correctamente. Este problema se resuelve en el agente privado 11.59 / 12.3 y posteriores, donde una contraseña incorrecta bloquea la actualización en el mismo diálogo y permite reintentar o cancelar sin afectar la instalación existente.
-
Resolución:
- Abre un símbolo del sistema como administrador.
-
Vuelve a registrar el servicio PostgreSQL:
"C:\Program Files\PostgreSQL\<VERSION>\bin\pg_ctl.exe" register -N "postgresql-x64-<VERSION>" -D "C:\Program Files\PostgreSQL\<VERSION>\data"Reemplaza
<VERSION>con tu número de versión de PostgreSQL. Para encontrarlo, consulta Versión de PostgreSQL incluida con el agente privado. -
Inicia los servicios PostgreSQL y PgBouncer:
net start postgresql-x64-<VERSION> net start JitterbitPgbouncer -
Inicia todos los servicios del agente Jitterbit:
"C:\Program Files\Jitterbit Agent\StartServices.bat" -
Una vez que el agente esté en ejecución, restablece las contraseñas del administrador de PostgreSQL y de la cuenta de servicio antes de reintentar la actualización.
Los servicios del agente no inician después de reiniciar Windows después de una actualización
-
Síntoma: Una actualización del agente privado de Windows de un agente 11.x a un agente 12.x anterior a 12.10 se completa correctamente, pero los servicios del Agente Jitterbit no se inician la próxima vez que se reinicia el sistema host.
-
Posible causa: La actualización deja el servicio anterior de PostgreSQL en Windows (
postgresql-x64-<VERSION>, donde<VERSION>es la versión instalada por el agente anterior) con su tipo de inicio aún configurado como Automático. Al reiniciar, este servicio más antiguo se inicia antes que el servicio PostgreSQL instalado por la actualización y ocupa el mismo puerto, lo que impide que el nuevo servicio PostgreSQL y, por lo tanto, el agente, se inicien. -
Resolución:
- Actualizar a la versión 12.10 del agente o posterior, que elimina el servicio PostgreSQL anterior durante la actualización.
- En una versión anterior del agente, después de actualizar, abrir Servicios de Windows, identificar el servicio
postgresql-x64-<VERSION>más antiguo (el que es anterior a la actualización) y establecer su tipo de inicio en Manual o Deshabilitado, o desinstalarlo, antes de reiniciar el sistema host. Para verificar qué versión está actualmente incluida con el agente, ejecutar el comando en Misma versión que la incluida.
TFA impide la instalación del agente Windows de 64 bits
- Síntoma: La instalación de un agente privado de Windows de 64 bits falla cuando la autenticación de dos factores (TFA) está habilitada en la organización.
- Resolución: Deshabilitar temporalmente la TFA, instalar el agente y luego volver a habilitar la TFA. La configuración Requerir autenticación de dos factores (TFA) se encuentra en la pestaña Gestión de usuarios de las políticas de una organización, a la que se accede desde la página Organizaciones de la Consola de administración.
Instalación en Linux sin privilegios falla
- Síntoma: El instalador Linux Redhat Non-Root (x64) falla.
-
Resolución: Verificar lo siguiente:
- El usuario sin privilegios de root tiene privilegios de
sudo. Un administrador del sistema debe agregar el usuario al grupowheel. Para verificar la pertenencia actual al grupo, ejecutargroups. -
Cuando se inicia sesión como usuario
jitterbit, la variable de entornoJITTERBIT_HOMEestá configurada en la ubicación de instalación:echo $JITTERBIT_HOMEEl resultado debe ser
/opt/jitterbit. Esto se establece mediante$HOME/.bashrc.d/jitterbitcuando se siguen las instrucciones de instalación. Para configurarlo manualmente, ejecutar:. /opt/jitterbit/scripts/set.env -
Si el instalador falla con un error
OPENSSL_3.4.0, se trata de un problema conocido en RHEL 9.7 y posterior. Consultar RHEL 9.7 y posterior: la instalación del agente privado sin privilegios de root muestra un error de OpenSSL en los problemas conocidos del agente privado para obtener una solución alternativa.
- El usuario sin privilegios de root tiene privilegios de
Controlador JDBC: "No suitable driver found"
- Síntoma: Una conexión de base de datos falla porque el controlador JDBC requerido no está instalado en el agente, con un error como
No suitable driver found for jdbc:<subprotocol>://.... - Causa: Jitterbit no incluye todos los controladores JDBC. El controlador requerido debe instalarse manualmente.
- Resolución: Instalar el controlador requerido manualmente: registrarlo en
JdbcDrivers.confy copiar el archivo.jardel controlador aJITTERBIT_HOME/tomcat/drivers/lib/, luego reiniciar el agente. Para ver los pasos completos, consultar Instalar un controlador JDBC.
Espacio de memoria Java: OutOfMemoryError
-
Síntoma: Las operaciones que procesan archivos grandes o ejecutan muchas operaciones simultáneamente fallan con:
java.lang.OutOfMemoryError: Java heap space -
Causa: El tamaño máximo de heap de Java (
-Xmx) del agente privado es demasiado pequeño para la carga de trabajo (archivos grandes o alta concurrencia de trabajos). - Resolución:
- Aumentar el heap máximo de Java del agente privado. Consulta Memoria de heap de Tomcat para saber cómo cambiar el valor
-Xmx(por ejemplo, de-Xmx1024ma-Xmx4096m). - Reinicia los servicios del agente después de realizar el cambio.
- Para operaciones que procesan archivos grandes, configura fragmentación para reducir el uso de memoria por trabajo. Studio aplica transformaciones de streaming automáticamente cuando califican.
- Si la observabilidad nativa está habilitada, utiliza el gráfico System Resource Capability en la pestaña Métricas de la página Agentes de la Consola de Administración para monitorear el uso de memoria a lo largo del tiempo y ajustar el heap según la carga de trabajo.
- Aumentar el heap máximo de Java del agente privado. Consulta Memoria de heap de Tomcat para saber cómo cambiar el valor
Espacio en disco y acumulación de registros
- Síntoma: El host del agente privado se queda sin espacio en disco, lo que puede causar que PostgreSQL se apague u operaciones fallen con errores de permisos. Los archivos de registro y temporales se acumulan en los directorios del agente, especialmente en agentes que procesan altos volúmenes.
- Resolución:
- Verifica el espacio en disco disponible en el host del agente.
- Identifica archivos grandes. Los registros del agente y archivos temporales se encuentran en
JITTERBIT_HOME/log,JITTERBIT_HOME/tomcat/logs(catalina.out) yJITTERBIT_HOME/DataInterchange/Temp. Consulta Archivos de registro para la lista completa. Un archivo de registro individual puede crecer a varios gigabytes cuando un componente registra excesivamente (por ejemplo, un conector detallado inundandocatalina.out) o cuando un error se repite (por ejemplo, una conexión de base de datos fallida repitiéndose enProcessEngine.log). Borra archivos de tamaño excesivo si el espacio es crítico; borrar el archivo y reiniciar el agente también puede detener el error subyacente. - Confirma que el servicio de limpieza se está ejecutando y se respeta su retención. En la sección
[FileCleanup]dejitterbit.conf, verifica queAutoStartseatruey revisaFrequencyInHours. La retención por directorio se establece enCleanupRules.xmlusandoNumDaysoNumOfHours. - Si el servicio de limpieza no puede eliminar archivos de registro activos (Tomcat mantiene sus registros de
stdoutystderrabiertos en Windows), aumentaFileAgepara ese directorio enCleanupRules.xmla al menos un día para que la limpieza no afecte archivos que aún se están escribiendo. - Si archivos
.dmpde volcado de fallos grandes están consumiendo el disco, consulta Los archivos de mini-dump de JVM llenan el disco del agente.
Fallos de conexión TranDb
-
Síntoma: Las operaciones fallan con errores que hacen referencia a la base de datos PostgreSQL interna del agente privado, o los servicios internos del agente no se inician porque se ha alcanzado su límite de conexión. Los fallos repetidos también pueden inundar
ProcessEngine.log, haciéndola crecer a varios GB:Failed to connect to back-end database 'TranDb'FATAL: query_wait_timeoutFATAL: remaining connection slots are reserved for non-replication superuser connections -
Causas posibles:
- El límite
max_connectionsde PostgreSQL interno, o el límitemax_db_connectionsde PgBouncer, es demasiado bajo para la carga de trabajo del agente. - Las operaciones se están acumulando bajo carga pesada o una ralentización de red o punto final, manteniendo conexiones de base de datos hasta que se agota el grupo de PgBouncer (
query_wait_timeout). - En un agente de Windows, IP Helper está interfiriendo con las conexiones de base de datos locales del agente.
- El límite
-
Resolución:
- Las versiones recientes del agente incluyen límites de conexión más altos para PostgreSQL y PgBouncer de forma predeterminada, así que primero confirma que el agente esté en una versión actual. Si un agente actual sigue agotando su límite de conexión, contacta con soporte de Jitterbit para aumentarlo bajo orientación de soporte. Las instancias agrupadas de PostgreSQL y PgBouncer deben modificarse solo bajo orientación de soporte.
- Si los límites ya son adecuados, investiga qué está manteniendo las conexiones abiertas: revisa la carga del host del agente y cualquier lentitud de red o punto final ascendente que esté ralentizando las operaciones.
- En un agente Windows, desactiva IP Helper. Consulta Problema de IPv6 en Windows.
PostgreSQL: Apagado rápido administrativo
-
Síntoma: Todas las operaciones fallan porque la base de datos del agente no está disponible (las operaciones pueden estancarse en estado Pendiente), y el registro de PostgreSQL registra un apagado rápido:
received fast shutdown requestLas operaciones de conexión también pueden reportar
FATAL: terminating connection due to administrator command. -
Posibles causas:
- Una acción externa o del sistema detuvo o reinició PostgreSQL: un reinicio del SO, una actualización de Windows o tarea programada, o una herramienta de monitoreo o copia de seguridad que reinicia servicios.
- El host del agente se quedó sin CPU o memoria, causando que Tomcat se bloqueara y llevara PostgreSQL con él.
-
Resolución:
- Reinicia los servicios de PostgreSQL y del agente Jitterbit (o reinicia el host del agente) para recuperarte. Si las operaciones permanecen estancadas en estado Pendiente o En ejecución después de que PostgreSQL esté de vuelta, contacta con soporte de Jitterbit, ya que el grupo de conexiones de la base de datos del agente puede no haberse recuperado.
- Identifica qué detuvo PostgreSQL: revisa el registro de eventos del SO (en Windows, Visor de eventos) alrededor del momento del fallo para reinicios, actualizaciones, tareas programadas, bloqueos de servicios, o herramientas de copia de seguridad y monitoreo que reinician servicios. Prevén o reprograma lo que lo está deteniendo, y establece que el servicio de PostgreSQL se reinicie automáticamente en caso de fallo.
- Verifica la CPU y memoria del host del agente. Si los servicios de Jitterbit se están bloqueando bajo carga, consulta Bucle de reinicio del servicio del agente y Espacio de pila de Java:
OutOfMemoryError.
Fallo de protocolo de enlace de certificado (TLS)
-
Síntoma: Las operaciones que se conectan a puntos finales seguros fallan durante el protocolo de enlace TLS, con errores como:
error:0A000152:SSL routines::unsafe legacy renegotiation disabledSSLHandshakeException: Received fatal alert: protocol_versionPKIX path building failed: unable to find valid certification path to requested target -
Posibles causas:
- El punto final utiliza renegociación heredada de TLS, que el agente bloquea de forma predeterminada.
- El agente y el punto final no pueden negociar una versión o cifrado TLS común. Los agentes de la versión 11.x y 12.x incluyen diferentes bibliotecas de seguridad, por lo que un punto final que no se conecta en un agente 11.x puede conectarse en un agente 12.x.
- El certificado del punto final (o uno de sus intermediarios) no es de confianza para el agente porque su CA emisora no está en el almacén de confianza
cacertsdel JRE del agente.
-
Resolución: Desde el host del agente, ejecuta lo siguiente para confirmar qué versión de TLS negocia el punto final y si el protocolo de enlace se realiza correctamente a nivel de red:
openssl s_client -connect hostname:portLuego aplica la solución que coincida con el error:
- Si el error es
unsafe legacy renegotiation disabled, estableceAllowUnsafeLegacyRenegotiation=trueen la sección[Settings]dejitterbit.confy reinicia el agente. Esta configuración requiere la versión 11.39 del agente o posterior. - Si el error es
PKIX path building failed: unable to find valid certification path to requested target, el certificado del punto final (o uno de sus intermediarios) no está en el almacén de confianzacacertsdel JRE del agente. Utilizakeytool -importen elcacertsdel JRE del agente (contraseña predeterminadachangeit) para importar los certificados faltantes y luego reinicia los servicios del agente. Para una base de datos SQL Server a la que se accede a través de una conexión de Base de datos, también puedes resolver esto en la configuración del controlador de la conexión en lugar del almacén de confianza, tanto en agentes en la nube como privados. Consulta SQL Server: La conexión falla con un error de ruta de certificado PKIX. - Si persiste un fallo de negociación o protocolo de enlace TLS, especialmente en un agente 11.x, actualiza a un agente 12.x actual, que incluye bibliotecas de seguridad actualizadas y un almacén de confianza de certificados actualizado.
- Si el error es
FTP: Tiempo de espera de conexión de datos agotado
- Síntoma: El inicio de sesión FTP es exitoso pero la lista de archivos o la transferencia de archivos se cuelga y agota el tiempo de espera.
-
Posibles causas:
- El modo de conexión FTP (activo vs. pasivo) es incompatible con la configuración de red o firewall.
- El rango de puertos pasivos definido en el servidor FTP no está abierto en el firewall corporativo.
-
Resolución:
- En la configuración de conexión de FTP, activa o desactiva la casilla Modo Pasivo. El modo pasivo generalmente se prefiere para agentes detrás de un firewall.
- Confirma con tu equipo de red que el rango de puertos pasivos configurado en el servidor FTP está abierto en el firewall entre el agente y el servidor FTP.
- Para capturar registros detallados a nivel de conexión, habilita el registro de depuración de curl configurando
CurlDebugDiren la sección[Settings]dejitterbit.conf. Consulta Registros de Curl.
Problema de IPv6 en Windows
- Síntoma: Algunos agentes experimentan problemas de conectividad cuando IPv6 está habilitado en el host de Windows. Esto puede manifestarse, por ejemplo, como operaciones atascadas en estado Pendiente con un
ProcessEngine.logen rápido crecimiento, cuando el servicio IP Helper se bloquea y el agente pierde su conexión a la base de datos interna. -
Resolución: Deshabilitar tanto IPv6 como IP Helper en el host de Windows.
Deshabilitar IPv6 de la siguiente manera:
- Abrir Panel de control > Red e Internet > Conexiones de red.
- Abrir las Propiedades de la conexión de red.
-
Desmarcar la casilla de Protocolo de Internet versión 6 (TCP/IPv6):
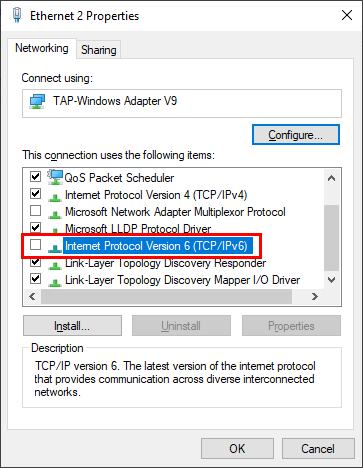
Deshabilitar IP Helper de la siguiente manera:
- Abrir Servicios.
- Localizar IP Helper, hacer clic derecho y seleccionar Propiedades.
- Hacer clic en Detener, luego establecer Tipo de inicio en Deshabilitado:
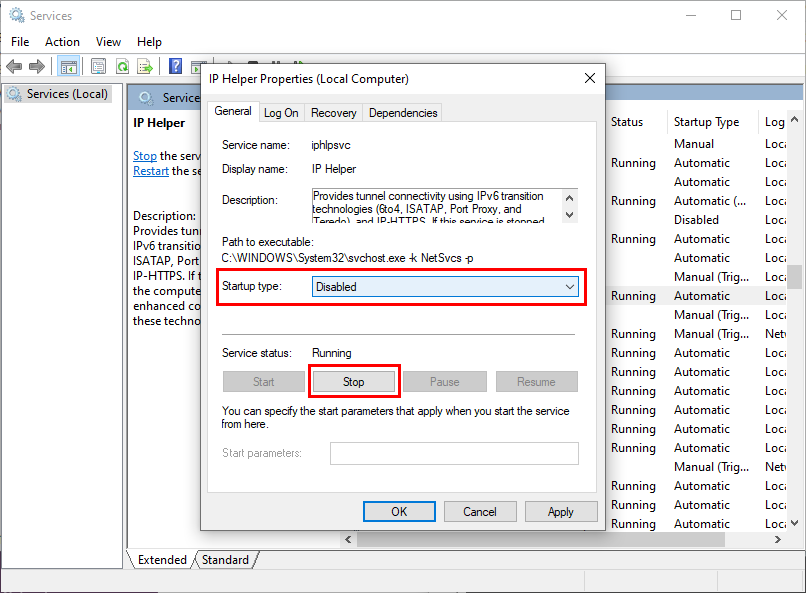
Máquina virtual de Azure: Pérdida de conexiones y errores de WebSocket/E/S
- Síntoma: Los agentes privados instalados en máquinas virtuales de Azure experimentan interrupciones de conexión o errores de WebSocket/E/S.
- Resolución: Reduce el intervalo de latido del agente y aumenta los tiempos de espera de inactividad y flujo de la máquina virtual de Azure. Consulta Máquina virtual de Azure: Pérdida de conexiones y errores de WebSocket/E/S en la guía de solución de problemas del agente para ver todos los pasos.
Apache: Sin ConfigArgs instalado
-
Síntoma: El agente devuelve:
No Installed ConfigArgs for the Service "Jitterbit Apache Server" -
Causa: La cuenta que ejecuta el servidor Apache de Jitterbit no tiene acceso completo al directorio de instalación de Jitterbit.
- Resolución: Otorga a la cuenta de servicio acceso completo a la carpeta de instalación de Jitterbit y reinicia los servicios.
Apache/Tomcat: APPARENT DEADLOCK
-
Síntoma: Bajo carga sostenida, el agente deja de procesar operaciones y puede mostrarse como detenido en la Consola de Administración. El registro del agente contiene:
ThreadPoolAsynchronousRunner: APPARENT DEADLOCKEl registro también puede mostrar
An existing connection was forcibly closed by the remote hostpara la base de datos PostgreSQL del agente. Reiniciar el agente restaura la operación normal temporalmente, después de lo cual el bloqueo se repite bajo carga. -
Posibles causas:
- El grupo de conexiones de base de datos del agente se bloquea cuando la base de datos PostgreSQL interna se queda sin conexiones disponibles bajo carga pesada.
- El grupo de conexiones de base de datos Java del agente (mostrado como
c3p0en el registro) no puede recuperarse después de que se pierda brevemente una conexión de base de datos, por ejemplo durante una interrupción de red transitoria, aunque PostgreSQL en sí permanece saludable y receptivo con tiempos de espera predeterminados. - Los procesos Jitterbit obsoletos están reteniendo hilos y conexiones de base de datos. Esto puede ocurrir cuando se actualiza un agente mientras las operaciones aún se están ejecutando, o cuando los servicios se detienen sin que todos los procesos Jitterbit terminen correctamente.
- El host del agente está sobrecargado por actividad máxima, o su CPU está siendo limitada. Por ejemplo, una instancia en la nube ampliable (como un tipo AWS
t3) limita su CPU una vez que se agotan sus créditos de ráfaga, lo que puede privar de recursos a PostgreSQL interno bajo carga.
-
Resolución:
- Detén todos los servicios de Jitterbit, finaliza cualquier proceso de Jitterbit que aún esté en ejecución y luego reinicia los servicios para limpiar el bloqueo.
- Si el bloqueo está en el grupo de conexiones Java (
c3p0) y PostgreSQL en sí está en buen estado, cambia el agente a su grupo de conexiones C++ interno configurandoUseInternalPooling=trueen la sección[DbInfo]dejitterbit.confy luego reinicia el agente. El grupo interno se recupera de conexiones perdidas u obsoletas de manera más confiable. En instalaciones nuevas de agentes privados de Windows versión 12.5 y posteriores, esto ya está habilitado de forma predeterminada. - Reduce la carga en el agente: programa operaciones para evitar picos de actividad máxima, agrega agentes al grupo de agentes para equilibrio de carga y confirma que el host cumple con los requisitos del sistema. Para hosts en la nube, utiliza un tipo de instancia con rendimiento de CPU sostenido (no ampliable).
- Antes de actualizar un agente, detén el drenaje y permite que terminen las operaciones en ejecución, de modo que ningún proceso quede reteniendo conexiones de base de datos durante la actualización. En entornos ocupados, permite tiempo adicional para que se complete el drenaje.
Apache falla inesperadamente bajo carga concurrente
- Síntoma: Bajo carga concurrente, el proceso Apache del agente se bloquea y se reinicia inesperadamente, y el agente puede mostrarse brevemente como detenido o reiniciándose en la Consola de Administración. Las operaciones que se estaban ejecutando en ese momento pueden fallar o quedar en un estado incompleto.
- Posibles causas:
- Un script utiliza llamadas anidadas de
RunOperationpara ejecutar una operación secundaria de forma sincrónica (la predeterminada) desde una operación principal, y ambas operaciones leen o escriben la misma variable global al mismo tiempo. - Una transformación está configurada con fragmentación y múltiples subprocesos, y un subproceso termina de ejecutarse antes que otro subproceso que comenzó al mismo tiempo.
- Múltiples operaciones con generación de datos de entrada y salida de componentes habilitada se ejecutan al mismo tiempo.
- Un script utiliza llamadas anidadas de
- Resolución: Actualiza el agente privado a la versión 12.10 o posterior, que resuelve estos problemas. No existe solución alternativa en versiones anteriores.
El servicio de limpieza no puede eliminar archivos de registro bloqueados en Windows
-
Síntoma: Los archivos de registro en un agente privado de Windows crecen indefinidamente y el servicio de limpieza no los elimina. El registro del servicio de limpieza reporta un error como:
Failed to remove file, retries (10) exhausted: '...\jitterbit tomcat server-stdout.<date>.log'. Reason: The process cannot access the file because it is being used by another process. -
Posibles causas:
- Un proceso del agente mantiene el archivo abierto. En Windows, el servicio de limpieza no puede eliminar un archivo que está en uso, y Tomcat mantiene abiertos sus archivos de registro
stdoutystderrmientras se ejecuta. - Software de terceros (antivirus o un agente de monitoreo) mantiene un bloqueo en los archivos del directorio de registro del agente.
- Un proceso del agente mantiene el archivo abierto. En Windows, el servicio de limpieza no puede eliminar un archivo que está en uso, y Tomcat mantiene abiertos sus archivos de registro
-
Resolución:
- Edita
CleanupRules.xmlpara acortar la retención (FileAge) de los directorios de registro afectados, de modo que los archivos se eliminen rápidamente una vez que dejen de estar en uso. Reinicia el agente después de editar el archivo. - Excluye los registros de Tomcat
stdoutystderrcontinuamente escritos de las reglas de limpieza, de modo que el servicio no reintente repetidamente archivos que permanecen bloqueados mientras se ejecuta el agente. - Si hay software de terceros involucrado, agrega los directorios de instalación y registro de Jitterbit a su lista de exclusión.
- Si los registros siguen creciendo incluso con reglas de limpieza válidas, contacta al soporte de Jitterbit.
- Edita
El agente no se reinicia con errores de autenticación después de la cancelación del registro
-
Síntoma: Un agente configurado con
deregisterAgentOnDrainstop=true(o la variable de entornoAUTO_REGISTER_DEREGISTER_ON_DRAINSTOP) falla al reiniciarse después de detenerse. Esto aplica a agentes Docker que utilizan un volumen persistente para/opt/jitterbit/Resources, y a agentes Linux no containerizados. -
Causa: Cuando el agente se detiene con
deregisterAgentOnDrainstop=true, se desregistra de Harmony pero el archivocredentials.txtahora inválido permanece en el disco. Al reiniciar, el agente intenta utilizar las credenciales obsoletas y falla en la autenticación.Nota
A partir de la versión 12.4 del agente Docker, reiniciar el contenedor cuando
deregisterAgentOnDrainstop=trueestá habilitado desregistra automáticamente el agente existente y registra uno nuevo. Los pasos a continuación aplican a agentes Docker en versiones anteriores, y a agentes Linux en cualquier versión. -
Resolución: Elimina el archivo
credentials.txtobsoleto y luego reinicia el agente para activar un nuevo registro.En un agente Linux no containerizado, elimina el archivo directamente:
rm /opt/jitterbit/Resources/credentials.txtEn un agente Docker, elimina el archivo del volumen montado:
docker run -i --rm -v VOLUME_NAME:/opt/jitterbit/Resources jitterbit/agent rm -i /opt/jitterbit/Resources/credentials.txtReemplaza
VOLUME_NAMEcon el nombre del volumen Docker bajo el cual está montado/opt/jitterbit/Resources.
El cambio de registro en la nube requiere reinicio del agente privado
- Síntoma: Después de activar o desactivar el Registro en la nube para un grupo de agentes privados, el comportamiento del registro en la página Runtime de la Consola de administración no cambia.
- Resolución: Después de cambiar la configuración de Registro en la nube en la página Agentes, reinicia todos los agentes privados del grupo para que el cambio surta efecto.
No se permite agregar un segundo agente a un grupo de agentes estándar
- Síntoma: Se produce un error al intentar agregar un segundo agente privado a un grupo existente, o el grupo muestra una advertencia después de la adición.
- Causa posible: Un grupo de agentes Estándar permite un máximo de un agente. Ejecutar más de un agente en un grupo requiere la clase Alta disponibilidad, que requiere una licencia de Agrupación de agentes para HA.
- Resolución:
- En la página Agentes, edita el grupo de agentes y cambia la Clase del grupo de agentes a Alta disponibilidad.
- Confirma que tu organización tiene una licencia de Agrupación de agentes para HA. Los detalles de la licencia están disponibles en la página Panel de la Consola de administración.
- Si necesitas agregar una licencia, ponte en contacto con tu representante de Jitterbit.
Agregar un agente privado falla con un error de límite máximo de agentes
-
Síntoma: En el cajón Detalles del grupo de agentes de un grupo de agentes, el icono Crear está disponible, pero guardar el nuevo agente privado falla con un error de máximo de agentes. Dos límites separados producen este fallo, cada uno con su propio texto de error.
-
Causas posibles:
- El grupo de agentes está lleno. El grupo ha alcanzado su número máximo de agentes, que es 10 de forma predeterminada:
Ha alcanzado el límite máximo de agentes permitidos para su organización. Póngase en contacto con su representante de Jitterbit para aumentar el límite.
Este límite aplica a grupos con la clase de grupo de agentes High Availability. Un grupo Standard permite solo un agente, como se describe en No se permite agregar un segundo agente a un grupo de agentes Standard.
-
Se ha alcanzado el límite de agentes privados de la organización. Se han agregado todos los agentes privados permitidos por el plan de suscripción de su organización:
HttpErrorResponse: You've reached the maximum number of agent(s) configured for your Jitterbit organization. Please directly contact the Jitterbit Customer Success Manager assigned to you or send an email to success@jitterbit.com to review your needs and configure your organization appropriately.Este límite aplica independientemente del grupo de agentes al que agregue el agente, y un agente cuenta hacia él una vez que se agrega, incluso si nunca se registra.
-
Resolución:
- Para confirmar qué límite aplica, compare el recuento de agentes del grupo de agentes contra su máximo en la página Agentes, y los agentes privados agregados de su organización contra su total licenciado en la página Panel de control de la Consola de administración.
- Si el grupo de agentes está lleno, agregue el agente a un grupo de agentes diferente o elimine un agente que ya no esté en uso del grupo.
- Para aumentar cualquiera de los límites, póngase en contacto con su representante de Jitterbit o con el Administrador de éxito del cliente.
No se puede eliminar el agente privado
- Síntoma: Se produce un error al intentar eliminar un agente privado.
- Causa: Un agente solo se puede eliminar cuando su estado es uno de los siguientes: Starting, Stopped, Unregistered o Unknown. Los agentes en estado Running o Stopping no se pueden eliminar.
- Resolución:
- En la página Agentes, verifique el estado actual del agente.
- Detenga el agente y espere a que su estado cambie antes de reintentar la eliminación.
No se puede eliminar el grupo de agentes privados
- Síntoma: Se produce un error al intentar eliminar un grupo de agentes privados.
- Causa: No se puede eliminar un grupo de agentes privados mientras esté asociado a un entorno.
- Resolución:
- En la página Agentes, edite el grupo de agentes y elimine todas las asociaciones de entorno.
- Reintente la eliminación.
Inhabilitar actualización automática de conectores omitida por acciones del agente
- Síntoma: Los conectores se actualizan en agentes privados aunque Disable Auto Connector Update esté habilitado en las políticas de la organización.
- Causa: La política de organización Disable Auto Connector Update impide que los agentes privados actualicen automáticamente los conectores ya instalados a versiones más nuevas (por ejemplo, el botón Test de una conexión ya no descarga la última versión del conector). No mantiene los conectores en una versión fija en todas las situaciones. Los conectores se descargan o actualizan de todas formas, independientemente de la política, cuando ocurre cualquiera de lo siguiente:
- Se selecciona Action > Update connectors para el grupo de agentes en la página Agentes de la Consola de administración. Esta acción anula explícitamente la política.
- Se instala un agente privado por primera vez o se reinicia su base de datos PostgreSQL (incluyendo mediante una actualización que actualiza la base de datos PostgreSQL incluida, como actualizar de un agente 11.x a un agente 12.x). Entonces el agente no tiene un registro almacenado de versiones de conectores instaladas anteriormente, por lo que descarga los conectores actuales desde la nube.
- Se actualiza un agente privado de la versión 11.48 o anterior a la versión 11.49 o posterior, que incluye una actualización de conector requerida de una sola vez. Se le notifica durante la actualización que los conectores se actualizarán. Consulte las notas de actualización para Windows y Linux.
- Resolución: No se requiere ninguna acción. La política Disable Auto Connector Update evita las actualizaciones automáticas de conectores durante el funcionamiento normal pero no se aplica a las acciones y eventos anteriores.
El agente muestra Desconocido o Detenido después de reutilizar un grupo de agentes en sistemas operativos
- Síntoma: Después de migrar agentes privados a un sistema operativo diferente (por ejemplo, de Windows a Linux) mientras se reutiliza el mismo grupo de agentes, los agentes migrados muestran intermitentemente Desconocido o Detenido en la pestaña Privado de la página Agentes de la Consola de Administración, aunque
jitterbit statusmuestre que los servicios se están ejecutando y las operaciones funcionan normalmente. - Causa posible: Reutilizar un grupo de agentes del sistema operativo anterior puede dejar metadatos que interfieran con la generación de reportes de estado para los nuevos agentes. El efecto es típicamente cosmético: los servicios y operaciones continúan ejecutándose normalmente.
- Resolución: Crea un nuevo grupo de agentes limpio para los agentes migrados en lugar de reutilizar el grupo del sistema operativo anterior, luego registra los agentes allí.
Operaciones retrasadas o en cola después de implementar un proyecto
- Síntoma: Después de desplegar un proyecto en Studio, las operaciones activadas no se inician inmediatamente, o aparece un breve acumulamiento de operaciones en cola.
- Causa: El entorno se bloquea mientras el agente sincroniza el proyecto desplegado. No se puede ejecutar ninguna operación durante este período.
- Resolución:
- Para medir cuánto tiempo duran los bloqueos de sincronización, busca
environment-deployenjitterbit-agent.log. Cada entrada de registro incluye el ID del entorno y la duración de la sincronización en milisegundos. - Los tiempos de sincronización consistentemente largos indican un proyecto grande o conectividad lenta a Harmony. Para reducir los tiempos de sincronización, consulta ajuste de rendimiento de sincronización del entorno.
- Si las duraciones de sincronización son consistentemente excesivas (más de unos pocos minutos), contacta con soporte de Jitterbit.
- Para medir cuánto tiempo duran los bloqueos de sincronización, busca
El agente aparece como incapaz
-
Síntoma: Las operaciones enviadas al grupo de agentes se reintentan o se retrasan en lugar de ejecutarse inmediatamente.
ProcessEngine.logcontiene mensajes repetidos como:Agent (Id: ...) is incapable to process this message. Message will be auto-retried.Capability status changed from true to false -
Posibles causas:
- Todos los hilos de trabajo en el motor de procesos del agente ya están en uso, por lo que el agente no puede aceptar otra operación hasta que se libere un hilo. El tamaño del grupo se establece mediante
MaxNumberOfWorkerThreadsen la sección[ProcessEngine]dejitterbit.conf. - Una métrica de capacidad opcional está habilitada y ha alcanzado su umbral. El uso de CPU, el uso de memoria y el uso de hilos de Apache pueden contribuir al estado de capacidad, pero los tres están deshabilitados de forma predeterminada y se aplican solo cuando se activan en la sección
[AgentCapability]dejitterbit.conf. El uso de memoria se recopila solo en agentes Windows, por lo que no contribuye al estado de capacidad en un agente Linux incluso cuando la configuración de memoria está habilitada. Apache solo sirve solicitudes de API, por lo que el uso de hilos de Apache es relevante solo en un agente que maneja APIs. - Un único agente en el grupo está manejando más carga de la que puede sostener mientras otros agentes en el grupo están inactivos o subutilizados.
- Todos los hilos de trabajo en el motor de procesos del agente ya están en uso, por lo que el agente no puede aceptar otra operación hasta que se libere un hilo. El tamaño del grupo se establece mediante
-
Resolución: Revisa
ProcessEngine.logpara encontrar secuencias largas de cambios de estado de capacidad para confirmar que el agente alterna entre estados capaz e incapaz, luego investiga lo siguiente:- Si muchas operaciones se ejecutan consistentemente a la vez, revisa
MaxNumberOfWorkerThreadsen la sección[ProcessEngine]dejitterbit.conf. Aumentar este valor permite más operaciones concurrentes pero también aumenta la demanda de CPU y memoria, así que establécelo de forma conservadora. - Determina qué métricas de capacidad están habilitadas en la sección
[AgentCapability]. Si ninguna está habilitada, la carga de CPU y memoria no es lo que cambió el estado de capacidad del agente, y la disponibilidad de hilos es el factor más probable. Si el uso de CPU o memoria está habilitado, verifica esto antes que las métricas de hilos: si cualquiera de ellos cruza su umbral, el agente se vuelve incapaz independientemente de la disponibilidad de hilos. En un agente Linux, el uso de CPU es la única métrica de recurso del sistema que se aplica. - Verifica el uso de CPU y memoria en el host del agente en el momento del problema. Si la observabilidad nativa está habilitada, revisa los gráficos System Resource Capability, Apache Threads y Tomcat Threads en la pestaña Metrics de la página Agents de la Consola de Administración. Al revisar gráficos para un grupo de múltiples agentes, utiliza valores máximos o picos en lugar de promedios, ya que los promedios pueden ocultar un único agente sobrecargado mientras el resto del grupo parece estar en buen estado.
- Si el grupo de agentes contiene múltiples agentes, verifica
ProcessEngine.logen todos los agentes del grupo para determinar si todos los agentes fueron incapaces simultáneamente cuando la operación falló. Si solo un agente fue incapaz, la operación debería haberse enrutado a un agente capaz. Verifica que el equilibrio de carga esté configurado correctamente para el grupo. - Si los límites de recursos se alcanzan consistentemente, agrega agentes al grupo para distribuir la carga.
- Si la presión de memoria es el factor desencadenante, consulta Java heap space:
OutOfMemoryError.
- Si muchas operaciones se ejecutan consistentemente a la vez, revisa
Transformación falla: "No se pudo encontrar el archivo en el almacén de archivos local"
-
Síntoma: Una operación falla durante una transformación con un error que indica que falta un archivo en el almacén de archivos local del agente:
Failed to find file in the local file store. Will attempt a re-sync the files in the environment the next time the operation runs. There is no file in the local file store. File_ID = ... Failed to find file in the local file store. TransformID: ..., FileID: ..., Error: There is no file in the local file store. File_ID = ... [CODE:10808] -
Causa posible: Los metadatos de implementación de un archivo no se sincronizaron completamente desde la nube de Harmony al agente, por lo que el agente no puede localizar el archivo en tiempo de ejecución. Esto suele ser transitorio (por ejemplo, una breve interrupción de sincronización), pero también puede ocurrir después de exportar e reimportar un proyecto entre entornos.
- Resolución:
- Ejecuta la operación nuevamente. En la versión 11.38 del agente y posteriores, el agente se autocorrige: el error ocurre como máximo una vez por ID de archivo en un agente determinado, y el agente restaura los metadatos faltantes en la siguiente sincronización del entorno (la siguiente ejecución de operación o implementación). En la mayoría de los casos, ejecutar la operación nuevamente lo resuelve.
- Si el mismo archivo sigue fallando en múltiples ejecuciones en un agente actual, es probable que exista un problema más profundo, como un entorno que ha alcanzado su límite de registros de implementación o una regresión específica de la versión. Contacta con soporte de Jitterbit con el nombre de la operación que falla y los valores
TransformIDyFile_IDdel error.
Recuperar una instalación de Windows fallida
- Síntoma: La instalación o actualización de un agente privado de Windows falla o deja el agente en un estado roto.
- Resolución: Desinstalar completamente el agente y luego reinstalar el software del agente.
Conector no descargado al agente
-
Síntoma: Las operaciones fallan con errores que indican que un conector no está disponible o no se encuentra en el agente, típicamente después de que se lanza una nueva versión del conector o después de implementar un proyecto que utiliza un conector que el agente aún no ha descargado:
This connector was not found on the Jitterbit Agent. Please be patient with us while the connector is downloaded across the agents. This may take up to several minutes -
Posibles causas:
- La versión del conector requerida por el proyecto aún no se ha descargado de la nube al agente. Esto suele ser transitorio y se resuelve en unos minutos.
- Para agentes privados: el agente no puede alcanzar la nube de Harmony para descargar el conector.
-
Resolución:
- En Studio, abre la conexión afectada y haz clic en Test. Esto activa la descarga de la versión más reciente del conector desde la nube en el agente.
- Si el conector aún no se descarga, verifica si la política de organización Disable Auto Connector Update está habilitada. Cuando lo está, el botón Test no descarga versiones de conectores. Consulta Agent Management.
- Para descargar el conector sin cambiar la política, ve a la página Agents de la Consola de Administración, selecciona el grupo de agentes y elige Action > Update connectors. Esto fuerza una actualización del conector en todo el grupo y no se ve afectado por la política Disable Auto Connector Update.
- Para agentes privados, verifica que el host del agente pueda alcanzar la nube de Harmony. Consulta Agente sin conexión o inaccesible.
Nota
Los conectores Microsoft Excel y Excel v2 fallan al cargar con este error específicamente en la versión 12.x del agente privado. Este es un problema conocido con una solución alternativa separada. Consulta Excel and Excel v2 connectors fail to load en los problemas conocidos del agente privado.
La instalación del agente no puede registrarse a través de un proxy corporativo
-
Síntoma: Una instalación de agente privado en un host detrás de un proxy corporativo falla durante el paso de registro inicial, y el instalador reporta que no pudo alcanzar la nube de Harmony:
Could not connect to Jitterbit Harmony cloud -
Posibles causas:
- El proxy está bloqueando la conexión del agente a la nube de Harmony durante el registro.
- El proxy requiere autenticación que la configuración del proxy del agente no proporciona. Los agentes privados admiten autenticación de proxy, incluyendo un dominio NTLM. Consulta Servidor proxy para agentes privados de Jitterbit.
-
Resolución:
- Configura el proxy durante la configuración del agente para que el instalador pueda alcanzar la nube de Harmony a través de él, proporcionando las credenciales del proxy (y el dominio NTLM, si el proxy lo requiere). Consulta Configurar un proxy durante la configuración del agente.
- Si el registro aún falla a través del proxy, pide a tu equipo de red que permita los dominios e direcciones IP de Jitterbit a través del proxy, o que los omita. Las URL de Harmony específicas de la región se documentan en Allowlist information.
- Vuelve a ejecutar el instalador una vez que el proxy esté configurado o el host pueda alcanzar la nube de Harmony.
Bucle de reinicio del servicio del agente
- Síntoma: Los servicios del agente se bloquean y reinician repetidamente. Tomcat o el Process Engine se detiene e inicia en un bucle sin mantenerse en línea, y las operaciones fallan con errores como
Tomcat service is not running. Sijitterbit statusmuestra todos los servicios saludables en el host pero el estado mostrado solo parpadea entre Running, Unknown y Stopped, se trata de un problema de conectividad en lugar de un bucle de bloqueo. Consulta Agente sin conexión o inaccesible. -
Posibles causas:
- Un proceso Jitterbit huérfano de una ejecución anterior (un proceso de Tomcat, Process Engine o scheduler) aún está ocupando el puerto del servicio, por lo que cada reinicio falla con
java.net.BindException: Address already in usey el agente se cicla. - El host se queda sin memoria y el sistema operativo termina el proceso. Esto puede ocurrir cuando el host tiene muy poca memoria para la carga de trabajo, o cuando el límite de memoria de un contenedor se establece demasiado bajo.
- El host del agente tiene poco espacio en disco, o la base de datos PostgreSQL interna ha crecido lo suficiente como para fallar al iniciarse.
- El Process Engine se bloquea repetidamente bajo carga sostenida.
- Un proceso Jitterbit huérfano de una ejecución anterior (un proceso de Tomcat, Process Engine o scheduler) aún está ocupando el puerto del servicio, por lo que cada reinicio falla con
-
Resolución:
- Confirma que se trata de un verdadero bucle de bloqueo. Revisa los registros de Tomcat en
JITTERBIT_HOME/tomcat/logs/yProcessEngine.logpara ver la excepción registrada en cada reinicio. Unjava.net.BindException: Address already in useindica que un proceso huérfano está ocupando el puerto. - Detén el agente y finaliza cualquier proceso Jitterbit restante antes de reiniciarlo. Con el agente detenido, busca procesos extraviados: en Linux, ejecuta
ps aux | grep -E 'tomcat|jitterbit'y usakillen cualquier ID de proceso restante; en Windows, finaliza cualquier proceso Jitterbit o Tomcat extraviado en el Administrador de tareas. Inicia el agente nuevamente una vez que no quede ninguno. - Verifica eventos de falta de memoria. En Windows, revisa los registros de Aplicación y Sistema en el Visor de eventos; en Linux, ejecuta
journalctl -u jitterbito revisa/var/log/syslogpara eventos del asesino de OOM. Si el host se está quedando sin memoria, aumenta la memoria disponible (o el límite de memoria del contenedor). Consulta Espacio de montón Java:OutOfMemoryError. - Verifica el espacio en disco y la base de datos interna. Un disco lleno o una base de datos PostgreSQL inflada pueden bloquear los servicios en cada reinicio. Consulta Espacio en disco y acumulación de registros.
- Si los registros muestran que el Motor de procesos se bloquea en una operación específica, contacta al soporte de Jitterbit con los detalles de la operación y los registros del agente.
- Si la observabilidad nativa está habilitada, abre la pestaña Métricas de la página Agentes de la Consola de administración y revisa los gráficos de servicios de Tomcat y Motor de procesos para identificar cuándo comenzaron a fallar los servicios.
- Confirma que se trata de un verdadero bucle de bloqueo. Revisa los registros de Tomcat en
Operaciones que agotan el tiempo o ignoran la configuración de tiempo de espera
- Síntoma: Las operaciones se ejecutan indefinidamente o más tiempo del esperado. Para operaciones activadas por API, la configuración de tiempo de espera configurada en Studio parece no tener efecto, y las operaciones pueden permanecer atrapadas en estado En ejecución.
-
Posibles causas:
- De forma predeterminada, las operaciones activadas por API Manager ignoran la configuración de tiempo de espera de operación de Studio. La configuración
EnableAPITimeoutenjitterbit.confdebe habilitarse explícitamente para que las operaciones de API respeten los valores de tiempo de espera. - No se establece un tiempo de ejecución máximo de operación, por lo que las operaciones se ejecutan sin un límite de tiempo fijo.
- De forma predeterminada, las operaciones activadas por API Manager ignoran la configuración de tiempo de espera de operación de Studio. La configuración
-
Resolución:
- Para aplicar la configuración de tiempo de espera de operación para operaciones activadas por API, establece
EnableAPITimeout=trueen la sección[Settings]dejitterbit.conf. - Para limitar el tiempo de ejecución total de cualquier operación, establece
MaxOperationRuntimeSecondsen la sección[ProcessEngine]dejitterbit.conf. Esto requiere queRunOperationsInSeparateProcessseatrue(el valor predeterminado). - Reinicia los servicios del agente después de realizar cambios en
jitterbit.conf.
- Para aplicar la configuración de tiempo de espera de operación para operaciones activadas por API, establece
El rendimiento del agente no cambia después de aumentar max.concurrent.requests
- Síntoma: Después de aumentar
max.concurrent.requestsenjitterbit-agent-config.properties, el rendimiento del agente no mejora. -
Posibles causas:
- Solo se cambió
max.concurrent.requests. El rendimiento del agente también depende de los grupos de subprocesos de Tomcat y Apache y de los grupos de conexiones HTTP, por lo que aumentar solo esta configuración sin escalar las otras en conjunto no produce ganancia. - El host del agente no tiene suficiente CPU o memoria para la concurrencia agregada, o el agente está entrando en un estado incapaz bajo carga.
- Solo se cambió
-
Resolución:
- Sigue el procedimiento de ajuste completo en lugar de cambiar solo
max.concurrent.requests, escalando la configuración del grupo de subprocesos y del grupo de conexiones relacionados en conjunto. Consulta Rendimiento y ajuste del agente. - Confirma que el host del agente tiene suficiente margen de CPU y memoria para la concurrencia más alta. Si el agente se bloquea o entra en un estado incapaz bajo carga, consulta Bucle de reinicio del servicio del agente y Espacio de montón Java:
OutOfMemoryError.
- Sigue el procedimiento de ajuste completo en lugar de cambiar solo
Desaceleración de transformación XML después de actualizar al agente 11.45 o posterior
- Síntoma: Después de actualizar un agente privado a la versión 11.45 o posterior, una transformación que itera sobre un arreglo grande tarda más en ejecutarse que en la versión 11.44. La ralentización es específica de rutas de mapeo que utilizan la notación
#para iterar sobre cada elemento de un arreglo grande (aproximadamente varios cientos a algunos miles de registros). Las transformaciones que no iteran sobre arreglos grandes no se ven afectadas. - Causa posible: La biblioteca de análisis XML utilizada por el agente se actualizó en la versión 11.45, y la versión actualizada analiza datos XML grandes más lentamente. Esto afecta las transformaciones que iteran sobre un arreglo grande, porque el mapeo atraviesa repetidamente los datos analizados.
- Resolución:
- Revisar las rutas de mapeo de la transformación para la notación
#. Si una ruta utiliza#para iterar sobre un arreglo pero solo se necesita el primer elemento, eliminar#y volver a implementar. Eliminar#mapea solo el primer elemento, así que aplicar esto solo donde no sea necesario iterar sobre el arreglo completo. - Si el mapeo debe iterar sobre el arreglo completo, procesar menos registros por ejecución dividiendo un conjunto de datos grande en lotes más pequeños, de modo que cada transformación atraviese un arreglo más pequeño.
- Revisar las rutas de mapeo de la transformación para la notación
Los archivos de mini-volcado de JVM llenan el disco del agente
- Síntoma: El agente genera continuamente archivos grandes de bloqueo JVM (mini-volcados
.dmpy.mdmp, y archivoshs_err_pid*.log) en<JITTERBIT_HOME>/Tomcat/temp(o, en compilaciones más antiguas, la carpetaTomcatdirectamente), consumiendo el espacio en disco del host del agente. Esto afecta a agentes privados de Windows en versiones anteriores a 11.49. -
Causas posibles:
- El recopilador de estadísticas de disco
AgentStatsdel agente bloquea la JVM mientras recopila métricas de disco. Esto afecta a agentes en versiones anteriores a 11.49. - En agentes que ejecutan 11.47 o 11.48, un bloqueo separado en el Motor de Procesos puede producir los mismos archivos de bloqueo.
- El recopilador de estadísticas de disco
-
Resolución: Actualizar el agente privado a la versión 11.49 o posterior, que resuelve ambas causas.
Si no es posible una actualización inmediata y los archivos de bloqueo provienen de la recopilación de estadísticas de disco, se puede desactivar esa recopilación como solución temporal (la marca
DiskStatsEnabledestá disponible en el agente 11.44.1 y posterior):-
En
jitterbit.conf, agregar:[AgentStats] DiskStatsEnabled=false -
Reiniciar los servicios del agente. Los archivos de bloqueo existentes se pueden eliminar de forma segura para recuperar espacio en disco.
- Si se está en 11.47 o 11.48 y los archivos de bloqueo continúan, actualizar a 11.49 o contactar al soporte de Jitterbit para obtener una solución temporal.
-
PostgreSQL incluido en Linux utiliza MD5 en lugar de SCRAM-SHA-256
- Síntoma: Deseas cambiar el método de autenticación de PostgreSQL agrupado en un agente privado de Linux de MD5 a SCRAM-SHA-256, pero el agente continúa usando MD5.
-
Posibles causas:
- MD5 es el cifrado de contraseña predeterminado para PostgreSQL agrupado en agentes privados de Linux. SCRAM-SHA-256 fue el predeterminado solo en las versiones 12.6 y 12.7; la versión 12.8 revirtió el predeterminado a MD5. Cuando actualizas un agente de Linux desde 12.6 o 12.7, el instalador te solicita que restablezca el cifrado a MD5 o mantengas SCRAM-SHA-256; consulta Actualizar un agente de Linux.
- Editar solo
pg_hba.confypostgresql.confno completa el cambio. PgBouncer también debe reconfigurarse con el hash del verificador SCRAM, o el agente no se inicia.
-
Resolución: Para cambiar un agente privado de Linux a SCRAM-SHA-256, sigue la guía SCRAM en PostgreSQL. SCRAM-SHA-256 es un método de autenticación más seguro, mientras que MD5 es más eficiente, por lo que el cambio es una modificación deliberada y de varios pasos: la guía reconfigura PostgreSQL agrupado, actualiza las contraseñas de usuario y reconfigura PgBouncer con el nuevo hash. Reconfigurar la instancia agrupada es la forma compatible para habilitar SCRAM. No reemplaces la instancia agrupada con tu propio servidor PostgreSQL para obtener SCRAM: los agentes que usan una instancia de PostgreSQL distinta a la agrupada no son compatibles.
La conexión de sandbox de Salesforce falla con error de coincidencia de certificado
-
Síntoma: Una conexión de agente privado a un punto final que requiere Indicación de Nombre de Servidor (SNI) falla con una discrepancia de certificado, mientras que la misma conexión se realiza correctamente desde un grupo de agentes en la nube o desde una prueba directa de
opensslocurlen el host del agente. El caso más común es una URL de zona de pruebas de Salesforce que termina en.sandbox.my.salesforce.com:Certificate for <your-domain.sandbox.my.salesforce.com> doesn't match any of the subject alternative names: ...Otros puntos finales afectados incluyen hosts que comparten una única IP detrás de alojamiento virtual.
-
Causa: El protocolo de enlace TLS no incluye la extensión SNI, por lo que el servidor devuelve un certificado predeterminado en lugar del solicitado para el host. Para una zona de pruebas de Salesforce, el equilibrador de carga devuelve el certificado de producción, cuyos nombres no cubren
*.sandbox.my.salesforce.com. SNI se envía de forma predeterminada, por lo que cuando falta, algo lo está suprimiendo o eliminando. - Resolución:
-
Confirma que SNI es la causa. Desde el host del agente, compara el certificado devuelto con y sin SNI:
openssl s_client -connect HOST:443 -servername HOST   # certificate when SNI is sent
openssl s_client -connect HOST:443                    # certificate when SNI is omitted
-
Si el primero devuelve el certificado correcto y el segundo devuelve el que no coincide, SNI es la causa.
- Verifica si SNI está explícitamente deshabilitado en las opciones de Java del agente y elimínalo si es así. En Windows, abre el Editor del Registro en
HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\Apache Software Foundation\Procrun 2.0\Jitterbit Tomcat Server\Parameters\Javay edita el valorOptions; en Linux, verificaJAVA_OPTSen/etc/sysconfig/jitterbit. Elimina-Djsse.enableSNIExtension=falsesi está presente (esta configuración suprime SNI). Reinicia los servicios del agente. - Si SNI sigue faltando después de eso, un dispositivo de red, proxy o pila de red de VM entre el agente y el endpoint lo está eliminando. Tu equipo de red debe permitir que la extensión SNI pase.
Si la conexión también falla desde un grupo de agentes en la nube, SNI no es la causa. Es posible que el certificado del servidor no incluya el host en sus Nombres Alternativos del Asunto. Para Salesforce, agrega la URL de MyDomain del sandbox al certificado de Salesforce, o consulta Certificado con Nombre Alternativo del Asunto (SAN) no coincidente.
SSH: La conexión SFTP falla debido a una ruta de archivo de clave incorrecta
- Síntoma: Las operaciones SFTP fallan en un agente Windows aunque los archivos de clave SSH estén correctamente instalados.
- Causa: Los valores de ruta
PrivateKeyFileyPublicKeyFileen la sección[SSH]dejitterbit.confutilizan separadores de barra invertida de Windows (\), que no son compatibles. - Resolución: Utiliza barras diagonales en todas las rutas de archivos de clave SSH en
jitterbit.conf, incluso en Windows (por ejemplo,C:/jitterbit/keys/id_rsa). Consulta[SSH].
Configuración SFTP SSH faltante o en la sección jitterbit.conf incorrecta
-
Síntoma: Las operaciones SFTP que utilizan una clave privada para la autenticación fallan con un error de archivo de clave privada vacío después de una actualización o reinicio del agente. La configuración de clave SSH agregada al
jitterbit.conflocal también puede dejar de surtir efecto después de que el agente se reinicia.CURL_DEBUG_TEXT: Using SSH private key file '' CURL_DEBUG_TEXT: SSH public key authentication failed: Unable to extract public key from private key file -
Posibles causas:
- La configuración remota del agente está habilitada (está habilitada de forma predeterminada), por lo que la configuración administrada a través de la pestaña Configuración de Jitterbit de la Consola de Administración tiene prioridad. La configuración de clave SSH agregada solo al
jitterbit.conflocal puede no surtir efecto o no retenerse después de que el agente se reinicia. - La configuración de clave SSH (
PrivateKeyFile,PrivateKeyPassphrase,PublicKeyFile) está en la sección incorrecta. Las versiones más nuevas del agente analizan estrictamente e ignoran la configuración de SSH colocada fuera de la sección[SSH](por ejemplo, bajo[SSL]).
- La configuración remota del agente está habilitada (está habilitada de forma predeterminada), por lo que la configuración administrada a través de la pestaña Configuración de Jitterbit de la Consola de Administración tiene prioridad. La configuración de clave SSH agregada solo al
-
Resolución:
- Si la configuración remota está habilitada, agrega la configuración de clave SSH ahí: abre el cajón de detalles del grupo de agentes para el grupo de agentes, selecciona la pestaña Jitterbit Configuration y agrégalos bajo la sección
SSH. Consulta Jitterbit configuration. - Si el archivo local
jitterbit.confes la fuente de configuración, confirma que la configuración de clave SSH se encuentre bajo[SSH](no[SSL]). - Reinicia los servicios del agente.
- Para solucionar problemas adicionales de autenticación de clave SFTP (campos de contraseña, frase de contraseña, formato de clave), consulta SFTP "Login denied. Authentication failure." cuando se usan claves SSH.
- Si la configuración remota está habilitada, agrega la configuración de clave SSH ahí: abre el cajón de detalles del grupo de agentes para el grupo de agentes, selecciona la pestaña Jitterbit Configuration y agrégalos bajo la sección
Falla de autenticación SFTP en un servidor específico (error de coincidencia de cifra de cURL)
-
Síntoma: Una conexión SFTP que usa autenticación de clave SSH falla en un agente privado con
Login denied. Authentication failure., pero otras conexiones SFTP desde el mismo agente (usando la misma clave) funcionan correctamente, y conectarse al servidor que falla desde la línea de comandos del SO también funciona.Failed to get ftp directory list for url sftp://... Login denied. Authentication failure. -
Causa: El servidor SFTP requiere cifrados SSH más nuevos, intercambio de claves o algoritmos de clave de host que la biblioteca cURL incluida en versiones anteriores del agente no admite. Los servidores que aún aceptan los algoritmos más antiguos continúan funcionando, por lo que la misma clave funciona contra otros hosts y desde la línea de comandos del SO.
- Resolución: Actualiza el agente privado a la versión 11.37 o posterior, que incluye una biblioteca cURL actualizada con soporte para cifrados SSH actuales, intercambio de claves y algoritmos de clave de host.
Proxy HTTPS: Falla de autenticación básica a través del túnel proxy
- Síntoma: Cuando el agente se conecta a través de un proxy HTTPS que requiere autenticación básica, las conexiones a través del túnel proxy fallan con un error de autenticación.
- Causa: Las versiones modernas de JDK deshabilitan la autenticación básica durante la tunelización de proxy HTTPS de forma predeterminada. La propiedad de JVM
jdk.http.auth.tunneling.disabledSchemesbloquea la autenticación básica a menos que se borre explícitamente. - Resolución: Agrega
-Djdk.http.auth.tunneling.disabledSchemes=""aCATALINA_OPTSantes de iniciar Tomcat. Para obtener instrucciones paso a paso para Windows, Linux y Docker, consulta Permitir autenticación básica durante la tunelización de proxy HTTPS.
Agentes privados en redes restringidas: Conectividad solo saliente
- Síntoma: Al implementar agentes privados detrás de un firewall corporativo estricto o en un entorno restringido (por ejemplo, OpenShift) junto con una puerta de enlace de API privada, los equipos de red a veces preguntan qué puertos de entrada deben abrirse en el agente para que Harmony o la puerta de enlace lo alcancen.
-
Causa: Los agentes privados no requieren que se abra ningún puerto de entrada, debido a cómo funciona la conectividad del agente:
- Los agentes privados no aceptan conexiones de entrada desde Harmony ni desde una puerta de enlace de API privada. El agente establece una conexión WebSocket de salida a Harmony sobre HTTPS (puerto 443). Todo el tráfico desde Harmony y desde la puerta de enlace al agente se enruta de vuelta a través de esta conexión preestablecida.
- Una puerta de enlace de API privada envía solicitudes de API a Harmony, y Harmony enruta la solicitud al agente apropiado a través del WebSocket de salida existente. El agente enruta la carga útil de respuesta de API de vuelta a la puerta de enlace de API privada, por lo que el agente también debe poder alcanzar la puerta de enlace (directamente o a través de su equilibrador de carga en una implementación de múltiples puertas de enlace).
-
Resolución:
- Abrir HTTPS saliente (puerto 443) desde el host del agente hacia las URLs de la región de Harmony. La conexión se actualiza a WSS (WebSocket seguro) para la comunicación bidireccional continua. No es necesario abrir puertos entrantes en el host del agente para Harmony ni para la puerta de enlace.
- Al configurar el firewall, incluir en la lista de permitidos los servicios de Jitterbit específicos de la región que se enumeran en Comunicación saliente, la sección que aplica a un agente privado detrás de un firewall.
- Si el agente se ha configurado para usar puertos no predeterminados (personalizados), permitir también esos puertos a través del firewall corporativo. Consultar Puertos de red.
- Si se implementa una puerta de enlace de API privada, también permitir la conectividad saliente desde cada host del agente hacia la puerta de enlace (directamente o a través de su balanceador de carga en una implementación de múltiples puertas de enlace). El agente se conecta a la puerta de enlace para devolver la carga útil de respuesta de la API. Para ver el flujo de solicitud completo, consultar Arquitectura del sistema de puerta de enlace de API privada.
API personalizada devuelve 504 pero el registro de operaciones muestra éxito
- Síntoma: Una API personalizada devuelve un tiempo de espera de puerta de enlace 504, pero el registro de operaciones en la página Runtime de la Consola de Administración muestra que la operación se completó correctamente.
- Causa: Cuando una carga útil de solicitud o respuesta (encabezados más cuerpo, comprimida) supera aproximadamente 1 KB, la puerta de enlace de API en la nube de Jitterbit almacena la carga útil en etapas, y el agente privado realiza una conexión saliente al host
jitterbitsysservicede su región para descargar la carga útil de solicitud (o cargar la carga útil de respuesta) antes de completar la operación. Si el host del agente no puede alcanzar ese host, la transferencia agota el tiempo de espera y la API devuelve un 504 aunque la operación en sí se haya ejecutado. La verificación de conexión del agente estándar no verifica la conectividad al hostjitterbitsysservice, por lo que el agente puede parecer completamente conectado mientras este host permanece bloqueado. - Resolución:
- Agregar el host
jitterbitsysservicede su región (por ejemplo,jitterbitsysservice.jitterbit.net) y sus direcciones IP estáticas a la lista de permitidos saliente en el firewall del host del agente privado. Consultar Información de lista de permitidos de Jitterbit para las URLs e IPs específicas de la región. - Verificar la conectividad ejecutando una prueba HTTP desde el host del agente hacia la URL
jitterbitsysservicede su región, luego confirmar que la API ya no agota el tiempo de espera.
- Agregar el host
La observabilidad nativa no muestra datos
- Síntoma: Después de habilitar la observabilidad nativa, la pestaña Metrics de la página Agents de la Consola de administración no muestra datos, muestra datos incompletos o los gráficos permanecen vacíos después de esperar varios minutos.
-
Posibles causas:
- La sección
[AgentMetrics]enjitterbit.confno tieneEnabled=true, lo que impide que se ejecute el servicio de métricas. - No todos los parámetros requeridos en la sección
[AgentCapability]están establecidos entrue. - Los servicios del agente no se reiniciaron después de realizar cambios de configuración.
- El host del agente no puede alcanzar la nube de Harmony, lo que impide que se envíen las métricas.
- Antes de la versión 12.10 del agente, actualizar un agente privado de Windows cuyo puerto de PgBouncer ya era
6434(consulta Puertos de PgBouncer) no actualizaba la conexión del servicio de métricas para que coincidiera, por lo que permanecía en el puerto antiguo6432y la métrica de PGBouncer podría reportarse incorrectamente. - Antes de la versión 12.9 del agente, instalar un agente privado como usuario no root en Linux no aprovisionaba PgBouncer, por lo que el servicio nunca se iniciaba y su estado siempre se mostraba como no saludable.
- La sección
-
Resolución:
- Verifica que
jitterbit.confcontenga todos los parámetros requeridos de las secciones[AgentMetrics]y[AgentCapability]. Consulta el ejemplo de configuración completo en configuración de observabilidad nativa. - Revisa
metrics.logymetrics_service.logen el directorio de registros del agente para detectar errores. Estos registros documentan el estado del servicio de métricas e indican si se están recopilando y enviando métricas. - Reinicia los servicios del agente si se realizaron cambios de configuración.
- Verifica que el host del agente pueda alcanzar la nube de Harmony. Consulta Agente sin conexión o inaccesible. Si el agente se conecta a través de un proxy, consulta Métricas del agente faltantes cuando el agente se conecta a través de un proxy HTTP.
- Para un agente afectado por la discrepancia de puertos, actualiza a la versión 12.10 del agente o posterior, que corrige automáticamente el puerto de conexión de PgBouncer del servicio de métricas. Si la discrepancia persiste después de actualizar, contacta al soporte de Jitterbit para verificar el puerto.
- Para un nuevo agente privado de Linux no root, usa la versión 12.9 o posterior, donde PgBouncer se aprovisiona correctamente durante la instalación. Actualizar un agente Linux no root existente a 12.9 o posterior no aprovisiona PgBouncer retroactivamente; el agente debe instalarse nuevamente.
- Verifica que
Métricas del agente faltantes cuando el agente se conecta a través de un proxy HTTP
- Síntoma: El agente privado se conecta exitosamente a Harmony a través de un proxy HTTP configurado, pero la pestaña Métricas de la página Agentes de la Consola de Administración no muestra datos. El archivo
metrics.logpuede contener entradas comoClient.Timeout exceeded while awaiting headers. - Causa: El agente envía métricas sobre HTTPS utilizando una conexión separada que no hereda la configuración del proxy del agente. Si el proxy solo admite HTTP o no está configurado para el tráfico de métricas del agente, las métricas no pueden llegar a Harmony aunque el agente mismo se conecte exitosamente.
- Resolución:
- Confirma que el proxy admita HTTPS. Las métricas del agente se envían sobre HTTPS, por lo que un proxy que solo maneja tráfico HTTP las bloquea. Habilitar HTTPS en el proxy resuelve el problema.
- Si no puedes habilitar HTTPS en el proxy, o las métricas siguen faltando después de habilitarlo, el tráfico de métricas del agente necesita su propia configuración de proxy, separada de la del agente. Contacta al soporte de Jitterbit para configurarlo.
El agente de Datadog falla al iniciarse después de la instalación de Docker
- Síntoma: Después de instalar el agente Datadog dentro de un contenedor Docker como parte de la configuración de observabilidad de Datadog, el agente Datadog falla al iniciarse.
- Causa: Un problema conocido de Datadog causa que el agente falle al iniciarse cuando el archivo de configuración del agente de seguridad no existe.
-
Resolución: Copia el archivo de configuración del agente de seguridad de ejemplo:
cp /etc/datadog-agent/security-agent.yaml.example /etc/datadog-agent/security-agent.yamlLuego inicia el agente Datadog. Ten en cuenta que en Docker, el agente Datadog no se inicia automáticamente con el contenedor y debe iniciarse manualmente después de cada inicio del contenedor:
sudo datadog-agent run
Linux: Los servicios del agente no se inician después de un reinicio ("postmaster.pid no existe")
-
Síntoma: Después de reiniciar un host de agente privado en Linux, los servicios del agente no se inician. Al ejecutar
sudo jitterbit statusse muestran el planificador y otros servicios sin ejecutarse, y los registros del agente (o consola) incluyen errores como:postmaster.pid does not existreindexdb: could not connect to database template1: could not connect to server: No such file or directory -
Causa: Los permisos de archivo en el directorio de datos de PostgreSQL incluido son demasiado permisivos. PostgreSQL requiere que el directorio de datos sea
700(solo propietario). Si los permisos son más amplios (por ejemplo,755o777), PostgreSQL se niega a iniciarse, lo que impide que el resto del agente se inicie. -
Resolución:
-
Confirmar que
/opt/jitterbity sus subdirectorios son propiedad del usuario y grupojitterbit:sudo chown -R jitterbit:jitterbit /opt/jitterbit -
Establecer el directorio de datos de PostgreSQL en
700:sudo chmod 700 /opt/jitterbit/DataInterchange/pgsql/data -
Iniciar los servicios del agente:
sudo /etc/init.d/jitterbit start
-
Linux: El antivirus elimina PgBouncer, el agente falla al autenticarse en la base de datos incluida
-
Síntoma: Después de migrar un agente privado en Linux a un nuevo host (o realizar una instalación limpia), los servicios del agente no se inician. El archivo
postgresql.logmuestra:[FATAL] password authentication failed for user "jitterbit"El registro del agente muestra que no puede conectarse a la base de datos. El error persiste incluso después de desinstalar e reinstalar completamente.
-
Causa: Un producto antivirus basado en host o de protección de puntos finales detecta el binario de PgBouncer incluido como sospechoso y lo elimina o pone en cuarentena. Sin PgBouncer, el agente no puede autenticarse en su base de datos PostgreSQL interna.
-
Resolución:
- Desactivar temporalmente el antivirus o el producto de protección de puntos finales en el host del agente.
- Agregar el directorio de instalación de Jitterbit (típicamente
/opt/jitterbit) a la lista de exclusión del antivirus. -
Reinstalar el agente. En RHEL/CentOS:
sudo dnf reinstall jitterbit-agent -
Iniciar los servicios del agente y confirmar el funcionamiento normal, luego reactivar el antivirus con la exclusión en su lugar.
Los escaneos de seguridad marcan log4j-over-slf4j.jar como una vulnerabilidad de Log4j 1.x
- Síntoma: Un escaneo de seguridad de una instalación de agente privado marca archivos como
log4j-over-slf4j-1.7.21.jarcomo una vulnerabilidad de Log4j 1.x fuera de soporte. - Resolución: No se requiere ninguna acción.
log4j-over-slf4j.jarno es Log4j 1.x. Es parte del marco de registro SLF4J y actúa como un puente que redirige las llamadas de bibliotecas de terceros escritas contra la API de Log4j 1.x al marco de registro actual y compatible del agente. El archivo no contiene el código vulnerable de Log4j 1.x. Su presencia es la mitigación del agente contra la exposición de Log4j 1.x, no una instancia de la vulnerabilidad.
Servicio de escucha "El clúster no ha alcanzado el tamaño mínimo requerido"
-
Síntoma: Las operaciones que utilizan el servicio de escucha fallan con:
Failed to enable events for operation. Cluster has not met the minimum required size. -
Posibles causas:
- Muy pocos agentes del grupo de agentes están ejecutándose y unidos al clúster. Para un grupo de \(N\) agentes, contados independientemente de si cada agente está ejecutándose, \((N / 2) + 1\) agentes (redondeados hacia abajo) deben estar ejecutándose y formar parte del clúster.
- Uno o más agentes perdieron su conexión al clúster y no pudieron reconectarse, lo que redujo el número de agentes ejecutándose y unidos por debajo del \((N / 2) + 1\) requerido.
- Una interrupción de red dividió el grupo de agentes en múltiples clústeres más pequeños. Por ejemplo, en un grupo de 4 agentes, una división de red puede producir dos clústeres de 2 agentes cada uno; ninguno cumple con el \((N / 2) + 1\) requerido de 3, por lo que ambos reportan el error aunque cada agente esté ejecutándose.
-
Resolución:
- Confirma que \((N / 2) + 1\) de los agentes del grupo están ejecutándose y forman parte del clúster, donde \(N\) es el número de agentes registrados en el grupo de agentes, independientemente de si cada uno está ejecutándose. Por ejemplo, un grupo de 4 agentes requiere 3, y un grupo de 5 agentes también requiere 3. Para ver qué agentes se han unido, utiliza la API REST del servicio de escucha para mostrar el estado del clúster.
- Verifica que los puertos TCP 5701 y 5801 estén abiertos entre todos los hosts de agentes y no estén bloqueados por reglas de antivirus o firewall.
- Si el clúster está inactivo y los mensajes permanecen sin procesar con persistencia habilitada, restaura el clúster manualmente. Consulta Restauración del clúster después de una falla del agente.
Nota
Se recomienda un número impar de agentes en el grupo de agentes, pero no es obligatorio. Con un número par, una interrupción de red puede dejar el grupo dividido en dos mitades, ninguna de las cuales es lo suficientemente grande para mantener el clúster en funcionamiento.
Mensajes del servicio de escucha no entregados
- Síntoma: El mecanismo de reintentos del clúster descarta silenciosamente los mensajes no entregados después de un período configurado, lo que causa que las operaciones dependientes no se ejecuten.
- Resolución: Para extender la ventana de retención o evitar la eliminación, edita
JITTERBIT_HOME/Resources/jitterbit-agent-config.propertiesy estableceagent.sdk_framework.retry.deleteRetryableMessageAfteren un valor más alto (en minutos). Para retener todos los mensajes indefinidamente, establece el valor en-1. Reinicia el agente después de realizar los cambios.
Registros de operación de API personalizada no aparecen
- Síntoma: Una operación activada por una API personalizada se ejecuta sin errores, pero no aparece ninguna entrada de registro en Studio ni en la página Runtime de la Consola de Administración.
- Causa: Cuando una API personalizada activa una operación, los registros de operación se generan solo cuando la operación no es exitosa. Las operaciones de API personalizada exitosas no producen ninguna entrada de registro de forma predeterminada.
- Resolución: Para capturar registros de operaciones de API personalizada exitosas, habilita el registro de depuración de operación para la operación. Ten en cuenta que API Manager tiene su propia vista de registro separada para solicitudes de API.
El registro de depuración de operación se detiene antes de la fecha de finalización seleccionada
- Síntoma: El registro de depuración de operación se habilitó con una fecha de finalización futura, pero los registros dejan de generarse antes de que se alcance esa fecha.
- Causa: En grupos de agentes en la nube, la fecha de finalización de la configuración de registro de depuración de operación no es confiable. Los registros pueden dejar de generarse antes de que finalice el período de tiempo configurado.
- Resolución: Vuelve a habilitar el registro de depuración de operación según sea necesario.
Archivos de registro de depuración de operación sin datos .input o .output
- Síntoma: En un agente privado, una operación tiene el registro de depuración de operación habilitado con los datos de entrada y salida del componente activados. La carpeta de registro de depuración en
DataInterchange/Temp/Debugcontiene los archivos.jtrpara cada paso, pero faltan los archivos de datos.inputy.outputcorrespondientes. -
Posibles causas:
- El servicio de limpieza del agente está eliminando los archivos
.inputy.outputantes de que se puedan revisar. - El agente se reinició mientras la operación aún se estaba ejecutando, por lo que los archivos nunca se escribieron completamente. Consulta Los datos de entrada/salida del componente no se generan para ese escenario.
- El servicio de limpieza del agente está eliminando los archivos
-
Resolución:
- En el host del agente, abre
CleanupRules.xmlen el directorio de instalación del agente. -
Encuentra la regla de limpieza para el directorio
DataInterchange/Temp/Debuge incrementa el valor<FileAge NumDays = "2"...>a una ventana de retención más larga (por ejemplo, 7).<CleanupRule> <DirectoryPath SearchSubDirectory = "YES" >DataInterchange/Temp/Debug</DirectoryPath> <Pattern>*</Pattern> <FileAge NumDays = "7" Comparator = "GE"/> <FileSize Size = "0" Comparator = "GE"/> </CleanupRule> -
Reinicia los servicios del agente.
- En el host del agente, abre
Datos de entrada/salida del componente no generados
- Síntoma: El registro de depuración de operación está habilitado con la generación de datos de entrada y salida del componente activada, pero no aparecen archivos de datos de entrada/salida para operaciones de agente privado.
-
Resolución: Verifica el registro del servicio Verbose Log Shipper en el agente:
<JITTERBIT_HOME>/VerboseLogShipper/verbose-log-shipper.out.logSi el registro muestra errores, reinicia el servicio Verbose Log Shipper. En Linux, esto se puede hacer sin un reinicio completo del agente:
jitterbit stop verboselogshipper
jitterbit start verboselogshipper
En Windows y Linux, reiniciar todos los servicios del agente de Jitterbit también reinicia el servicio Verbose Log Shipper.
Jitterbit MQ: Mensajes de cola de quórum descartados silenciosamente después de 20 intentos NACK
- Síntoma: Los mensajes en una cola de mensajes de tipo quórum desaparecen sin error, aunque se vuelven a encolar repetidamente a través de la actividad NACK.
- Causa posible: Las colas de quórum aplican un límite de entrega de 20 intentos por mensaje. Después de que un mensaje es reconocido negativamente 20 veces sin un reconocimiento exitoso, se elimina permanentemente de la cola sin generar un error.
- Resolución:
- Configura una Cola de Letra Muerta para capturar mensajes que excedan el límite de entrega y evitar la pérdida silenciosa de datos.
- Si se requiere reprocesamiento repetido más allá de 20 intentos, usa un tipo de cola Clásica en lugar de Quórum al crear la cola en la página Colas de Mensajes.
Jitterbit MQ: Entorno no habilitado para mensajería
- Síntoma: Las operaciones que utilizan el conector Jitterbit MQ no logran conectarse o enviar mensajes, aunque la cola exista en la Consola de Administración.
- Causa posible: Todos los entornos están deshabilitados para mensajería de forma predeterminada. Se puede crear una cola de mensajes en un entorno que aún no ha sido habilitado para mensajería.
- Resolución:
- En la Consola de Administración, ve a la página Colas de Mensajes y haz clic en el icono de configuración .
- En la sección Permisos de Entornos, habilita la mensajería para el entorno afectado y luego haz clic en Guardar.
Jitterbit MQ: El límite de mensajes excedido causa "Error al enviar mensaje"
-
Síntoma: Las operaciones que utilizan el conector Jitterbit MQ fallan con:
"statuscode":500,"Error":"Error sending message." -
Causa posible: El número de mensajes en la cola ha alcanzado su límite configurado. Cuando se excede el límite, el servicio rechaza los nuevos mensajes con un error 500.
- Resolución:
- Reconoce o procesa los mensajes existentes en la cola para llevar el recuento por debajo del límite.
- Alternativamente, en la página Colas de Mensajes de la Consola de Administración, abre la cola afectada, expande Opciones Avanzadas e incrementa el valor de Límite de Mensajes.
Jitterbit MQ: Los mensajes NACK bloquean el progreso de la cola cuando se vuelven a encolar
- Síntoma: Al usar una actividad NACK con Requeue Messages After NACK seleccionado, los mensajes regresan al frente de la cola en lugar del final. Si los mensajes fallan repetidamente y se vuelven a encolar, los mismos mensajes fallidos se entregan nuevamente en cada recuperación posterior, lo que impide que otros mensajes en la cola se procesen.
- Causa: El intermediario de mensajes subyacente coloca un mensaje reencolado en la cabecera de la cola para reentrega inmediata. Este comportamiento no se puede cambiar a través del conector.
- Resolución: Para evitar que los mensajes fallidos bloqueen el progreso de la cola, utiliza uno de los siguientes enfoques:
- Cola de Letra Muerta: Configura la actividad NACK para usar Reject Messages After NACK y establece una Cola de Letra Muerta para capturar los mensajes rechazados. Procesa la Cola de Letra Muerta por separado, con un retraso si es necesario, para reintentar los mensajes fallidos sin bloquear la cola principal.
- Re-publicación manual: Configura la actividad NACK para usar Reject Messages After NACK, luego usa una actividad Send para re-publicar el mensaje en la cola original. Un mensaje re-publicado se coloca al final de la cola, lo que permite que otros mensajes se procesen primero.
Inicio de sesión de Design Studio: error de certificado SSL o filtro proxy
- Síntoma: Design Studio muestra un error de certificado SSL o filtro proxy al intentar iniciar sesión.
- Posibles causas:
- Un certificado SSL o CA firmado utilizado por tu red (por ejemplo, de un filtro web, proxy o VPN) no está presente en el Almacén de claves Java de Jitterbit.
- La lista de permitidos de IP para tu proxy de red o filtro web no incluye las direcciones de Jitterbit requeridas. Consulta Información de lista de permitidos.
- Resolución: Para obtener los pasos de resolución completos, incluida la forma de agregar certificados al Almacén de claves Java de Jitterbit, consulta Error de certificado SSL o configuración de filtro proxy.
Design Studio marcado como software malicioso en macOS Sequoia
- Síntoma: En macOS 15 (Sequoia), macOS muestra una advertencia indicando que Design Studio es software malicioso e impide que se abra.
- Causa posible: macOS Gatekeeper advierte sobre aplicaciones que no están certificadas por Apple y se distribuyen fuera de la Mac App Store. Como Design Studio se distribuye desde la página Descargas del portal Harmony, macOS reporta que no puede verificarlo en busca de software malicioso. Este es el comportamiento estándar de macOS, no un problema real con el instalador.
- Resolución:
- Confirma que Design Studio se descargó desde la página oficial Descargas del portal Harmony.
- Si ves la advertencia de software malicioso para una instalación descargada desde el portal, la advertencia puede descartarse: no indica un riesgo de seguridad real con el instalador de Jitterbit.
Design Studio: interfaz borrosa o pequeña en pantallas de alta densidad de Windows 10
- Síntoma: Los elementos de Design Studio aparecen borrosos o demasiado pequeños al ejecutarse en Windows 10 con una pantalla de alta resolución (DPI), como un monitor 4K.
- Causa posible: Una configuración de escalado de DPI predeterminada de Windows 10 que no es compatible con Design Studio.
- Resolución: Para conocer los pasos de resolución, consulta Error de escalado de pantalla de alta densidad en Windows 10.
Design Studio: tiempo de carga de proyecto largo al usar un proxy
-
Síntoma: Abrir un proyecto de Design Studio tarda varios minutos o más cuando se conecta a través de un proxy. Esto puede ir acompañado de un error como:
Message: Unable to load image icon at this address: https://citizen.jitterbit.eu/v1/endpoints/s3images/financialforce.png Details: Can't get input stream from URL! -
Causa posible: El retraso generalmente se debe a que Design Studio intenta obtener los iconos de recetas de Citizen Integrator a través de un proxy que no puede alcanzar el servidor de imágenes externo.
- Resolución: Para conocer los pasos de resolución, consulta Tiempos de carga prolongados al usar un proxy.
Design Studio macOS: error "Client Properties Do Not Exist" al iniciar
- Síntoma: Design Studio no se inicia en macOS y muestra un error indicando que las propiedades del cliente no existen.
- Causa posible: Design Studio se inició directamente desde la imagen de disco (
.dmg) en lugar de hacerlo desde la carpeta Aplicaciones. La aplicación debe copiarse a la carpeta Aplicaciones antes de poder localizar sus archivos de configuración. - Resolución:
- Cierra Design Studio si está en ejecución.
- Abre el archivo instalador
.dmg. - Arrastra el icono de Jitterbit Studio a la carpeta Aplicaciones en la ventana del instalador.
- Inicia Design Studio desde la carpeta Aplicaciones (o desde Spotlight/Launchpad), no desde la imagen de disco.
Design Studio: la transformación con un script falla con error "/PRESCRIPT/ node"
-
Síntoma: Una transformación que utiliza un script falla en tiempo de ejecución con:
No se puede encontrar el nodo de destino (/PRESCRIPT/). La estructura puede haber cambiado, así que intenta abrir la transformación 'example' y actualizar los árboles de estructura. -
Posible causa: La estructura XML interna de la transformación se ha vuelto inconsistente con el esquema de destino actual, típicamente después de un cambio de esquema.
- Resolución:
- Abre la transformación que falla en Design Studio.
- En el lado Target, haz clic en el botón de actualización en la parte superior del árbol de estructura. Esto relee el esquema y reconstruye la estructura interna de la transformación.
- Guarda e implementa la transformación.
No se recomienda almacenar proyectos de Design Studio en un recurso compartido de archivos de red
- Síntoma: Un proyecto de Design Studio almacenado en un recurso compartido de archivos de red (en lugar de almacenamiento local o en la nube de Harmony) presenta pérdida de datos, donde los cambios de la interfaz de usuario no persisten después de reabrirse el proyecto, o el rendimiento es notoriamente más lento de lo esperado.
- Causa posible: Jitterbit no recomienda almacenar espacios de trabajo de proyectos de Design Studio en un recurso compartido de archivos de red. El almacenamiento en recursos compartidos de archivos de red carece de los mecanismos de bloqueo de archivos que Design Studio requiere, lo que genera guardados inconsistentes y posible pérdida de datos.
- Resolución: Mueve el espacio de trabajo del proyecto al almacenamiento local o utiliza almacenamiento en la nube de Harmony en lugar de un recurso compartido de archivos de red.
Design Studio: descarga de proyecto falla con error Invalid XML character
-
Síntoma: La descarga de un proyecto a Design Studio falla con un error que indica que se encontró un carácter XML inválido en el contenido del elemento, por ejemplo:
An invalid XML character (Unicode: 0x15) was found in the element content of the documento:
org.xml.sax.SAXParseException; lineNumber: 17499; columnNumber: 21; An invalid XML character (Unicode: 0x5) was found in the element content of the document. -
Causa posible: Los metadatos del proyecto contienen un carácter de control (como
0x05o0x15) que no es válido en XML. Esto puede resultar de una URL de punto de conexión corrupta o de caracteres inusuales pegados en scripts, notas u otros campos de texto. - Resolución:
- Abre el proyecto en Design Studio (o utiliza una copia de seguridad local reciente) para inspeccionar los metadatos.
- Revisa las URL de puntos de conexión, scripts y notas para detectar caracteres invisibles o inusuales y elimínalos o reemplázalos. El número de línea en el mensaje de error puede ayudar a localizar el área afectada en el XML exportado.
- Guarda e implementa el proyecto corregido, luego reintenta la descarga desde Design Studio.
- Si no se puede identificar el contenido ofensivo, contacta al soporte de Jitterbit con el mensaje de error completo e ID del proyecto para posible reparación de metadatos en el servidor.
Design Studio: componentes de proyecto faltantes después de descargar o importar
- Síntoma: Al abrir o importar un proyecto se muestran operaciones en la lista pero no aparecen componentes (transformaciones, scripts, esquemas), o un archivo
.jsonde exportación del proyecto no se puede importar. La causa suele ser un único componente corrupto en la exportación del proyecto que interrumpe el análisis de todo el archivo. - Causa posible: Un componente dentro de la exportación del proyecto tiene JSON mal formado, como un cuerpo vacío o caracteres inusuales que invalidan el archivo.
- Resolución:
- Exporta el proyecto desde el portal de Harmony para producir un archivo
.json. - Abre el archivo
.jsonen un editor de texto e inspecciona el arraycomponentspara buscar entradas que parezcan vacías, mal formadas o que contengan caracteres inusuales. - Elimina el objeto JSON completo del componente sospechoso del array
components. - Guarda el archivo e impórtalo nuevamente a Harmony.
- Si la corrupción no es identificable, envía la exportación del proyecto al soporte de Jitterbit para análisis.
- Exporta el proyecto desde el portal de Harmony para producir un archivo
Design Studio: operaciones o transformaciones duplicadas aparecen en un proyecto descargado
- Síntoma: Algunos usuarios que descargan el mismo proyecto ven operaciones o transformaciones duplicadas con nombres y esquemas idénticos, y esos duplicados se marcan como inválidos (marcados en rojo) en Design Studio. Otros usuarios ven una versión limpia del mismo proyecto.
- Causa posible: El proyecto se migró a nivel de operación (en lugar de a nivel de proyecto), y la migración agregó copias duplicadas de dependencias (como transformaciones) al proyecto original.
- Resolución:
- Realiza una copia de seguridad del proyecto antes de hacer cambios.
- Identifica las operaciones o transformaciones duplicadas. Elimina los duplicados mientras conservas los originales.
- Implementa el proyecto limpio. Todos los usuarios que descarguen nuevamente el proyecto recibirán la versión limpia.
- Para evitar esto en el futuro, evita usar migración a nivel de operación en un proyecto que ya contiene los componentes de origen. Usa migración a nivel de proyecto o migra selectivamente solo las dependencias que aún no están presentes.
Design Studio: importación de proyecto Salesforce falla con requisito de versión incorrecto
-
Síntoma: La importación o apertura de un proyecto con un endpoint de Salesforce falla con un error como:
The Jitterpak requires version 12.7.0.0 or higher. The Studio is currently running version [your Design Studio version]. This means that the Jitterpak cannot be opened by this Studio.Esto puede ocurrir incluso en una versión actual y compatible de Design Studio, porque Design Studio nunca ha tenido una versión 12.x.
-
Causa posible: El proyecto se exportó desde Design Studio 11.63 o 11.64. Estas versiones marcan un proyecto que contiene un endpoint de Salesforce con un requisito de versión incorrecto (
12.7.0.0) en lugar de la versión mínima correcta. Design Studio 11.64.1 y versiones posteriores exportan el requisito de versión correcto. -
Resolución:
-
Si el proyecto se exportó a un archivo
.jpklocal:- Cambia el nombre del archivo
.jpka.zipy luego extráelo. - En
environment.properties, cambia el valor derequires-versionpara que coincida con tu versión instalada de Design Studio, por ejemplo:requires-version=11.63.0.0. - En
jitterpak.properties, cambia el valor derequired_versional valor codificado correspondiente. Para Design Studio 11.63.0.0, usarequired_version=110630000000000. Para cualquier otra versión, exporta un nuevo proyecto vacío desde tu Design Studio instalado y copia los valores derequired_versionyrequires-versionde los archivos de ese proyecto. - Comprime los archivos extraídos nuevamente en un archivo
.zip, cambia su nombre a.jpke impórtalo.
Estos pasos corrigen solo el archivo
.jpkque editas. Reexportar el proyecto desde Design Studio 11.63 o 11.64 escribe nuevamente el requisito de versión incorrecto, así que actualiza a Design Studio 11.64.1 o posterior para evitar esto. - Cambia el nombre del archivo
-
Si el error ocurre al descargar o abrir un proyecto implementado en la nube de Harmony en lugar de al importar un archivo
.jpklocal:- Actualiza a Design Studio 11.64.1 o posterior.
- Contacta al soporte de Jitterbit para solicitar la corrección del backend al requisito de versión almacenado del proyecto, que no está disponible en la interfaz de usuario de Design Studio. Solicita la corrección solo después de actualizar: abrir o reexportar el proyecto con una versión anterior afectada después puede escribir nuevamente el requisito de versión incorrecto en el proyecto.
-
Design Studio: fallo SOAP no se implementa cuando se configura para activar un correo electrónico directamente
- Síntoma: Configurar una falla de SOAP para activar directamente una notificación por correo electrónico no se implementa o no funciona como se esperaba.
- Causa posible: Implementar una operación en la que una falla de SOAP activa directamente un mensaje de correo electrónico puede producir un error.
- Resolución:
- Configura la falla de SOAP para activar una operación en su lugar.
- En esa operación, usa la función
SendEmailMessageen un script para enviar el correo electrónico de notificación.
Design Studio: transferencias de archivos se repiten inesperadamente
- Síntoma: Una operación retransfiere un archivo de origen que ya se procesó en una ejecución anterior.
- Causa posible: Design Studio rastrea tres criterios para determinar si un archivo ya se ha transferido: nombre de archivo, fecha de modificación e ID de operación. Si alguno de estos valores ha cambiado desde la última transferencia, Design Studio trata el archivo como nuevo y lo transfiere nuevamente.
- Resolución: Para evitar que un archivo específico se retransfiera, elimina su entrada de la lista de historial de transferencias: selecciona la casilla junto a la entrada en el panel inferior y haz clic en Eliminar.
Design Studio: modo pasivo FTP y restricciones de firewall de puerto alto
- Síntoma: Un origen FTP se conecta correctamente desde una estación de trabajo pero falla cuando la operación se ejecuta en el agente privado, o las transferencias de archivos agotan el tiempo de espera a pesar de que el agente puede alcanzar el servidor FTP.
- Causa posible: El modo pasivo de FTP utiliza puertos de números altos asignados dinámicamente para transferencias de datos. Los firewalls que restringen conexiones salientes a puertos conocidos bloquean estas conexiones de canal de datos, incluso cuando el canal de control (puerto 21) está abierto.
- Resolución:
- Confirma que Modo pasivo esté habilitado en la configuración del origen FTP (está habilitado por defecto).
- Trabaja con tu administrador de red para abrir el rango de puertos de números altos que utiliza tu servidor FTP para conexiones de datos pasivos en el firewall entre el host del agente privado y el servidor FTP.
Design Studio: las rutas de carpeta de éxito y error de FTP están en el agente, no en el servidor FTP
- Síntoma: Los archivos no aparecen en la carpeta de éxito o error configurada después de que se ejecuta una operación FTP, o las rutas parecen resolverse a ubicaciones inesperadas.
- Causas posibles:
- Los campos de ruta de carpeta de éxito y carpeta de error en un origen FTP se refieren a directorios en la máquina del agente privado, no en el servidor FTP remoto. Las rutas relativas se interpretan en relación con el sistema de archivos del host del agente.
- Las variables de palabras clave de nombre de archivo no se resuelven en estos campos.
- Resolución:
- Ingresa rutas absolutas en el host del agente privado para los campos de carpeta de éxito y error (por ejemplo,
C:\Jitterbit\processed\en Windows o/var/jitterbit/processed/en Linux). - No utilices palabras clave de nombre de archivo ni caracteres especiales como
*en estos campos de ruta. - Confirma que la cuenta de servicio del agente tiene permisos de escritura en los directorios configurados.
- Ingresa rutas absolutas en el host del agente privado para los campos de carpeta de éxito y error (por ejemplo,
Design Studio: no se puede analizar el listado de directorios FTP
- Síntoma: Una fuente FTP no puede listar archivos, o faltan archivos conocidos de la fuente aunque existan en el servidor FTP.
- Causa posible: Algunos servidores FTP devuelven listados de directorios en un formato no estándar que Design Studio no puede analizar con su analizador predeterminado.
- Resolución:
- En la configuración de la fuente FTP, habilita List only filenames. Esto hace que la fuente use el comando NLST, que devuelve solo nombres de archivo en lugar de un listado de directorio completo y es más ampliamente compatible entre servidores FTP.
- Alternativamente, establece la variable de Jitterbit
jitterbit.source.ftp.enable_regex_parserentrueantes del paso de lectura FTP para habilitar un analizador de listado más flexible.
Design Studio: el objetivo FTP Usar cambio de nombre FTP no es funcional con operaciones de archivo SFTP
- Síntoma: Los archivos escritos en un servidor SFTP usando un destino FTP con Use FTP Rename habilitado fallan o no se escriben correctamente cuando el tipo de operación es archivo.
- Causa posible: La opción Use FTP Rename no es funcional al escribir en un servidor SFTP en una operación de archivo.
- Resolución: En la configuración del destino FTP, desactiva la casilla Use FTP Rename cuando el servidor de destino es un servidor SFTP y la operación escribe un archivo.
Design Studio: el objetivo FTP Crear directorios automáticamente no es confiable
- Síntoma: Una operación de destino FTP falla porque un directorio de destino no existe, aunque Auto Create Directories esté habilitado.
- Causa posible: Es un problema conocido que la opción Auto Create Directories funciona de manera inconsistente. Dependiendo del servidor FTP en particular, es posible que el directorio no se cree.
- Resolución:
- Crea manualmente los directorios requeridos en el servidor FTP antes de ejecutar la operación.
- Si usas Auto Create Directories, confirma que el directorio se haya creado antes de depender de él en producción.
Design Studio: archivos individuales de origen de recurso compartido de archivos mayores de 2 GB no se pueden recuperar
- Síntoma: La recuperación de un archivo grande de una fuente File Share falla, aunque el archivo existe y la conexión de la fuente está configurada correctamente.
- Causa posible: Las fuentes File Share tienen una limitación conocida donde es posible que no se puedan recuperar archivos individuales mayores a 2 GB.
- Resolución: Divide los archivos mayores a 2 GB en segmentos más pequeños antes de colocarlos en el recurso compartido de archivos para su recuperación.
Design Studio: prueba de conexión de origen HTTP falla aunque el extremo sea accesible
- Síntoma: La prueba de una conexión de fuente HTTP falla con un error de conexión o autorización, pero se confirma que el endpoint es accesible y devuelve datos cuando se accede directamente en un navegador o cliente API.
- Causa posible: El botón Test Connection en la configuración de la fuente HTTP envía una solicitud HTTP HEAD. Algunos servidores no admiten el método HEAD y devuelven un error 405 o similar, aunque las solicitudes GET y POST tengan éxito.
- Resolución:
- Si se confirma que el endpoint es accesible en un navegador o mediante una solicitud GET/POST directa, se puede descartar la prueba de conexión fallida. Procede con la implementación y ejecución de la operación para verificar la conectividad real.
- Si la operación también falla en tiempo de ejecución, investiga más usando los registros de operación.
Design Studio: error de URL del centro de datos de NetSuite, usar URL WSDL específica de cuenta
-
Síntoma: Un endpoint de NetSuite que anteriormente se conectaba correctamente ahora falla con:
Connector Error: Error getting the data center URL.
...
In this account, you must use account-specific domains with this SOAP web services endpoint.
o:
You are not requesting the correct data center for your company. -
Causa posible: NetSuite ya no acepta URLs WSDL genéricas (por ejemplo,
https://webservices.netsuite.com/...) ni URLs WSDL específicas del centro de datos (por ejemplo,https://webservices.na3.netsuite.com/...). El endpoint debe usar una URL WSDL específica de la cuenta. - Resolución:
- En NetSuite, ve a Setup > Company > Company Information y abre la pestaña Company URLs para encontrar el dominio específico de la cuenta.
- Construye la URL WSDL específica de la cuenta con el formato
https://<account-id>.suitetalk.api.netsuite.com/wsdl/v2025_1_0/netsuite.wsdl. - Actualiza el campo WSDL Download URL en la configuración del endpoint de NetSuite con la URL específica de la cuenta.
- Para obtener instrucciones completas, consulta URL WSDL específica de la cuenta de NetSuite.
Design Studio: usuarios de TFA de NetSuite no deben usar tipo de autenticación SSO
- Síntoma: Un endpoint de NetSuite configurado con autenticación de inicio de sesión único (SSO) falla o se comporta de manera inesperada para un usuario que tiene autenticación de dos factores (TFA o 2FA) habilitada en su cuenta de NetSuite.
- Causa posible: Los usuarios de NetSuite con TFA habilitado no deben usar el tipo de autenticación SSO al configurar un endpoint de NetSuite. Esta combinación puede causar que el endpoint falle. NetSuite también está eliminando gradualmente el tipo de autenticación SSO.
- Resolución:
- Habilita la autenticación basada en tokens (TBA) en la cuenta de NetSuite.
- Reconfigura el endpoint de NetSuite para usar TBA en lugar de SSO.
Design Studio: error de NetSuite TBA INSUFFICIENT_PERMISSION en tiempo de ejecución a pesar de que la prueba de conexión fue exitosa
-
Síntoma: Un endpoint de NetSuite configurado con autenticación basada en tokens (TBA) prueba la conexión exitosamente, pero las operaciones fallan en tiempo de ejecución con:
INSUFFICIENT_PERMISSION -
Causa posible: El rol utilizado para generar los tokens de acceso de TBA no tiene permisos suficientes para las operaciones que se están ejecutando. La prueba de conexión se realiza correctamente incluso con un rol con permisos insuficientes, pero las verificaciones de permisos en tiempo de ejecución fallan.
- Resolución:
- En NetSuite, cambia a un rol de Acceso Completo o Administrador al generar los tokens de acceso, o agrega los permisos requeridos al rol actual.
- Regenera los tokens de acceso usando el rol actualizado y reconfigura el endpoint de NetSuite.
Design Studio: la lista desplegable de búsqueda guardada de NetSuite está vacía cuando el objeto tiene más de 1,000 búsquedas guardadas
- Síntoma: El menú desplegable de búsqueda guardada en la configuración de la actividad de NetSuite no se completa con ninguna opción, aunque existan búsquedas guardadas para el objeto en NetSuite.
- Causa posible: NetSuite impone un límite de 1,000 registros en las solicitudes de API. Si un objeto tiene más de 1,000 búsquedas guardadas, la solicitud de API para recuperarlas excede este límite y no devuelve resultados, dejando el menú desplegable vacío.
- Resolución: En NetSuite, elimina o archiva las búsquedas guardadas que ya no estén en uso para reducir el recuento total por debajo de 1,000 para el objeto afectado. El menú desplegable se completará una vez que se reduzca el recuento. Para obtener más detalles, consulta Limitaciones de búsqueda guardada de NetSuite.
Design Studio: no se pueden pasar valores NULL o en blanco de NetSuite a campos personalizados
- Síntoma: Asignar un valor NULL o en blanco (cadena vacía) a un campo personalizado de NetSuite no borra el campo en NetSuite.
- Causa posible: La API de NetSuite no acepta valores NULL o en blanco para campos personalizados a través del enfoque estándar de asignación de campos.
- Resolución: Para pasar valores NULL o en blanco a un campo personalizado, asigna el campo de origen a los campos secundarios
externalIdynamedel nodo de destino del campo personalizado en la transformación. Para más detalles, consulta Pasar valores nulos a campos personalizados.
Design Studio: segmentos personalizados de NetSuite no mostrados en la configuración de actividades
- Síntoma: Los segmentos personalizados no aparecen en la pantalla de configuración de actividad de NetSuite cuando se espera que estén disponibles para asignación.
- Causa posible: La cuenta de usuario de NetSuite configurada en el endpoint no tiene permisos suficientes para acceder al segmento personalizado o al objeto con el que está asociado.
- Resolución:
- En NetSuite, verifica que la cuenta de usuario configurada en el endpoint de NetSuite tenga los permisos apropiados para interactuar con el segmento personalizado y su objeto asociado.
- Si los permisos son insuficientes, actualiza el rol de usuario en NetSuite para incluir el acceso requerido al segmento personalizado.
Design Studio: es posible que los cambios de conexión OAuth 2.0 de Salesforce no se conserven antes de probar o implementar
- Síntoma: Después de cambiar los campos URL de instancia, ID de cliente o Secreto de cliente de una Organización de Salesforce existente configurada con autenticación de cliente OAuth 2.0 de 2 patas, hacer clic en Probar inicio de sesión de Salesforce puede devolver un resultado de éxito o fracaso engañoso basado en los valores de campo anteriores en lugar de los que acaban de ingresarse.
- Causa posible: Antes de Design Studio 11.67, los cambios en estos campos no se guardaban de manera confiable antes de que se ejecutara la prueba de conexión.
- Resolución: Actualiza a Design Studio 11.67 o posterior. Si utilizas un agente privado, también actualiza a la versión 12.11 o posterior; los grupos de agentes en la nube reciben esta corrección automáticamente.
Design Studio: no se encuentran IDocs de SAP cuando una operación programada se ejecuta en un agente diferente
- Síntoma: En un grupo de múltiples agentes que utiliza procesamiento de IDoc de almacenamiento y reenvío, la operación programada que busca archivos IDoc almacenados no encuentra archivos para procesar en algunas ejecuciones, y el procesamiento de IDoc se retrasa u ocurre fuera de orden.
- Causa posible: En el procesamiento de almacenamiento y reenvío, el Escucha de eventos de SAP almacena cada IDoc recibido en el sistema de archivos local del agente que lo recibió. Una operación separada con una programación rápida luego busca y procesa esos archivos, pero Harmony puede enviar esa operación programada a cualquier agente del grupo. Cada agente procesa solo los archivos almacenados en sí mismo, por lo que los archivos almacenados en un agente no se procesan hasta que la programación seleccione ese agente nuevamente.
- Resolución: Cada agente procesa sus propios archivos almacenados la próxima vez que la operación programada se ejecuta en él, por lo que los archivos se procesan eventualmente. Si los IDocs deben procesarse en un orden garantizado, o sin esperar la próxima ejecución programada del agente que los almacena, escribe los archivos IDoc en un recurso compartido al que todos los agentes puedan acceder, como un sitio FTP, un sistema de archivos compartido o una base de datos. Ten en cuenta que un almacén de datos externo añade un punto de fallo; de lo contrario, los clústeres de agentes se utilizan para conmutación por error y equilibrio de carga.
Design Studio: los envíos masivos de IDoc de SAP pueden exceder los límites de conexión del punto final de destino
- Síntoma: Después de que una operación masiva grande de SAP envía miles de IDocs, las operaciones contra un sistema de destino descendente (como Salesforce) fallan intermitentemente con errores de límite de conexión o inicio de sesión.
- Causa posible: Los IDocs se envían de forma asincrónica. Cuando una actualización masiva genera miles de IDocs, todos ellos intentan activar sus operaciones descendentes simultáneamente. Sistemas como Salesforce aplican límites de conexión de API concurrentes, y una avalancha repentina de operaciones activadas por IDoc puede exceder esos límites.
- Resolución:
- Utiliza un patrón de almacenamiento y reenvío: configura el escucha de IDoc para escribir los IDocs entrantes en archivos temporales, luego usa una operación programada para procesarlos en lotes controlados a una velocidad predecible.
- Revisa los límites de conexión concurrente y llamadas de API del punto de conexión de destino y configura la operación de Design Studio para mantenerse dentro de esos límites limitando el número de operaciones simultáneas.
Design Studio: carga útil de IDoc de SAP perdida cuando el punto final de destino es inaccesible
- Síntoma: El Escucha de Eventos de SAP recibe un IDoc pero los datos no llegan al punto de conexión de destino y no se pueden recuperar.
- Causa posible: En el procesamiento directo, si el punto de conexión de destino es inaccesible cuando se procesa el IDoc, la carga útil no se entrega y se pierde permanentemente. No hay un mecanismo de reintento automático en el procesamiento directo.
- Resolución: Utiliza en su lugar el procesamiento de almacenamiento y reenvío: configura la primera operación para escribir el IDoc entrante en un archivo temporal, luego usa una operación programada para procesar el archivo. Si el destino es inaccesible, el archivo se retiene y se reprocesa en la siguiente ejecución programada. Para obtener orientación sobre la implementación del procesamiento de almacenamiento y reenvío, consulta Prácticas recomendadas para SAP.
Design Studio: archivos temporales de almacenamiento y reenvío de IDoc de SAP eliminados después de 24 horas
- Síntoma: En un flujo de trabajo de IDoc de almacenamiento y reenvío, faltan archivos temporales que no han sido procesados del directorio de almacenamiento antes de que se haya ejecutado la operación de procesamiento.
- Causa posible: De forma predeterminada, los archivos temporales de IDoc en el procesamiento de almacenamiento y reenvío se eliminan automáticamente después de 24 horas. Si la operación de procesamiento programada no se ejecuta dentro de ese período (por ejemplo, debido a tiempo de inactividad del agente), los archivos se eliminan antes de que se puedan procesar.
- Resolución:
- Asegúrate de que la operación de procesamiento programada se ejecute al menos una vez cada 24 horas para procesar los archivos antes de que expiren.
- Alternativamente, aumenta el período de retención si se requiere una ventana más larga. Para obtener más detalles, consulta Prácticas recomendadas para SAP.
Design Studio: la operación BAPI de SAP se realiza correctamente pero la transacción no se confirma
- Síntoma: Ejecutar un BAPI parece ejecutarse sin error, pero la transacción esperada no aparece en SAP.
- Causa posible: El Conector de SAP emite una confirmación de transacción BAPI solo cuando el BAPI devuelve un tipo de respuesta
S(Éxito). Si el BAPI devuelve un tipo de respuestaI(Información),E(Error) oW(Advertencia), no se emite confirmación y la transacción no se guarda en SAP. - Resolución:
- Verifica el campo TYPE del nodo
RETURNen la respuesta de BAPI para confirmar el tipo de respuesta que se devuelve. - Si utilizas un BAPI personalizado, actualízalo para devolver un tipo de respuesta
Scuando la transacción deba confirmarse. Para obtener más detalles, consulta Solución de problemas de confirmaciones de BAPI.
- Verifica el campo TYPE del nodo
Design Studio: el Escuchador de Eventos de SAP no detecta iDocs en Windows
-
Síntoma: El servicio Escucha de Eventos de SAP se está ejecutando, el sistema SAP reporta IDocs salientes como enviados exitosamente, pero no se activan operaciones. Los registros del agente muestran errores de conexión para el ID de programa RFC, como:
serverException occured on [Program ID] connection null -
Causa posible: El archivo de servicios de Windows en el host del agente no contiene una entrada para el servicio de puerta de enlace de SAP. Sin esta entrada, el escucha del ID de programa RFC no puede resolver el nombre de host y puerto de la puerta de enlace de SAP, lo que impide que los IDocs se entreguen a Design Studio.
-
Resolución:
- En el host de Windows que ejecuta el agente privado, abre
%WINDIR%\System32\drivers\etc\servicescomo administrador. -
Agrega las siguientes líneas:
sapgw00 3300/tcp sapgw00 3300/udp -
Guarda el archivo, reinicia el servicio Escucha de Eventos de SAP y el agente, y vuelve a probar enviando un IDoc desde SAP.
- En el host de Windows que ejecuta el agente privado, abre
El nombre de servicio sapgw00 y el puerto 3300 corresponden al servicio de puerta de enlace de SAP predeterminado para el número de sistema 00. Si tu sistema SAP utiliza un número de sistema diferente, ajusta las entradas en consecuencia (por ejemplo, sapgw01 3301/tcp y sapgw01 3301/udp para el número de sistema 01).
Gestión de API
Esta sección cubre problemas con la capacidad de gestión de API de Harmony: crear, publicar y asegurar APIs.
No se puede publicar una API: se alcanzó el límite de API de suscripción
-
Síntoma: La creación o publicación de una API falla con un error como:
You have reached Maximum no of API Service configured for your Jitterbit organization -
Causa: La organización ha alcanzado el número máximo de URLs de API publicadas permitidas por su suscripción. Cada API personalizada publicada, servicio OData o API proxy (y cada uno de sus clones publicados) utiliza una URL de API; las APIs en borrador no cuentan.
- Resolución: En la página APIs del Administrador de API, verifica los conteos de URLs de API personalizadas utilizadas y URLs de API proxy utilizadas, que se muestran en la parte superior de la página, con los totales permitidos por tu suscripción. Desactiva la publicación o elimina las APIs que ya no necesites para liberar URLs de API (las APIs en borrador no cuentan para el límite). Para aumentar el límite, contacta a tu Gerente de éxito del cliente.
La API publicada devuelve 404 No encontrado
- Síntoma: Llamar a una API publicada devuelve un error 404.
- Posibles causas:
- El límite de Solicitudes por minuto en el perfil de seguridad asignado se establece en cero, bloqueando todas las solicitudes. Un cambio en el nivel de suscripción de la organización puede restablecer este límite, así que una API que funcionaba previamente puede comenzar a devolver 404s.
- La configuración, URL base o configuración de visibilidad de la API son incorrectas.
- Una puerta de enlace de API privada no reconoce la API después de la implementación.
- La API no se ha publicado completamente o sus metadatos están incompletos.
- Resolución:
- Abre el perfil de seguridad asignado a la API y confirma que el valor de Solicitudes por minuto se establece en un número distinto de cero. Si el límite se restableció recientemente (por ejemplo, después de un cambio de suscripción), restáuralo al valor previsto.
- En la página APIs, verifica que la API se haya publicado exitosamente y que su URL y configuración de visibilidad sean correctas.
- Si la API se sirve a través de una puerta de enlace de API privada, verifica la instalación de la puerta de enlace y la conectividad para detectar errores o configuraciones incorrectas.
HTTP 504 Tiempo de espera de puerta de enlace
-
Síntoma: Las llamadas de API devuelven:
504 Gateway TimeoutEsto generalmente ocurre después de la ventana de tiempo de espera de la puerta de enlace (30 a 180 segundos, según la configuración de Tiempo de espera de la API).
-
Causas posibles:
- La URL de la API está mal formada, o los parámetros de ruta no se están manejando correctamente, lo que causa que la puerta de enlace falle al enrutar la solicitud.
- La operación de backend o el servicio externo es demasiado lento para responder dentro de la ventana de tiempo de espera de la puerta de enlace, por ejemplo, debido a cargas útiles grandes o lógica de transformación compleja.
- No se puede asignar la solicitud a un agente disponible, por ejemplo, porque el grupo de agentes está con concurrencia máxima o bajo carga pesada, por lo que agota el tiempo de espera en la puerta de enlace antes de que se ejecute la operación. Una señal de este caso es que la solicitud fallida no tiene una entrada correspondiente en los registros de operaciones.
-
Resolución:
- Verifica que la URL de la API esté correctamente formada. Si la API utiliza parámetros de ruta, considera agregar un script a la operación que analice explícitamente la URL y capture los valores de los parámetros.
- Si el tiempo de espera se debe a un backend lento, revisa la operación y su lógica de transformación para detectar cuellos de botella de rendimiento, particularmente cargas útiles de datos grandes o llamadas externas lentas, y reduce el paso lento.
- Si la operación realmente requiere más tiempo del que permite la configuración actual, aumenta el tiempo de espera en la pestaña de configuración de la API. El tiempo de espera de la API (30 segundos por defecto, máximo 180 segundos) es independiente del tiempo de espera de la operación de Studio; el tiempo de espera de la operación se utiliza solo en agentes privados cuando la configuración
EnableAPITimeoutestá habilitada en la configuración del agente. - Si la operación no puede completarse dentro del tiempo de espera máximo, o no se requiere una respuesta en tiempo real, rediseña la operación de la API para iniciar el trabajo de larga duración de forma asincrónica (por ejemplo, llamándola con
RunOperationen modo asincrónico) para que la API pueda devolver una respuesta sin esperar a que termine. Consulta Administrar operaciones asincrónicas. - Para tiempos de espera intermitentes, agrega reintentos de modo que se vuelva a intentar una falla transitoria: utiliza la configuración de reintento integrada de la conexión HTTP v2 para llamadas salientes, o un bucle de reintento de
RunOperationcon script con una demora entre intentos. - Si los tiempos de espera se correlacionan con la carga del agente, revisa la capacidad del agente: ejecuta operaciones que sirven API en agentes separados de cargas de trabajo ETL pesadas, y agrega agentes al grupo si está saturado. Consulta Optimizar y mejorar el rendimiento de los agentes privados de Jitterbit.
Portal de API que no refleja cambios del proyecto
- Síntoma: El Portal de API muestra nombres o atributos de proyecto desactualizados después de que se ha renombrado o actualizado un proyecto.
- Causa posible: El Portal de API no se sincronizó automáticamente después de que se cambió el proyecto.
- Resolución:
- Para actualizar todas las APIs personalizadas y proxy en el entorno, abre el Administrador de portales y haz clic en Regenerate Docs. Para actualizar una única API, abre su pestaña Documentation en la página APIs y haz clic en Save & Publish.
- Verifica que la información actualizada se refleje correctamente en el Portal de API.
Microsoft Entra ID OAuth: el nombre del perfil de seguridad no puede contener espacios
-
Síntoma: Las llamadas a la API que utilizan un perfil de seguridad OAuth 2.0 de tres etapas de Microsoft Entra ID (Azure AD) fallan con un error de Microsoft que indica una falta de coincidencia de URL de respuesta:
The reply URL specified in the request does not match the reply URLs configured for the application. -
Posible causa: El nombre del perfil de seguridad contiene espacios. Los espacios en el nombre del perfil causan que el URI de redireccionamiento de OAuth se construya incorrectamente, lo que no coincide con ninguna de las URL de respuesta registradas en el registro de la aplicación de Azure.
- Resolución:
- Abre el perfil de seguridad en API Manager y cambia su nombre para eliminar los espacios (por ejemplo, cambia
My ProfileaMyProfileomy-profile). - En el registro de la aplicación de Azure, verifica que las URL de respuesta registradas allí coincidan con el URI de redireccionamiento que API Manager genera para el perfil renombrado.
- Abre el perfil de seguridad en API Manager y cambia su nombre para eliminar los espacios (por ejemplo, cambia
Microsoft Entra ID OAuth de 2 tramos: error OAUTH_INVALID_TOKEN_CODE
-
Síntoma: Las llamadas a la API protegidas por un perfil de seguridad OAuth 2.0 de dos etapas de Microsoft Entra ID fallan con:
Failed to validate authentication token - HttpErrorResponse: OAUTH_INVALID_TOKEN_CODE -
Posible causa: El claim
auden el JWT emitido por Entra ID no coincide con la audiencia configurada en el perfil de seguridad de API Manager. Esto generalmente indica que el URI de identificador de aplicación en el registro de aplicaciones de Azure está mal configurado, o el scope de OAuth que solicita el cliente no coincide con el URI registrado. - Resolución:
- En Azure Portal, abre el registro de aplicaciones asignado a este perfil de seguridad y ve a Exponer una API.
- Confirma que el URI de identificador de aplicación esté configurado con un URI válido en el formato
api://<Application (client) ID>. - En el perfil de seguridad, confirma que el Scope de OAuth esté configurado como
api://<Application (client) ID>/.default. - Actualiza la aplicación cliente para solicitar un token usando este scope exacto.
- Si la validación aún falla después de que la audiencia y el scope sean correctos, abre el manifiesto del registro de aplicaciones y confirma que
requestedAccessTokenVersionesté configurado en2. Un valor faltante o diferente también puede causar que falle la validación del token.
Se ha retirado la API de Azure AD Graph
- Síntoma: Las llamadas a API que anteriormente funcionaban con un perfil de seguridad de Microsoft Entra ID (Azure AD) fallan con errores de autenticación.
- Posible causa: El registro de aplicaciones del perfil de seguridad aún está configurado para usar Azure AD Graph API, que Microsoft retiró el 30 de junio de 2025. Los registros de aplicaciones que no migraron a Microsoft Graph fallan al realizar solicitudes.
- Resolución:
- En Azure Portal, migra el registro de aplicaciones a Microsoft Graph.
- Después de migrar, actualiza el manifiesto de la aplicación siguiendo los pasos de permisos de API en la configuración del perfil de seguridad OAuth de 2 patas de Microsoft Entra ID.
Proveedor de identidad de Google o Salesforce: OAuth de 2 tramos no es compatible
- Síntoma: Un perfil de seguridad de API configurado con Google o Salesforce como proveedor de identidad de OAuth 2.0 falla cuando se configura para OAuth de 2 patas.
- Posible causa: Los perfiles de seguridad de API de OAuth 2.0 de Google y Salesforce no son compatibles con OAuth de 2 patas.
- Resolución: Usa un perfil de seguridad de OAuth 2.0 de 3 patas para API que se autentiquen con Google o Salesforce como proveedor de identidad.
Microsoft Copilot Studio: autenticación básica no compatible
- Síntoma: La conexión de una API personalizada de Jitterbit a Microsoft Copilot Studio (como una herramienta de API REST) falla cuando el perfil de seguridad de la API usa autenticación básica.
- Posible causa: Microsoft Copilot Studio no es compatible con autenticación básica. Una API personalizada de Jitterbit cuyo perfil de seguridad usa autenticación básica no puede ser llamada desde Copilot Studio.
- Resolución:
- En API Manager, abre el perfil de seguridad asignado a la API.
- Cambia el tipo de autenticación a Clave de API u OAuth 2.0, o elimina el perfil de seguridad de la API si el endpoint no requiere autenticación.
- Republica la API, luego reconéctala en Microsoft Copilot Studio. Consulta Conectar un agente de Jitterbit AI a Microsoft Copilot Studio.
Botón "Nueva API" no visible a pesar de tener el rol correcto en la organización
- Síntoma: El botón New API no aparece en API Manager para un usuario que tiene un rol a nivel de organización pero no es administrador de la organización. Otorgar al usuario el permiso Admin a nivel de organización hace que el botón aparezca, pero también expone todos los entornos al usuario.
- Causa posible: Un rol a nivel de organización por sí solo no es suficiente para crear APIs. El rol también debe tener acceso de Write otorgado a nivel de entorno para el entorno específico donde necesita crear APIs.
- Resolución:
- En la Management Console, ve a Environments y abre el entorno donde el usuario necesita crear APIs.
- Para el rol del usuario en ese entorno, confirma que el acceso de Write está habilitado. Si no es así, habilítalo y guarda los cambios.
- El botón New API ahora debería estar visible para ese entorno.
Autenticación básica: una credencial en caché de una solicitud anterior afecta una llamada de API posterior
-
Síntoma: Una credencial de autenticación básica en caché de una solicitud anterior puede afectar una llamada de API posterior de cualquiera de estas maneras:
- Una API con dos o más perfiles de seguridad de autenticación Basic asignados muestra nombres de usuario inesperados en los registros de API, incluyendo nombres de usuario que no pertenecen a ninguno de los perfiles. Algunas solicitudes fallan con un error 401 Unauthorized.
- Una API proxy u OData service asignada a un perfil de seguridad de autenticación Basic devuelve una respuesta exitosa sin solicitar credenciales.
-
Causa posible: El navegador o cliente de API (como Postman) ha almacenado en caché las credenciales de autenticación básica de una sesión anterior como una cookie. Cuando se llama a la API nuevamente, el cliente envía la cookie en caché primero. Si las credenciales en caché no coinciden con ningún perfil de seguridad asignado, la solicitud se rechaza y el nombre de usuario inesperado aparece en los registros antes de que la autenticación tenga éxito con las credenciales correctas. Si coinciden, la solicitud se completa sin un nuevo mensaje.
-
Resolución:
- Borra las cookies y el caché del navegador, o cambia a una ventana de navegación en incógnito o privada, antes de volver a probar la API.
- Confirma que el comportamiento no está presente cuando se realiza una solicitud nueva sin cookies de sesión anterior. Si el comportamiento desaparece, se trata de almacenamiento en caché de credenciales del lado del cliente y no de un problema de configuración.
Ten en cuenta que cualquier cliente HTTP que almacene cookies (incluyendo herramientas basadas en navegador y utilidades de prueba de API) puede exhibir el mismo comportamiento.
Error INVALID_TRIGGER_USER o TRIGGER_USER_TOO_LONG
- Síntoma: Una llamada de API que utiliza un perfil de seguridad con autenticación básica o una configuración Custom de Logging falla con un error
INVALID_TRIGGER_USERoTRIGGER_USER_TOO_LONG, aunque las mismas credenciales o valor de encabezado funcionaron anteriormente. -
Causa posible: El valor utilizado para identificar a quien realiza la llamada de la solicitud viola una regla de validación: contiene un carácter no permitido (
INVALID_TRIGGER_USER) o excede 256 caracteres (TRIGGER_USER_TOO_LONG).- Para autenticación básica con la configuración de Logging predeterminada, este valor es el campo User name del perfil de seguridad.
- Para una configuración Custom de Logging, es el valor que la aplicación que realiza la llamada envía en el encabezado configurado.
La validación de caracteres se agregó en la versión 12.10 de Harmony, y el límite de longitud se agregó en la versión 12.11 de Harmony. Una API gateway privada que ejecuta una versión anterior no aplica la validación correspondiente, por lo que cualquiera de estos errores puede aparecer por primera vez después de actualizar la gateway, aunque la configuración del perfil de seguridad no haya cambiado.
A partir de la versión 12.12 de Harmony, el campo Nombre de usuario del perfil de seguridad rechaza los caracteres no permitidos, por lo que ya no se puede guardar un perfil de seguridad que los contenga. Para la autenticación Basic con la configuración predeterminada de Logging, INVALID_TRIGGER_USER se aplica únicamente a los perfiles de seguridad guardados antes de esa versión.
- Solución:
- Para la autenticación Basic con la configuración predeterminada de Logging, edita el campo Nombre de usuario del perfil de seguridad para eliminar los caracteres no permitidos o acortarlo a 256 caracteres o menos, según sea aplicable, y luego actualiza las credenciales en cualquier aplicación que llame y que haga referencia al nombre de usuario anterior.
- Para una configuración de Custom Logging, actualiza la aplicación que llama para enviar un valor de encabezado que no contenga caracteres no permitidos y tenga 256 caracteres o menos.
401 No autorizado con una lista de direcciones IP permitidas válida (caché obsoleta)
- Síntoma: Las llamadas a la API devuelven
401 Unauthorizedaunque la IP del cliente esté correctamente listada en los grupos de IP de confianza del perfil de seguridad. - Causa posible: Un caché obsoleto de entradas de rangos de IP heredados en el perfil de seguridad está anulando los grupos de IP de confianza activos.
- Solución: Migra el perfil de seguridad de rangos de IP heredados al modelo de Grupos de IP de confianza, el mecanismo de lista de permitidos actual: define las IPs como un grupo de IP de confianza y asígnalo al perfil. Deshabilitar la configuración Trust requests only from the following IP ranges en un perfil que aún usa rangos de IP heredados elimina permanentemente esos rangos (una solicitud de confirmación te advierte de esto), por lo que migra las IPs a un grupo de IP de confianza en lugar de desactivar la configuración para limpiar el caché.
Salesforce en Hyperforce: Las llamadas a una API se rechazan después de que cambian las direcciones IP de Salesforce
-
Síntoma: Las llamadas desde Salesforce a una API (mensajes salientes, llamadas de Apex, Salesforce Connect o acciones invocables) se rechazan después de que la organización de Salesforce se migra a Hyperforce, la infraestructura de nube pública de Salesforce. El perfil de seguridad de la API tiene Trust requests only from the following IP ranges habilitado con un grupo de IP de confianza que lista las direcciones IP de Salesforce.
-
Causa posible: Los grupos de IP de confianza coinciden con la dirección IP de origen de una solicitud, y las direcciones que una organización de Salesforce en Hyperforce usa para llamadas salientes cambian con el tiempo. Un grupo que lista un conjunto fijo de direcciones de Salesforce deja de coincidir.
-
Solución: Salesforce recomienda autenticar las llamadas en tu red en lugar de permitir sus direcciones IP de origen:
- Abre el perfil de seguridad asignado a la API y establece su Tipo de autenticación en Clave de API. Configura la llamada de Salesforce para enviar la clave en un encabezado de solicitud, no en un parámetro de consulta, para que no se registre en las URL de las solicitudes. OAuth 2.0 también está disponible, aunque con Salesforce como proveedor de identidad, el único flujo es 3-legged, que requiere interacción manual.
-
Después de que la llamada se autentica correctamente, desasigna el grupo de IP de confianza que enumera las direcciones de Salesforce, para que los cambios de direcciones posteriores ya no afecten la API. Desasigna el grupo en lugar de desactivar Confiar solo en solicitudes de los siguientes rangos de IP, que elimina permanentemente cualquier rango de IP heredado aún presente en el perfil.
Si tu organización requiere lista de permitidos de IP, Salesforce publica sus rangos de Hyperforce como una lista dinámica en ip-ranges.salesforce.com/ip-ranges.json, anunciando adiciones con anticipación. Esa lista cambia cada vez que Salesforce modifica sus direcciones, así que mantener una lista de permitidos actual significa rastrear el archivo y actualizar el grupo de IP de confianza para que coincida. Se rechazan las llamadas desde una dirección agregada después de la última actualización del grupo. Estas direcciones también se comparten entre organizaciones de Salesforce, así que agregarlas a la lista de permitidos confirma de dónde proviene una solicitud, no que provenga de tu organización. Para la orientación completa de Salesforce, incluyendo SSL bidireccional (mTLS), Proveedores de autenticación y aplicaciones conectadas, consulta Retain uninterrupted access to Salesforce services on Hyperforce.
URL del servicio excede la longitud máxima (HTTP 414)
-
Síntoma: La puerta de enlace de API devuelve:
414 URI Too Large -
Causa posible: La URL del servicio construida (incluida la URL base, la ruta del servicio y cualquier parámetro de ruta o consulta) excede 8,000 caracteres.
- Resolución:
- Reducir la longitud de la URL del servicio acortando la ruta del servicio o dividiendo la API en varios puntos de conexión.
- Para API proxy, confirmar que la combinación de la URL base y todas las rutas de servicio definidas se mantenga dentro del límite de 8,000 caracteres.
API de proxy: los parámetros de ruta del servicio requieren un documento OpenAPI
- Síntoma: La configuración de una ruta de servicio de API proxy con parámetros de ruta (por ejemplo,
/resource/{id}) falla cuando se ingresa manualmente, porque el campo no acepta caracteres de llaves. - Causa posible: Las rutas de servicio definidas manualmente en API proxy no admiten los caracteres
{y}utilizados para definir parámetros de ruta. - Resolución: Para utilizar parámetros de ruta en una ruta de servicio de API proxy, proporcionar un documento OpenAPI que defina las rutas y sus parámetros. API Manager detecta automáticamente las rutas y sus parámetros desde la especificación OpenAPI en lugar de requerir que se ingresen manualmente.
No se puede eliminar una API en API Manager
- Síntoma: La eliminación de una API en API Manager falla: la interfaz muestra un error genérico y la API no se elimina. El error ocurre en el navegador antes de que cualquier solicitud de eliminación llegue al servidor y aparece como un
TypeErrorde JavaScript en la consola del desarrollador del navegador. - Causa posible: El rol del usuario no tiene el permiso de Administrador. La eliminación de una API primero verifica con cuáles Grupos de API está asociada la API, y ver la página Grupos de API requiere el permiso de Administrador: un rol con solo acceso de entorno de Escritura puede abrir la página pero no puede leer su contenido. Cuando el rol no puede leer los grupos de API, esa verificación recibe un valor que la interfaz no puede procesar y la eliminación no se completa.
- Resolución: Hacer que un usuario cuyo rol tenga el permiso de rol de Administrador realice la eliminación. Otorgar al rol afectado el permiso de Administrador también funciona, pero eso es una elevación amplia a nivel de la organización, así que es preferible que un administrador existente elimine la API.
El entorno de API no se puede cambiar después de la creación
- Síntoma: Se creó una API en el entorno incorrecto y necesita moverse, pero el campo de entorno no es editable.
- Causa posible: El entorno se establece en el momento de la creación de la API y no se puede cambiar después.
- Resolución:
- Para mover una API personalizada o proxy a un entorno diferente, clonar la API desde la página de APIs y seleccionar el entorno correcto durante la clonación.
- Como alternativa, exportar la API de su entorno actual e importarla al entorno de destino.
CORS habilitado: las solicitudes OPTIONS se ejecutan sin autenticación
- Síntoma: Después de habilitar CORS en una API personalizada o proxy, el método HTTP
OPTIONSprocesa solicitudes sin autenticación. - Causa posible: Habilitar CORS hace que las operaciones que utilizan el método
OPTIONSse ejecuten sin autenticación. Esto es necesario para admitir solicitudes de verificación previa del navegador, pero significa que cualquier solicitudOPTIONSllega a la operación sin pasar por el perfil de seguridad. - Resolución:
- Si la API no utiliza
OPTIONSpara operaciones sensibles, no se requiere acción. Este es el comportamiento esperado cuando CORS está habilitado. - Si se requiere manejo autenticado de
OPTIONS, deshabilitacr CORS en la API o reestructurar la operación para detectar y manejar explícitamente solicitudes de verificación previa no autenticadas.
- Si la API no utiliza
API de proxy en la nube: la API de destino debe ser públicamente accesible
- Síntoma: Una API proxy que utiliza la puerta de enlace de API en la nube alojada en Jitterbit devuelve errores o no puede alcanzar la API de destino.
- Causa posible: Al utilizar la puerta de enlace de API en la nube, la API que se está siendo proxy debe ser accesible desde internet público. Las API detrás de un firewall o en una red privada no se pueden alcanzar con la puerta de enlace en la nube.
- Resolución:
- Confirma que la API de destino es accesible desde internet público, aunque esté asegurada.
- Si la API de destino debe permanecer detrás de un firewall, implementa una puerta de enlace de API privada en la misma red privada en lugar de utilizar la puerta de enlace de API en la nube.
- Para incluir en la lista de permitidos las direcciones IP de la puerta de enlace en la nube a fin de que la puerta de enlace pueda acceder a la API proxy, consulta Información de la lista de permitidos.
La configuración Mostrar cargas útiles de solicitud y respuesta no tiene efecto en las API de proxy
- Síntoma: El conmutador Mostrar cargas útiles de solicitud y respuesta en registros aparece en la configuración de una API proxy, pero habilitarlo no tiene efecto en la salida de registros.
- Causa posible: El registro de cargas útiles de solicitud y respuesta no se admite para APIs proxy. El conmutador es visible en la interfaz de configuración pero no funciona para este tipo de API.
- Resolución: Para capturar cargas útiles de solicitud y respuesta, utiliza una API personalizada que llame al mismo punto de conexión, donde se admite la configuración Mostrar cargas útiles de solicitud y respuesta en registros.
La puerta de enlace privada devuelve una página 400 "verificar Servicios de Jitterbit" sin entrada de registro de API
-
Síntoma: Las solicitudes a través de una puerta de enlace de API privada fallan intermitentemente con una respuesta HTTP 400. En lugar de una respuesta de API normal, quien realiza la llamada recibe una página de error HTML similar a:
Error connecting to Jitterbit Services. Please verify that all Jitterbit Services are running on your Jitterbit Agent machine - including the Apache server and Process Engine.No aparece ninguna entrada en los registros de API de la solicitud fallida, porque la solicitud nunca llegó a una operación.
-
Causa posible: El grupo de agentes privados está sobrecargado y no tiene hilos de trabajo Apache disponibles para aceptar trabajos de la puerta de enlace de API privada. Cuando no hay hilos disponibles, el intercambio entre puerta de enlace y agente falla con un reinicio de conexión antes de que la solicitud pueda registrarse o ejecutarse.
- Resolución:
- Agrega más agentes al grupo de agentes para distribuir la carga y confirma que los hosts de los agentes tienen suficiente CPU y memoria.
- Monitorea el uso de hilos de trabajo Apache de los agentes. Si la observabilidad nativa está habilitada, revisa los gráficos Apache Thread Capability, Apache idle workers y Apache busy workers (consulta Dashboards) para confirmar si los hilos se están agotando durante las fallas.
- Si los agentes se quedan consistentemente sin hilos de trabajo Apache incluso después de escalar, contacta al soporte de Jitterbit para revisar la capacidad de hilos de trabajo Apache de los agentes (la configuración
MaxRequestWorkers). No cambies los archivos de configuración de Apache de Jitterbit a menos que lo indique el soporte de Jitterbit. Consulta Archivos de configuración de Apache.
Los cambios de perfil de seguridad tardan varios minutos en surtir efecto
- Síntoma: Una API continúa comportándose como si una configuración de perfil de seguridad antigua estuviera activa, incluso después de que se ha actualizado y guardado el perfil.
- Causa posible: Los perfiles de seguridad se almacenan en caché en la puerta de enlace de API. Los cambios en un perfil de seguridad activo no surten efecto inmediatamente.
- Resolución:
- Espera varios minutos después de guardar un cambio de perfil de seguridad antes de probar la API afectada.
- Si el problema persiste después de 10 minutos, confirma que el cambio se guardó correctamente reabriendo el perfil de seguridad.
Eliminar una API no actualiza la documentación del Portal de API
- Síntoma: Después de eliminar una API, su documentación de OpenAPI permanece visible en el Portal de API.
- Causa posible: La documentación del Portal de API no se actualiza automáticamente cuando se elimina una API del Administrador de API.
- Resolución:
- Después de eliminar una API, abre el Administrador de portales y elimina manualmente o actualiza la entrada de documentación de la API allí.
- Alternativamente, usa la pestaña Documentation de la API antes de eliminarla para eliminar primero la entrada del Portal.
No se puede eliminar el perfil de seguridad mientras sigue asignado a una API publicada
- Síntoma: Al intentar eliminar un perfil de seguridad, la operación falla o la opción de eliminación no está disponible, incluso después de desasignar el perfil de una API.
- Causa posible: Después de remover un perfil de seguridad de la configuración de una API, se debe guardar y republicar la API antes de que el perfil se considere completamente desasignado. Hasta que se republique la API, API Manager sigue tratando el perfil como en uso.
- Resolución:
- Después de desasignar el perfil de seguridad de la API, haz clic en Guardar y luego en Publicar la API.
- Una vez que la API se haya republicado con la configuración actualizada, el perfil de seguridad ya no se mostrará como en uso y podrá ser eliminado.
OAuth de 2 patas recurre a 3 patas en versiones de puerta de enlace privada anteriores a 10.48
- Síntoma: Un perfil de seguridad configurado para OAuth de 2 pasos utiliza OAuth de 3 pasos en su lugar cuando se sirve a través de una puerta de enlace de API privada.
- Causa posible: Las puertas de enlace de API privadas anteriores a la versión 10.48 no admiten OAuth de 2 pasos. Si la versión de la puerta de enlace es anterior a 10.48, el perfil de seguridad regresa a OAuth de 3 pasos aunque esté configurado OAuth de 2 pasos.
- Resolución:
- Verifica la versión de la puerta de enlace de API privada que sirve la API.
- Actualiza la puerta de enlace a la versión 10.48 o posterior para habilitar la compatibilidad con OAuth de 2 pasos.
ALB de múltiples puertas de enlace: todos los contenedores deben estar en el mismo host
- Síntoma: En un entorno de múltiples puertas de enlace en contenedores detrás de un equilibrador de carga de aplicaciones (ALB), las llamadas a API fallan intermitentemente o no se pueden recuperar cargas útiles, aunque las puertas de enlace individuales parezcan estar saludables.
- Causa posible: Al utilizar una puerta de enlace de API privada en contenedor con un ALB, todos los contenedores de la puerta de enlace deben ejecutarse en la misma máquina host. Los contenedores implementados en diferentes hosts no pueden coordinar la recuperación de cargas útiles, lo que causa fallos intermitentes.
- Resolución:
- Confirma que todos los contenedores de la puerta de enlace de API privada en el grupo se ejecutan en el mismo host físico o virtual.
- Si los contenedores están distribuidos en múltiples hosts, consolídalos en un único host.
- Para implementaciones de múltiples hosts, revisa la configuración de ALB en la guía de instalación de la puerta de enlace para conocer requisitos de configuración adicionales.
Puerta de enlace privada: la configuración de SSL personalizada se sobrescribe con las actualizaciones
- Síntoma: Después de actualizar una puerta de enlace de API privada, la configuración personalizada de protocolo SSL o cifrado ya no se aplica y la puerta de enlace revierte al comportamiento TLS predeterminado.
- Causa posible: El proceso de actualización de la puerta de enlace de API privada sobrescribe el archivo de configuración local (
/usr/local/openresty/nginx/conf/onpremise.conf). Los cambios manuales en este archivo, incluidas las restricciones personalizadas de protocolo SSL o listas de cifrado, se pierden durante la actualización. - Resolución:
- Antes de actualizar la puerta de enlace de API privada, haz una copia de seguridad del archivo de configuración local.
- Después de que se complete la actualización, vuelve a aplicar la configuración SSL personalizada al nuevo archivo de configuración.
La puerta de enlace privada devuelve HTTP 507 o "No such file or directory"
-
Síntoma: Los extremos de la puerta de enlace privada de API devuelven
507 Insufficient Storage. Los registros de la puerta de enlace muestran:could not open payload file: No such file or directoryincluso cuando hay amplio espacio en disco en los hosts de la puerta de enlace.
-
Causa posible: Aquí,
507significa que la puerta de enlace no pudo abrir el archivo de carga útil o respuesta alojado para la solicitud; no necesariamente significa que el host se haya quedado sin almacenamiento. En una puerta de enlace privada de API de varios nodos detrás de un balanceador de carga, esto puede ocurrir cuando el nodo que sirve una solicitud no puede acceder a un archivo alojado que otro nodo creó, porque esos archivos son locales para cada nodo. -
Solución:
- Confirma que los hosts de la puerta de enlace no se hayan quedado sin almacenamiento verificando el uso de disco e inodos (
df -hydf -i). Libera espacio y prueba de nuevo solo si realmente están llenos. - Si la puerta de enlace se ejecuta como varios nodos detrás de un balanceador de carga, confirma que el balanceador de carga dirija cada solicitud y su respuesta de manera consistente al mismo nodo, porque los archivos de carga útil y respuesta alojados son locales al nodo que los creó. Para puertas de enlace en contenedores, consulta Multi-gateway ALB: All containers must be on the same host.
- Si el error persiste, habilita el registro de seguimiento en la puerta de enlace (establece
traceLogsEnabledentrueen la configuración de la puerta de enlace) y contacta con soporte de Jitterbit con los registros de seguimiento resultantes, los registros de la puerta de enlace (/opt/jitterbit/var/log/api-gateway), los registros de NGINX u OpenResty, y la salida dels -lRpara los directorioshosted-filesen cada nodo. El soporte puede verificar condiciones del servidor que no son configurables por el cliente, como la asignación host a entorno, entradas de dominio privado obsoletas y permisos de archivo.
- Confirma que los hosts de la puerta de enlace no se hayan quedado sin almacenamiento verificando el uso de disco e inodos (
La instalación o actualización de la puerta de enlace privada falla con dependencias faltantes
-
Síntoma: Ejecutar
yum installpara instalar o actualizar una puerta de enlace privada de API Linux (RPM) a la versión 10.62 o posterior falla con errores de dependencias faltantes:Nothing provides geoip-devel needed by jitterbit-api-gateway-11.x.x-x.x86_64 Nothing provides libGeoIP.so.1()(64bit) needed by jitterbit-api-gateway-11.x.x-x.x86_64 -
Causa posible: La puerta de enlace privada de API versión 10.62 y posterior requieren los paquetes
geoip-develylibGeoIP, que proporciona el repositorio EPEL. La instalación documentada habilita EPEL antes de instalar la puerta de enlace. El error ocurre cuando ese paso se omite, o cuando el host de la puerta de enlace no tiene acceso a internet y no puede alcanzar EPEL para descargar los paquetes. -
Solución:
- En un host de la puerta de enlace con acceso a internet, habilita el repositorio EPEL antes de instalar la puerta de enlace, tal como se describe en Install a private API gateway: ejecuta
yum install https://dl.fedoraproject.org/pub/epel/epel-release-latest-8.noarch.rpm, luego vuelve a ejecutar la instalación de la puerta de enlace. - En un host aislado sin acceso a internet, instalar solo el paquete
epel-releaseagrega la definición del repositorio; no descarga los paquetesgeoip-develylibGeoIP. En una máquina con acceso a internet, descarga esos paquetes y sus dependencias transitivas, transfierelos al host de la puerta de enlace e instálalos en orden de dependencia conyum install <package.rpm>antes de volver a ejecutar la instalación de la puerta de enlace.
- En un host de la puerta de enlace con acceso a internet, habilita el repositorio EPEL antes de instalar la puerta de enlace, tal como se describe en Install a private API gateway: ejecuta
La autoprueba de la puerta de enlace privada devuelve "Failure, test call to API failed"
-
Síntoma: La utilidad de autoprueba de línea de comandos de la puerta de enlace privada de API devuelve:
Failure, test call to API failed -
Causa posible: En la versión 11.30 de la puerta de enlace privada de API y anteriores, la utilidad de autoprueba crea una API de prueba que carece de campos obligatorios (Service Name y Path), lo que causa que la llamada de prueba falle.
- Solución:
- Actualiza la puerta de enlace privada de API a la versión 11.31 o posterior, que lo resuelve automáticamente.
- Si no es posible actualizar inmediatamente: abre la configuración de API para la API llamada
ApiGatewayTest, completa el campo Service Name con cualquier valor (por ejemplo,service), establece Path en/, guarda y publica, luego vuelve a ejecutar la utilidad de autoprueba.
OData $count o $inlinecount devuelve un error cuando no hay registros coincidentes
- Síntoma: Una consulta de servicio OData que utiliza las opciones de consulta del sistema
$counto$inlinecountdevuelve un error en lugar de0cuando ningún registro coincide con el filtro. - Posible causa: Por defecto, un servicio OData devuelve un error en lugar de
0cuando una consulta$counto$inlinecountno coincide con ningún registro. - Resolución: En agentes privados que ejecutan la versión 11.32 o posterior, establece el parámetro OData
$noErrorOnZeroCountentrueen la configuración del servicio OData. Esto hace que las consultas$countdevuelvan0en lugar de un error cuando ningún registro coincide.
API de proxy: guiones en encabezados de solicitud reemplazados por guiones bajos
- Síntoma: Una operación de API de proxy recibe encabezados de solicitud con guiones reemplazados por guiones bajos (por ejemplo,
X-Custom-Headerllega comoX_Custom_Header), lo que causa que las búsquedas de encabezados fallen. - Posible causa: Las APIs de proxy tienen una configuración
disable-hyphen-replacementque controla si los guiones en los nombres de encabezados de solicitud se reemplazan con guiones bajos. Para nuevas APIs de proxy, esta configuración predeterminada estrue(reemplazo deshabilitado). Las APIs de proxy más antiguas pueden tenerla establecida enfalse, causando el reemplazo. - Resolución:
- En la configuración de la API de proxy, verifica la configuración del encabezado
disable-hyphen-replacement. Para preservar guiones en los nombres de encabezados, asegúrate de que la configuración seatrue. - Si la API de proxy se creó antes de que se introdujera este valor predeterminado y el reemplazo ocurre inesperadamente, actualiza la configuración a
truey republica la API.
- En la configuración de la API de proxy, verifica la configuración del encabezado
Los registros de operación no son visibles para operaciones activadas por API cuando el modo de depuración está desactivado
- Síntoma: Después de llamar a una API, el registro de API muestra que la llamada se ejecutó correctamente, pero no aparece ningún registro de operación en la página Runtime para la operación que activó la API. Las llamadas a
WriteToOperationLogdesde dentro de la operación tampoco producen entradas de registro visibles. - Posible causa: Cuando una operación se activa a través de una API publicada, las ejecuciones correctas no aparecen en los registros de operación de forma predeterminada. Las operaciones fallidas siempre se registran; solo los registros de operación correctos y cualquier resultado de
WriteToOperationLogde ejecuciones correctas se ocultan. Las ejecuciones correctas aparecen solo cuando Enable debug mode until (una configuración de API Manager) u Operation debug logging (una configuración de agente) está activo. - Resolución:
- Para ver registros de operación correctos y resultados de
WriteToOperationLog, activa Enable debug mode until para la API en la pestaña de configuración de API, o habilita Operation debug logging en el agente. - Para capturar también los datos brutos de solicitud y respuesta y las cargas útiles, activa Enable debug mode until (como en el paso 1), o combina Operation debug logging con Show Request & Response Payloads in Logs y Verbose logging. Los datos que captura cada configuración dependen de la combinación habilitada; para obtener el desglose completo, consulta Datos de solicitud y respuesta de API.
- Desactiva el modo de depuración después de recopilar los registros que necesitas, ya que mantenerlo activado aumenta el volumen de registros.
- Para ver registros de operación correctos y resultados de
Carga útil de API disponible en el agente durante 2 días
- Síntoma: Un flujo de trabajo que recupera una carga útil de solicitud de API del agente más de 2 días después de que se llamó a la API no puede encontrar la carga útil.
- Causa posible: Las cargas útiles de solicitud de API para API personalizadas y servicios OData se almacenan en el agente durante un máximo de 2 días. Después de ese período, la carga útil solo está disponible si la operación ya la escribió en un conector de almacenamiento persistente (como Almacenamiento temporal, Recurso compartido de archivos o una base de datos).
- Resolución:
- Diseña operaciones que consuman cargas útiles de solicitud de API para procesar los datos inmediatamente cuando se llama a la API en lugar de diferir la recuperación de carga útil.
- Si la carga útil debe retenerse para un procesamiento más prolongado, escríbela en una ubicación de almacenamiento persistente en la operación inicial activada por API.
La página de API Logs retiene selecciones de filtros anteriores
- Síntoma: La página de Registros de API no muestra las entradas de registro esperadas aunque la API se ejecute correctamente.
- Causa posible: La página de Registros de API recuerda las selecciones de filtros de la sesión anterior. Un filtro aplicado anteriormente puede estar ocultando los resultados esperados.
- Resolución: En la página de Registros de API, revisa todos los filtros activos y borra cualquiera que pueda estar excluyendo las entradas esperadas.
Las APIs no publicadas no aparecen en el menú desplegable Analytics APIs
- Síntoma: Una API no aparece en el menú desplegable de API en la página de Análiticas, por lo que no se pueden filtrar los datos de análiticas de esa API.
- Causa posible: Solo las API publicadas actualmente aparecen en el menú desplegable de API. Las API que no han sido publicadas se excluyen del menú desplegable incluso si existen registros de API para esas API.
- Resolución:
- Confirma que la API ha sido publicada. Para ver los datos de análiticas, la API debe estar en estado publicado.
- Para ver entradas de registro de una API no publicada, usa la página de Registros de API en su lugar. Los datos de registro permanecen disponibles allí pero no se pueden filtrar por nombre de API.
Error 429: Se superó el límite de llamadas mensuales a la API
- Síntoma: Todas las API de la organización devuelven repentinamente errores HTTP 429.
- Causa posible: La organización ha agotado su subsidio mensual de visitas a API según lo define su licencia. Cuando se supera el subsidio, todas las llamadas de API se rechazan con una respuesta 429 durante el resto del mes.
- Resolución:
- Verifica el recuento actual de visitas con tu subsidio mensual en la página de API. El subsidio se restablece el primer día del mes siguiente.
- Para evitar alcanzar el límite, configura límites de velocidad a nivel de entorno o perfil de seguridad usando la configuración de Visitas por minuto para distribuir la carga e imponer límites de consumo por consumidor.
- Para aumentar el subsidio mensual de tu organización, ponte en contacto con tu Gerente de éxito del cliente.
Error 429: La IP del consumidor no está en el rango de IPs de confianza
- Síntoma: Un consumidor o aplicación específica recibe errores HTTP 429 al llamar a una API, mientras que otros consumidores pueden llamar a la misma API correctamente.
- Causa posible: El perfil de seguridad asignado a la API tiene grupos de IP de confianza configurados. Las solicitudes de direcciones IP fuera de los rangos permitidos se rechazan con una respuesta 429.
- Resolución:
- Abre el perfil de seguridad asignado a la API y revisa su configuración de grupo de IP de confianza.
- Agrega la dirección IP del consumidor o rango de direcciones a un grupo de IP de confianza existente, o crea un nuevo grupo de IP de confianza que incluya las direcciones requeridas.
Límite de velocidad a nivel de plataforma: 200 solicitudes por minuto
- Síntoma: Las APIs alojadas en la puerta de enlace API en la nube administrada por Jitterbit se limitan o se rechaza con una respuesta
429 Too Many Requestsbajo tráfico alto, incluso cuando no se han alcanzado los límites de velocidad del perfil de seguridad. - Causa posible: La puerta de enlace API en la nube administrada por Jitterbit aplica un límite a nivel de plataforma de 200 solicitudes API por minuto por organización, compartido entre todos los tipos de API (personalizadas, proxy y OData). Este límite no se aplica a las puertas de enlace API privadas.
- Resolución:
- Revisa los patrones de tráfico de la API y distribuye las llamadas a lo largo del tiempo si es posible para mantenerse dentro del límite de 200 solicitudes por minuto.
- Si el caso de uso requiere un rendimiento sostenido por encima de este límite, implementa una puerta de enlace API privada donde el rendimiento se determina por la capacidad del servidor host en lugar de un límite a nivel de plataforma.
Zscaler o firewall de intercepción SSL bloquea el acceso a la API
- Síntoma: Las llamadas a API fallan con errores de certificado, o los puntos finales de backend no pueden alcanzar las APIs aseguradas con TLS cuando se enrutan a través de una red Zscaler administrada o similar que inspecciona SSL.
- Causas posibles:
- Zscaler y proxies de seguridad similares realizan inspección SSL/TLS interceptando tráfico HTTPS y volviéndolo a firmar con su propio certificado de CA. Los sistemas cliente que no confían en la CA raíz de Zscaler rechazan la conexión.
- Importar manualmente el certificado de Jitterbit en el almacén de confianza no es una solución confiable: cuando Jitterbit renueva su certificado, la copia importada manualmente queda obsoleta e interrumpe la conexión nuevamente.
- Resolución:
- Instala el certificado de CA raíz de Zscaler en el almacén de confianza del SO o del navegador en los sistemas que realizan las llamadas a API, de modo que los certificados re-firmados por Zscaler sean de confianza.
- Para herramientas como
curl,wgetuopenssl, configúralas para usar el proxy HTTP definido en el entorno de Zscaler. - Solicita una excepción de política de Zscaler para los nombres de host de la puerta de enlace API de Jitterbit para omitir la inspección SSL para esos destinos específicos.
- Revisa las reglas del archivo PAC (proxy auto-configuration) de la organización para confirmar que los puntos finales de Jitterbit se controlan correctamente.
- No importes manualmente el certificado hoja de Jitterbit en un almacén de confianza como solución temporal: usa la CA raíz de Zscaler en su lugar para evitar problemas cuando Jitterbit renueva su certificado.
EDI
Esta sección cubre problemas con la capacidad EDI de Harmony: comunicación con socios comerciales y procesamiento de documentos EDI.
Falla de conexión AS2 o certificado
- Síntoma: Las transmisiones AS2 salientes fallan o no se reciben los reconocimientos del socio comercial.
- Posibles causas:
- El certificado AS2 ha expirado o el socio comercial ya no lo confía.
- El algoritmo del certificado no coincide con lo que requiere el socio comercial (por ejemplo, SHA-1 vs. SHA-256).
- La URL del punto de conexión AS2, el ID del socio u otros parámetros de conexión son incorrectos.
- Un firewall o restricción de red está bloqueando el tráfico AS2 saliente en el puerto 443 o el puerto AS2 configurado.
- Resolución:
- Revisa la configuración de comunicación AS2 del socio comercial afectado y confirma que la URL del punto de conexión, los IDs de socio y la configuración del certificado sean correctos.
- Verifica la fecha de vencimiento del certificado y renuévalo si ha expirado. Intercambia el certificado actualizado con el socio comercial.
- Confirma que el algoritmo del certificado coincida con los requisitos del socio comercial. Actualiza el algoritmo en la configuración AS2 si es necesario.
- Verifica que el firewall de red permita el tráfico saliente hacia el punto de conexión AS2 del socio comercial.
Falla de conexión FTP o SFTP
- Síntoma: Las transmisiones FTP o SFTP hacia o desde un socio comercial fallan, o las transferencias de archivos se cuelgan y agotan el tiempo de espera.
- Posibles causas:
- La dirección del servidor, puerto, credenciales o método de autenticación (contraseña vs. clave SSH) son incorrectos u obsoletos.
- Un firewall o restricción de red está bloqueando el puerto requerido entre Jitterbit EDI y el servidor FTP/SFTP.
- El directorio de destino no existe o la cuenta de servicio carece de permisos de lectura/escritura en él.
- La clave del host ha cambiado en el servidor SFTP, causando una discrepancia.
- Resolución:
- Revisa la configuración de comunicación FTP del socio comercial afectado y verifica todos los parámetros de conexión.
- Confirma que la conectividad a la dirección y puerto del servidor FTP/SFTP está permitida a través de los firewalls relevantes.
- Verifica que la cuenta de servicio tenga los permisos requeridos en el directorio de destino.
- Si utilizas autenticación de clave SSH, confirma que la clave es actual y aceptada por el servidor. Si la clave del host ha cambiado, actualiza la entrada de hosts conocidos.
Problemas de conectividad VAN
- Síntoma: Los documentos EDI no se están entregando ni recibiendo a través de una Red de Valor Agregado (VAN).
- Causa posible: Una conexión VAN es una conexión administrada que Jitterbit configura; no puedes crearla ni configurarla por tu cuenta. Los fallos de entrega generalmente involucran la interconexión VAN, el enrutamiento de buzones o la configuración del socio en el lado del proveedor, en lugar de una configuración de autoservicio en Jitterbit EDI.
- Resolución:
- Confirma que la conexión VAN correcta esté asignada al socio comercial afectado.
- Dado que la conexión VAN no se puede configurar directamente desde Jitterbit EDI, contacta al soporte de Jitterbit o a tu Customer Success Manager para verificar la interconexión VAN y el enrutamiento de documentos.
- Coordina con el proveedor de VAN para confirmar que los identificadores de buzón y el enrutamiento del socio comercial sean correctos en el lado de VAN.
Documento rechazado: datos inválidos o faltantes
- Síntoma: Un documento EDI saliente es rechazado por el socio comercial o falla la validación, o un documento entrante genera un acuse de recibo negativo.
- Posibles causas:
- Falta un segmento o elemento de datos requerido en el documento.
- Un valor de campo excede la longitud permitida, utiliza un tipo de datos incorrecto o contiene caracteres inválidos.
- El indicador de uso del intercambio (
ISA15) está configurado enT(prueba) en lugar deP(producción), por lo que el socio comercial rechaza el documento. - El documento no se ajusta a la guía de implementación del socio comercial.
- Resolución: Revisa la transacción rechazada en la página Transacciones para el segmento o elemento específico citado en el error, luego:
- Para un documento que enviaste, compáralo con la guía de implementación del socio comercial para identificar campos faltantes o no conformes, luego actualiza la asignación EDI y la configuración del tipo de documento afectado para producir resultados conformes.
- Para un documento entrante enviado por el socio comercial, comparte el error de validación con ellos para que corrijan su formato saliente.
Error de mapeo EDI o esquema
- Síntoma: Los documentos EDI se generan con contenido incorrecto, campos faltantes o una estructura inesperada, o los documentos entrantes no se procesan correctamente.
- Posibles causas:
- La asignación o esquema EDI está desactualizado y no refleja la guía de implementación actual o los requisitos del socio comercial.
- Los campos de datos de origen se asignan incorrectamente, produciendo valores incorrectos en el documento de salida.
- Las discrepancias de tipos de datos, caracteres especiales o problemas de codificación en los datos de origen causan fallos en la transformación.
- Resolución:
- Revisa la configuración EDI del socio comercial afectado en Configuración EDI y verifica que la asignación refleje con precisión la guía de implementación actual.
- Valida que los campos de datos de origen se asignen a los segmentos y elementos EDI correctos.
- Verifica los datos de origen para detectar caracteres especiales, problemas de codificación o valores inesperados que puedan estar causando fallos en la transformación y añade pasos de limpieza de datos si es necesario.
- Prueba con un documento de muestra representativo y utiliza el archivo para comparar la salida generada con la estructura esperada.
Identificadores de socio comercial incorrectos
- Síntoma: Los documentos se enrutan incorrectamente, se rechazan a nivel de sobre o no son reconocidos por el socio comercial.
- Posibles causas:
- El ID de EDI del remitente o destinatario, el código calificador u otros identificadores a nivel de sobre no coinciden con lo que espera el socio comercial.
- La configuración del socio comercial se actualizó recientemente pero el cambio no se aplicó en Jitterbit EDI.
- Resolución:
- Revisa la configuración del socio comercial y confirma que el ID de EDI y los códigos calificadores coincidan con los valores especificados en la documentación de configuración del socio comercial.
- Compara los identificadores de sobre en un documento rechazado (visible en el archivo) con los valores esperados.
- Actualiza la configuración del socio comercial si algún identificador es incorrecto, luego reprocesa o reenvía los documentos afectados.
Confirmaciones no configuradas o no recibidas
- Síntoma: Las confirmaciones funcionales esperadas 997 (X12) o CONTRL (EDIFACT) no se están enviando ni recibiendo, o el procesamiento de confirmaciones no funciona como se esperaba.
- Causas posibles:
- La generación o el procesamiento de confirmaciones está deshabilitado en la configuración de EDI del socio comercial.
- El tipo de documento de confirmación no está incluido en la configuración del flujo de trabajo del socio comercial.
- El socio comercial no está enviando confirmaciones, o sus confirmaciones se están enrutando incorrectamente.
- Resolución:
- En la configuración de EDI del socio comercial, confirma que la generación y el procesamiento de confirmaciones estén habilitados para los tipos de documento relevantes.
- Revisa la configuración de administrar flujos de trabajo para confirmar que el tipo de documento de confirmación esté incluido en el flujo de trabajo.
- Consulta el archivo para determinar si las confirmaciones del socio comercial se están recibiendo pero no se están procesando, o si no están llegando en absoluto.
- Si las confirmaciones no están llegando, coordina con el socio comercial para confirmar que las está enviando al punto de conexión correcto.
AS2: El firewall del socio comercial debe incluir en la lista de permitidos las direcciones IP de Jitterbit
- Síntoma: Un socio comercial reporta que no puede recibir tus transmisiones AS2, o sus reconocimientos AS2 nunca llegan, aunque la configuración AS2 saliente parezca correcta.
- Posible causa: El firewall del socio comercial requiere una lista de permitidos explícita para el tráfico entrante y no ha añadido las direcciones IP de Jitterbit EDI.
-
Resolución:
-
Proporciona las siguientes direcciones IP de Jitterbit EDI a tu socio comercial y solicita que las permita para el tráfico AS2 entrante y saliente:
- América del Norte:
40.71.22.62 - EMEA y APAC:
20.166.31.85
- América del Norte:
-
Para tu URL de recepción AS2 entrante y la dirección IP correspondiente que debes proporcionar a los socios comerciales, consulta la página de configuración de comunicación AS2 de tu región.
-
La verificación de duplicados no se aplica al formato EDIXml o XCBL
- Síntoma: Se están procesando múltiples veces documentos inbound duplicados aunque la configuración Duplicate Transaction Check esté habilitada en la conexión AS2 del socio comercial.
- Causa posible: La Duplicate Transaction Check se aplica solo a documentos en formato EDI. No filtra duplicados para los formatos de intercambio EDIXml o XCBL.
- Resolución: Si se requiere filtrado de duplicados para flujos de trabajo EDIXml o XCBL, implementa lógica de deduplicación en la operación de Studio que procesa los documentos inbound (por ejemplo, verificando un ID de transacción contra un registro de base de datos o Cloud Datastore antes de procesarlo).
La actividad EDI for Cloud v2 falla en un agente privado detrás de un firewall o proxy
- Síntoma: En un agente privado, una actividad EDI for Cloud v2 como Get Document no puede recuperar datos (por ejemplo, con un error "Unable to fetch data"), aunque la prueba de conexión sea exitosa y el mismo proyecto funcione en un grupo de agentes en la nube.
- Causa posible: El agente privado está detrás de un firewall o proxy que bloquea el acceso saliente al servicio Jitterbit eiCloud EDI en
eicloudservice.com. El conector EDI for Cloud v2 llama a este servicio (por ejemplo, en*.transactionapi.eicloudservice.com) para recuperar datos, por lo que bloquearlo causa que la actividad falle. Los agentes en la nube no se ven afectados. - Resolución:
- Agrega a la lista de permitidos
eicloudservice.comy sus subdominios para acceso saliente en la red, firewall y proxy del agente privado. Para los otros dominios de Jitterbit e direcciones IP que un agente privado necesita para acceso saliente, consulta Información de lista de permitidos. - Si se está utilizando un proxy, confirma que esté configurado correctamente en el agente privado y que no esté interfiriendo con la conexión.
- Agrega a la lista de permitidos
El token de acceso EDI desactivado causa error INVALID_TOKEN
-
Síntoma: Las operaciones que utilizan el conector EDI for Cloud v2 fallan con:
Error opening connection. Exception is: Error code: INVALID_TOKEN -
Causa posible: El token de acceso utilizado por la conexión EDI for Cloud v2 ha sido configurado como Inactive en la página Access Tokens de la Management Console.
- Resolución: En la página Access Tokens, localiza el token y establece su Status en Active.
Error de transformación: campo no reconocido en actividad EDI
-
Síntoma: Una transformación que utiliza una actividad EDI for Cloud v2 (como List Transactions) falla con un error de análisis JSON que hace referencia a un nombre de campo no reconocido, por ejemplo:
Unrecognized field "user_defined_field_1" -
Posible causa: La versión del conector EDI for Cloud v2 instalado en el agente está desactualizada. El servicio EDI de backend devuelve un campo (como
user_defined_field_1) que la versión anterior del conector no reconoce, por lo que el conector no puede analizar la respuesta. -
Resolución: Actualiza el conector EDI for Cloud v2 en el agente a la versión más reciente, siguiendo Confirmar disponibilidad del conector y mantenerlo actualizado en la guía de solución de problemas del conector. Al hacer clic en Test Connection en la conexión EDI for Cloud v2, se descarga la versión más reciente del conector al agente; si la política de organización Disable Auto Connector Update está habilitada, actualiza el conector del grupo de agentes desde la página Agentes de la Consola de administración.
El segmento EDI repetido o mapa de bucle mapea solo la última iteración
- Síntoma: En una transformación de Studio, un segmento o bucle repetido en un documento EDI manejado a través del conector EDI for Cloud v2 mapea solo su última ocurrencia (las iteraciones anteriores se descartan), porque la cardinalidad del nodo en el esquema de actividad del conector es de ocurrencia única (por ejemplo,
(0,1)) en lugar de repetida ((1,many)). Esto afecta tanto a X12 (por ejemplo, un segmentoN9anidado dentro de un bucleLXen un 945) como a EDIFACT (por ejemplo, un grupoCNIrepetido en un IFCSUM). - Posible causa: El esquema generado automáticamente proporcionado por el conector EDI for Cloud v2 no refleja la cardinalidad correcta para el segmento o bucle afectado. El documento sin procesar en el almacén de EDI Transactions contiene todas las iteraciones, y un esquema construido manualmente a partir de ese XML sin procesar las mapea correctamente, lo que confirma el esquema de respuesta del conector (no los datos) como la causa.
- Resolución:
- Abre la conexión EDI for Cloud v2 en Studio y actualiza los metadatos para verificar si se ha publicado una corrección de esquema.
- Si la cardinalidad sigue siendo incorrecta después de actualizar, exporta el esquema, actualiza manualmente el atributo
maxOccursen el segmento afectado en un editor XML externo y vuelve a importarlo como un XSD personalizado.
Adición de niveles de bucles jerárquicos anidados (HL) a una transformación EDI
- Síntoma: Al construir una transformación de Studio para un conjunto de transacciones EDI que utiliza bucles jerárquicos (por ejemplo, X12 870 4010VICS, que está estructurado de manera similar al 856), el esquema de la actividad Send Document del conector EDI for Cloud v2 muestra un único nivel HL, pero el documento que necesitas producir requiere niveles HL anidados (por ejemplo, un nivel de orden HL-O con un nivel de artículo secundario HL-I).
- Posible causa: Los documentos jerárquicos pueden anidar niveles HL a profundidades variables, por lo que el esquema del conector expone un único nivel HL que replicas en la transformación para construir los niveles adicionales que tu documento requiere.
- Resolución:
- En el árbol de esquema de destino de la transformación, haz clic derecho en el nodo HL existente y selecciona Duplicate node para agregar el nivel HL anidado (por ejemplo, un nivel secundario HL-I bajo HL-O).
- Mapea el nodo duplicado a tus datos de origen. Agrega una condición en el nodo duplicado si debe crearse en la salida solo bajo circunstancias específicas.
Los valores de invalidación de ID de EDI no se aplican a transacciones salientes
- Síntoma: Las transacciones salientes utilizan los ID de EDI del remitente o receptor predeterminados de la configuración del socio comercial en lugar de los ID de anulación preferidos configurados en la configuración de ID de EDI.
- Causa posible: Las anulaciones de ID de EDI no se aplican automáticamente. Los ID preferidos deben asignarse explícitamente en la transformación de solicitud de la operación de Studio que envía el documento saliente mediante el conector EDI for Cloud v2.
- Resolución: En esa transformación de solicitud, asigna valores a estos campos para aplicar los ID preferidos (consulta la página Configuración de ID de EDI para conocer los valores exactos a utilizar):
ISA05_ID_Qualifier: calificador de ID del remitenteISA06_Sender_ID: ID de EDI del remitenteISA07_ID_Qualifier: calificador de ID del receptorISA08_Receiver_ID: ID de EDI del receptor
No se puede eliminar una conexión de comunicación asignada
- Síntoma: El intento de eliminar una conexión AS2 o FTP en la Configuración de comunicaciones falla o la opción de eliminar no está disponible.
- Causa posible: No se pueden eliminar las conexiones asignadas. Una conexión que está asignada actualmente a un socio comercial debe desasignarse antes de poder eliminarse.
- Resolución:
- En Configuración de comunicaciones, selecciona el socio comercial que utiliza la conexión y asigna una conexión diferente a ese socio.
- Una vez que ningún socio esté utilizando la conexión, la opción de eliminar estará disponible.
El "Próximo tiempo de ejecución" de FTP no se actualiza sin actualizar la página
- Síntoma: La Hora de la próxima ejecución que se muestra en la configuración de comunicaciones FTP de un socio comercial permanece obsoleta después de que se haya ejecutado el trabajo FTP programado, aunque el cronograma funcione correctamente.
- Causa posible: La interfaz de usuario actualiza el estado de los trabajos programados solo cuando se carga la página o cuando una acción manual activa una recarga de datos. No consulta el motor en tiempo real.
- Resolución:
- Actualiza la página del navegador para actualizar la visualización de Hora de la próxima ejecución.
- Alternativamente, navega fuera de la configuración de FTP y vuelve para forzar una recarga.
Falla de adición de ID de EDI o ID preferido: ID ya en uso
-
Síntoma: La adición de un ID de EDI o un ID preferido a un socio comercial falla, incluso cuando el ID no parece estar en uso en el entorno actual. Se muestra uno de los siguientes mensajes:
No se puede agregar el ID de EDI [ID] porque está actualmente en uso; confirme y proporcione un ID único.No se puede agregar el ID preferido [ID] porque está actualmente en uso; confirme y proporcione un ID único. -
Posibles causas:
- Cada ID de EDI debe ser único en todos los entornos de Harmony donde esté habilitado Jitterbit EDI. Si el mismo ID ya está asignado a un socio comercial en un entorno diferente, la adición falla.
- Un ID preferido debe ser único dentro del entorno. Se rechaza si ya está asignado al mismo socio comercial o a otro socio comercial en el mismo entorno.
-
Resolución:
- Para un ID de EDI duplicado, verifique todos los demás entornos de Harmony donde esté habilitado EDI para confirmar si el ID ya está asignado allí. Trabaje con su socio comercial para establecer un ID de EDI único para cada entorno donde intercambie documentos, y use un ID distinto para entornos que no sean de producción que difiera de su ID de EDI de producción.
- Para un ID preferido duplicado, consulte la lista de ID preferido (ID de ISA) del socio comercial actual y de otros socios comerciales en el mismo entorno, luego elija un ID único.
Los documentos salientes pasan validación local pero fallan en pruebas del socio comercial
- Síntoma: Los documentos EDI salientes pasan la verificación de validación local en Jitterbit EDI pero se rechazan durante las pruebas o certificación del socio comercial, a menudo con errores sobre elementos faltantes o no conformes.
- Posibles causas:
- La validación saliente está deshabilitada en la configuración del flujo de trabajo. Jitterbit EDI permite que se generen documentos sin validación, pero sin ella, los documentos pueden carecer de elementos requeridos por la guía de implementación del socio comercial.
- La configuración de EDI cubre los elementos esenciales del estándar, pero la guía de implementación del socio comercial puede requerir elementos obligatorios adicionales que no se aplican en la configuración predeterminada.
- Resolución:
- En la configuración de administrar flujos de trabajo, habilite la validación para el flujo de trabajo saliente.
- Revise la guía de implementación del socio comercial para identificar cualquier elemento obligatorio más allá de la configuración estándar de EDI y agréguelos al mapeo.
- A menos que tenga un conocimiento profundo de la transacción EDI específica y los requisitos del socio comercial, siempre habilite la validación antes de realizar pruebas con un socio comercial.
Transacción archivada antes o después de lo esperado
- Síntoma: Una transacción se archiva antes de que finalice el período de retención esperado, o permanece disponible más tiempo del esperado.
- Posible causa: Las transacciones se archivan según la fecha posterior de dos fechas: la fecha de la transacción y la fecha del documento. Si la fecha del documento es más reciente que la fecha de la transacción, el archivado se calcula a partir de la fecha del documento, lo que puede extender el período de retención.
- Resolución:
- Al investigar el tiempo de archivado inesperado, verifique tanto la fecha de la transacción como la fecha del documento de la transacción afectada.
- Revise la configuración del período de retención para confirmar el número de días configurado (30, 60 o 90).
No se puede acceder a funciones EDI
- Síntoma: Un usuario no puede ver o interactuar con páginas de EDI, o ciertas acciones de EDI no están disponibles.
- Posibles causas:
- El acceso a EDI requiere tanto un permiso de rol específico de EDI (Admin, EDI User o EDI Viewer) como un rol de acceso al entorno de nivel Write. La falta de cualquiera de los dos impide el acceso.
- Los roles EDI User y EDI Viewer difieren en lo que permiten. EDI Viewer puede reprocesar transacciones, reenviar confirmaciones y leer páginas, pero no puede crear o actualizar configuraciones ni cargar archivos. Crear o actualizar configuraciones y cargar archivos para procesamiento requiere el rol EDI User. Las acciones administrativas, como archivar transacciones, habilitar PII y cambiar la configuración de purga, requieren el rol Admin.
- Resolución:
- En la Consola de administración, verifique que el usuario tenga un rol que incluya el permiso Admin, EDI User o EDI Viewer.
- Confirme que el nivel de acceso del entorno del usuario incluya acceso de Write para el entorno donde esté configurado EDI.
- Si el usuario necesita realizar operaciones de escritura (como crear socios comerciales o cargar documentos), asigne el rol EDI User en lugar de EDI Viewer. Consulte Permisos de EDI para la matriz de permisos completa.
No se pueden habilitar configuraciones de PII
- Síntoma: La opción para habilitar los ajustes de PII (información de identificación personal) para un socio comercial no está disponible o aparece deshabilitada.
- Causa posible: Habilitar los ajustes de PII requiere el permiso de Admin permission. Ni el rol de EDI User ni el de EDI Viewer pueden habilitar los ajustes de PII.
- Resolución:
- Confirma que el rol del usuario incluya el permiso de Admin, no solo EDI User o EDI Viewer.
- Si el usuario necesita administrar los ajustes de PII regularmente, actualiza su asignación de rol en consecuencia.
Desarrollo de aplicaciones
Esta sección cubre problemas con la capacidad de desarrollo de aplicaciones de Harmony: crear, implementar y ejecutar aplicaciones en App Builder.
App Builder falla al iniciar con un error 500
- Síntoma: App Builder no inicia en IIS y devuelve un error HTTP 500.
- Causa posible: El paquete de hospedaje de ASP.NET Core Runtime que requiere App Builder no está instalado en el servidor Windows, por lo que IIS no puede iniciar la aplicación.
- Resolución:
- Instalar el paquete de hospedaje de ASP.NET Core Runtime requerido por App Builder, como se indica en los Requisitos del sistema.
- Reiniciar IIS y verificar que App Builder se cargue correctamente.
App Builder falla al iniciar con un error HTTP 500.30
-
Síntoma: App Builder no inicia y devuelve:
HTTP Error 500.30 - ASP.NET Core app failed to start -
Causa posible: La identidad del grupo de aplicaciones de IIS no tiene acceso completo a la carpeta raíz de App Builder, por lo que la aplicación no puede iniciar.
-
Resolución:
- Otorgar a la identidad del grupo de aplicaciones de App Builder (por defecto,
IIS AppPool\Vinyl) Control total de la carpeta raíz de App Builder. Ver Establecer permisos. - Reiniciar el grupo de aplicaciones, luego recargar App Builder.
- Otorgar a la identidad del grupo de aplicaciones de App Builder (por defecto,
App Builder devuelve un error HTTP 503
-
Síntoma: Abrir App Builder devuelve:
HTTP Error 503. The service is unavailable. -
Causa posible: El grupo de aplicaciones de IIS para App Builder está detenido.
-
Resolución:
- Abrir Administrador de IIS y seleccionar Grupos de aplicaciones.
- Seleccionar el grupo de aplicaciones de App Builder (por defecto,
Vinyl), luego seleccionar Iniciar.
Nota
Si el grupo de aplicaciones se detiene nuevamente inmediatamente después de iniciar, es probable que App Builder esté fallando al iniciar. Revise los registros de la aplicación y el Visor de eventos de Windows para el error subyacente.
App Builder se inicia pero no crea bases de datos
- Síntoma: App Builder inicia correctamente pero no se crean bases de datos en el SQL Server.
- Causa posible: El archivo de conexión tiene una extensión incorrecta (por ejemplo,
.txten lugar de.xml). - Resolución: Localice el archivo de conexión de App Builder y confirme que use la extensión
.xml. Cambie el nombre del archivo si la extensión es incorrecta, luego reinicie App Builder. Si App Builder inicia pero devuelve un error de conexión en lugar de crear silenciosamente ninguna base de datos, consulte Ocurre un error al cargar la información de conexión de la base de datos.
Ocurre un error al cargar la información de conexión de la base de datos
-
Síntoma: App Builder devuelve el siguiente error:
An error occurred while attempting to load the database connection information. -
Causa posible: El archivo
Connection.xmlestá ausente o contiene datos de conexión incorrectos. -
Resolución:
- Reemplace o actualice
Connection.xmlcon los datos de conexión correctos, luego reinicie App Builder. Consulte Crear un archivo de conexión. - Si App Builder inicia sin un error pero no crea bases de datos, consulte App Builder inicia pero no crea bases de datos.
- Reemplace o actualice
App Builder se carga con estilos faltantes o rotos
- Síntoma: App Builder inicia, pero las páginas se renderizan con estilos faltantes o rotos (CSS).
- Causa posible: El archivo ZIP de instalación no fue desbloqueado antes de ser extraído. Windows marca los archivos descargados de otra computadora como bloqueados (la "marca de la web"), y extraer un archivo comprimido que aún está bloqueado propaga esa marca a los archivos extraídos, lo que puede impedir que los activos de estilo de App Builder se carguen correctamente.
- Resolución:
- Eliminar los archivos extraídos.
- Desbloquear el archivo ZIP original: haz clic derecho sobre él, selecciona Propiedades, abre la pestaña Seguridad y selecciona Desbloquear. Consulta Obtener y descomprimir el software.
- Extraer el ZIP nuevamente, luego reiniciar la instalación o actualización.
La carga de licencia falla
-
Síntoma: La carga de un archivo de licencia falla con uno de los siguientes errores:
An unknown error occurred.405 POST Method not allowedFailed to deserialize license (d3fc6d4e835e) -
Causa posible: WebDAV está instalado o habilitado en IIS y puede interferir con la solicitud POST utilizada para cargar la licencia.
- Resolución:
- Desinstalar o deshabilitar el módulo WebDAV en IIS.
- Reintentar la carga de la licencia.
- Si WebDAV es necesario para otras aplicaciones en el servidor, contactar a soporte de Jitterbit para obtener orientación sobre cómo configurar ambos servicios para coexistir.
App Builder no se inicia automáticamente después de reiniciar el servidor
- Síntoma: El App Builder no se vuelve disponible automáticamente después de que el servidor de Windows se reinicia, requiriendo una primera solicitud manual para inicializar la aplicación.
- Resolución: Para los pasos de resolución, consulta Solucionar el comportamiento de inicio automático.
Implementación de Docker: No se puede cargar la licencia de App Builder 4.x en la interfaz de usuario
- Síntoma: Después de actualizar de Vinyl 3.3 a App Builder 4.x en Docker, la carga de la licencia de App Builder a través de la interfaz de usuario de App Builder falla o la opción no está disponible.
- Causa posible: Las implementaciones de Docker de App Builder 4.x no soportan la carga de licencias a través de la interfaz de usuario.
- Resolución: Proporciona la licencia a través de uno de los siguientes métodos:
- En el archivo
docker-compose.yml, establece la variable de entornoLicense__LicenseKeycon la clave de licencia de App Builder 4.x codificada en base64. - Agrega la clave de licencia al archivo
appsettings.jsonen el subdirectoriodatadel directorio de Docker compose.
- En el archivo
Alta disponibilidad: Todas las instancias deben usar el mismo appsettings.json
- Síntoma: En una implementación de alta disponibilidad, algunos nodos de App Builder se comportan de manera diferente a otros (por ejemplo, la autenticación funciona en algunos nodos pero no en otros, o las claves de cifrado de datos son inconsistentes entre nodos).
- Causa posible: Cada instancia de App Builder en una implementación de alta disponibilidad debe usar un archivo de configuración
appsettings.jsonidéntico. Si los archivos difieren entre instancias, el comportamiento será inconsistente entre nodos. - Resolución:
- Confirma que todas las instancias de App Builder en la implementación de HA tengan archivos
appsettings.jsonidénticos. - Después de cambiar la configuración en una instancia, aplica el mismo cambio a todas las demás instancias y reinicia cada una.
- Confirma que todas las instancias de App Builder en la implementación de HA tengan archivos
El inicio de sesión de SSO falla o redirige a una URL incorrecta
- Síntoma: Los usuarios que intentan iniciar sesión a través de inicio de sesión único (SSO) encuentran un error de redirección o son enviados a una URL inesperada.
- Causas posibles:
- La URI de redirección configurada en el Proveedor de Identidad (IdP) no coincide con la URL que está utilizando App Builder.
- Un proxy inverso o balanceador de carga frente a App Builder (por ejemplo, IIS detrás de un F5) termina TLS, por lo que App Builder ve
httpmientras que la URL pública utilizahttps. La URI de redirección entonces utiliza el protocolo incorrecto y no coincide con el valor registrado en el IdP. - La URL de integración SSO en App Builder hace referencia a una dirección obsoleta o incorrecta.
- El proveedor de seguridad OpenID Connect en App Builder está mal configurado.
- Resolución:
- En el IdP (por ejemplo, Okta o Azure AD), confirma que la URI de redirección coincide exactamente con la URL de la aplicación de App Builder, incluyendo el protocolo (
https://) y cualquier ruta. - En App Builder, revisa la configuración del proveedor de seguridad en IDE > Proveedores de Seguridad y verifica que la configuración de OpenID Connect coincida con los valores esperados por el IdP.
- Si la URL de App Builder ha cambiado (por ejemplo, después de una migración o actualización de dominio), actualiza la URI de redirección tanto en App Builder como en el IdP.
- En el IdP (por ejemplo, Okta o Azure AD), confirma que la URI de redirección coincide exactamente con la URL de la aplicación de App Builder, incluyendo el protocolo (
La URL base no redirige a la página de inicio de sesión
- Síntoma: Abrir la URL base de un entorno de App Builder (por ejemplo,
https://example.com/) no redirige a la página de inicio de sesión. Los visitantes no autenticados son llevados directamente a una aplicación en su lugar. - Causa posible: El usuario
anonymousincorporado tiene acceso a la página de inicio de una aplicación. App Builder redirige automáticamente a cada usuario a una página de inicio a la que pueden acceder, por lo que cuando el usuarioanonymouspuede acceder a la página de inicio de una aplicación, todos los visitantes no autenticados son redirigidos allí en lugar de a la página de inicio de sesión. - Resolución: Eliminar el acceso del usuario
anonymousa la página de inicio de la aplicación para que los visitantes no autenticados sean dirigidos a la página de inicio de sesión.
Los usuarios locales no pueden restablecer una contraseña olvidada
- Síntoma: Los usuarios locales no pueden restablecer una contraseña olvidada. El enlace Olvidé mi contraseña en la pantalla de inicio de sesión falta o no completa el restablecimiento.
- Causa posible: Al grupo de Usuarios anónimos no se le ha otorgado acceso a la aplicación de restablecimiento de contraseña, por lo que los usuarios no autenticados no pueden acceder al flujo de trabajo de restablecimiento de contraseña.
- Resolución: Otorgar al grupo de Usuarios anónimos acceso a la aplicación App Builder - Restablecimiento de contraseña y agregarlo al rol de Restablecimiento de contraseña. Consulte Restablecimiento de contraseña para los pasos completos de configuración, incluido el ajuste de SMTP requerido.
App Builder es lento o no responde
- Síntoma: El App Builder responde lentamente a las interacciones del usuario, o las cargas de página y las consultas se agotan.
- Causas posibles:
- El servidor de App Builder tiene recursos de CPU o memoria insuficientes para la carga actual.
- Un problema de red entre el usuario y el servidor de App Builder, como un ancho de banda limitado, pérdida de paquetes o un firewall, está ralentizando la transmisión de datos.
- Consultas o lógica de aplicación no optimizadas están produciendo páginas lentas, o un servicio en segundo plano está consumiendo recursos excesivos.
- El proceso de trabajo de IIS ha entrado en un estado no saludable.
- Una operación de larga duración superó el tiempo de espera de un proxy, balanceador de carga u otro dispositivo de red entre el navegador y App Builder, lo que desconectó el navegador. El navegador informa un error como
504 Gateway Timeout, pero la operación sigue ejecutándose en el servidor y puede tener éxito o fallar después de que el navegador se desconecte.
- Resolución:
- Revisar la utilización de recursos del servidor (CPU, memoria, disco I/O) para identificar cualquier saturación de recursos.
- Para descartar un problema de red, conectarse desde una red diferente (por ejemplo, otra red Wi-Fi o un dispositivo móvil en una conexión celular) y realizar una prueba de velocidad de internet. Si el rendimiento mejora en otra red, la causa probablemente sea un ancho de banda limitado, un problema con el ISP o un firewall, en lugar del App Builder en sí.
- Revisar los registros de la aplicación en busca de errores recurrentes, tiempos de espera o advertencias que puedan indicar la causa.
- Si el navegador informó un tiempo de espera de puerta de enlace, usar el historial de eventos para determinar si la operación finalizó en el servidor antes de volver a intentarlo. Dado que la operación sigue ejecutándose después de que el navegador se desconecta, volver a intentarlo puede duplicar el trabajo.
- Revisar los servicios en segundo plano activos y el historial de eventos en busca de trabajos de larga duración o atascados. Para identificar consultas SQL lentas específicamente, ver Capturar y analizar consultas lentas.
- Para páginas lentas causadas por consultas o lógica de aplicación no optimizadas, ver Optimización del rendimiento del App Builder para orientación sobre optimización de consultas, indexación y diseño de aplicaciones.
- Si el servidor parece saludable pero el App Builder sigue sin responder, reciclar el grupo de aplicaciones de IIS para App Builder.
- Si el problema es intermitente y difícil de diagnosticar, recuperar un volcado de proceso para un análisis más detallado. Ver Recuperar un archivo de volcado.
La autenticación OAuth de Salesforce falla o autentica con la instancia incorrecta
- Síntoma: Los usuarios que inician sesión con SSO de Salesforce son autenticados inesperadamente con la instancia incorrecta de Salesforce, o los tokens de Salesforce dejan de funcionar y se solicita a los usuarios que se reautenticen repetidamente.
- Causas posibles:
- Múltiples instancias de App Builder comparten la misma Aplicación Conectada de Salesforce. Salesforce retiene solo los cuatro tokens de actualización más recientes por Aplicación Conectada. Cuando se emite un quinto token, el más antiguo se invalida, lo que provoca que la instancia que tiene ese token pierda la autenticación.
- Múltiples instancias de Salesforce están configuradas en App Builder, y el navegador del usuario ya tiene una sesión activa con una instancia de Salesforce. Cuando el usuario intenta iniciar sesión en una segunda instancia, Salesforce reutiliza la sesión existente y registra al usuario en la primera instancia en su lugar.
- Resolución:
- Asignar una Aplicación Conectada de Salesforce separada a cada instancia de App Builder para evitar conflictos de tokens de actualización. Consulte la documentación del proveedor de seguridad de Salesforce para obtener detalles de configuración.
- Si un usuario se está autenticando con la instancia incorrecta de Salesforce, pídale que cierre sesión de todas las sesiones activas de Salesforce en su navegador antes de intentar iniciar sesión nuevamente.
Los valores de columna cifrada aparecen en blanco después de reconfigurar la fuente de datos
- Síntoma: Los valores almacenados en una columna encriptada aparecen en blanco (nulos) en la aplicación después de que se eliminó y recreó una fuente de datos, tabla o columna, o después de actualizar o migrar el entorno de App Builder.
- Causas posibles:
- App Builder deriva la clave de encriptación de cada columna de los valores
DataSourceId,TableIdyColumnIden su modelo lógico. Si alguno de estos identificadores cambia (por ejemplo, después de eliminar y recrear una fuente de datos, tabla o columna), los valores encriptados existentes ya no pueden ser desencriptados. No se muestra ningún error: el valor aparece silenciosamente como nulo. - Durante una actualización o migración, la carpeta
keysde la instalación anterior no se copió a la nueva carpeta de instalación, por lo que App Builder no puede acceder al material de clave necesario para desencriptar los valores existentes.
- App Builder deriva la clave de encriptación de cada columna de los valores
- Resolución:
- Si los valores encriptados aparecen en blanco después de una actualización o migración, confirme que el contenido de la carpeta
keysse copió de la carpeta de instalación anterior a la nueva. Consulte el paso 5 de Restaurar configuraciones. - Para prevenir la pérdida de datos por cambios en los identificadores, evite eliminar y recrear fuentes de datos, tablas o columnas encriptadas que contengan datos. Para una lista completa de limitaciones de encriptación, consulte Encriptación de columnas a nivel de aplicación.
- Antes de realizar cambios estructurales, exporte o haga una copia de seguridad de cualquier valor de columna encriptada.
- Si los identificadores ya han cambiado y los datos no pueden ser recuperados de una copia de seguridad, contacte a soporte de Jitterbit con detalles de la configuración original.
- Si los valores encriptados aparecen en blanco después de una actualización o migración, confirme que el contenido de la carpeta
El registro de auditoría no se completa la línea base
- Síntoma: Llenar la Línea Base Completa de Auditoría genera un error y la línea base no se crea.
- Causa posible: La tabla no tiene una clave primaria UUID de una sola parte. La Auditoría Completa requiere un UUID único para cada registro, por lo que las tablas con una clave primaria compuesta (de múltiples partes) no se auditan por defecto. Para auditar tal tabla, primero se debe agregar una columna de auditoría UUID.
- Resolución:
- Agregar una columna UUID a la tabla y establecer su tipo de uso de columna en Auditoría, luego llenarla para los registros existentes. Para el procedimiento completo, ver Otras configuraciones de clave primaria.
- Navegar a Cajón de Acción > IDE > Configuración Adicional y hacer clic en el botón Llenar Registros de Auditoría.
- Localizar la fuente de datos de la aplicación, hacer clic en Llenar Todo (o Llenar en tablas individuales), luego hacer clic en Proceder para reintentar.
Nota
Full Audit no falla en columnas grandes o binarias. Los valores de cadena que superan los 700 caracteres se auditan pero se truncarán más allá de los 700 caracteres, y las columnas binarias se auditan por tamaño de archivo en lugar de por contenido.
Sistema de archivos de SharePoint: Autenticación OAuth requerida a partir de abril de 2026
- Síntoma: Las conexiones del SharePoint File System no logran autenticarse o no se pueden crear.
- Causa posible: A partir del 30 de abril de 2026, las conexiones del SharePoint File System requieren autenticación OAuth. Las conexiones que utilizan autenticación heredada ya no funcionan.
- Resolución:
- Actualizar a App Builder 4.61 o posterior.
- Seguir la guía de conexión OAuth de Microsoft SharePoint para configurar un proveedor de seguridad OAuth antes de crear o actualizar el servidor de datos.
Sistema de archivos de SharePoint: Los archivos no se muestran o las rutas devuelven errores
- Síntoma: Una fuente de datos del SharePoint File System se conecta correctamente, pero los archivos no se muestran, el contenido no se renderiza o una ruta de directorio causa un error.
- Causas posibles:
- App Builder solo puede acceder a los archivos almacenados en el directorio Documentos. Los archivos en otros directorios de SharePoint no son accesibles.
- Los nombres de archivo son sensibles a mayúsculas y minúsculas al enlazar entre fuentes de datos. Un desajuste en el uso de mayúsculas entre el nombre del archivo de SharePoint y el nombre utilizado en otra fuente de datos impide que el contenido se renderice.
- Usar una barra diagonal (
/) en una ruta de directorio en un objeto de negocio causa un error.
- Resolución:
- Confirmar que los archivos estén almacenados en el directorio Documentos en SharePoint.
- Verificar que los nombres de archivo utilizados en objetos de negocio y enlaces de fuentes de datos coincidan exactamente con el uso de mayúsculas de los nombres de archivo de SharePoint.
- Al especificar una ruta de directorio en un objeto de negocio, usar barras invertidas (
\\) en lugar de barras diagonales (/). Por ejemplo, usar\documents\employeesen lugar de/documents/employees.
Conector de App Builder: No se puede recuperar la clave API generada después de salir de la pantalla
- Síntoma: Un usuario del conector ha configurado el Conector de App Builder pero el valor de la clave API ya no está disponible después de navegar fuera de la pantalla de generación de claves.
- Causa posible: La clave API generada se muestra solo una vez en la pantalla de Generar clave. Una vez que se abandona la pantalla, el valor no se puede recuperar.
- Resolución:
- Copie el valor de la clave en el portapapeles inmediatamente después de que se genere, antes de navegar fuera.
- Si la clave no fue copiada, genere una nueva clave.
Conector de App Builder: Error 403 Prohibido
- Síntoma: Conectarse a un entorno remoto de App Builder utilizando el Conector de App Builder devuelve un error 403 Prohibido.
- Causa posible: La cuenta de usuario configurada para el conector no ha recibido el rol de Conector Remoto de App Builder en el entorno de App Builder de origen.
- Resolución:
- En el entorno de App Builder de origen, abra la cuenta de usuario utilizada por el conector.
- Asigne el rol de Conector Remoto de App Builder a ese usuario.
Webhook: La autenticación HTTP básica requiere el encabezado Authorization en la carga útil
- Síntoma: Un webhook configurado para usar HTTP Básica no procesa correctamente las cargas útiles entrantes.
- Causa posible: El método de HTTP Básica requiere que el encabezado
Authorizationesté presente en la carga útil recibida. Los sistemas de terceros que omiten este encabezado no se autentican correctamente. - Resolución: Utilice el método de autenticación Clave API para el proveedor de seguridad del webhook en lugar de HTTP Básica. El método de Clave API no requiere el encabezado
Authorizationy es más compatible con los remitentes de webhook externos.
La migración de fechas agota el tiempo en conjuntos de datos grandes
- Síntoma: Una operación de migración de fechas no se completa y falla con un error de tiempo de espera.
- Causa posible: Las migraciones de fechas se ejecutan como una única transacción de base de datos durante una actualización de la aplicación o fuente de datos. Con conjuntos de datos grandes, la transacción puede exceder el tiempo de espera de comando predeterminado de la base de datos.
- Resolución: En el archivo
Connection.xmlde App Builder, aumenta el valor deCommandTimeOutpara permitir más tiempo para que la transacción de migración se complete.
El servidor de aplicaciones de App Builder y el servidor de base de datos deben usar la misma zona horaria
- Síntoma: Los valores de DateTime en la aplicación están desplazados por compensaciones inesperadas, o los tiempos mostrados en App Builder difieren de lo que se muestra en la base de datos.
- Causa posible: El servidor de aplicaciones de App Builder y el servidor de base de datos están configurados con diferentes zonas horarias. Estos servidores deben estar sincronizados para que los valores de DateTime se representen correctamente.
- Resolución:
- Confirma que el servidor de aplicaciones de App Builder y todos los servidores de base de datos estén configurados en la misma zona horaria.
- En App Builder, establece la Zona Horaria de Fuente de Datos Predeterminada en cada servidor de fuente de datos y la Zona Horaria en cada fuente de datos para que coincida con la zona horaria del servidor de base de datos. Consulta Zonas horarias para los pasos de configuración.
Errores de configuración de SMTP
-
Síntoma: App Builder no puede enviar notificaciones por correo electrónico, y los registros de la aplicación o la salida de Correo Electrónico de Prueba muestran uno de los siguientes errores:
Argument passed in is not serializable. Parameter name: valueValue cannot be null. ParameterName: From AddressUnknown URI scheme. Parameter name: uriAuthentication required -
Causas posibles:
- El campo From Address del servidor de notificaciones SMTP está vacío, nulo o utiliza una dirección de correo electrónico no válida (produce los dos primeros errores anteriores).
- El campo URI utiliza un formato no válido o un esquema no soportado (produce el error "Esquema URI desconocido"). El URI debe usar el esquema
smtp://osmtps://, por ejemplosmtp://mail.ejemplo.com:587. - Los campos UserName o Password contienen credenciales incorrectas (produce el error "Se requiere autenticación").
-
Resolución: En el IDE, desde las opciones de Connect abre Notification Servers, luego abre el registro del servidor SMTP y verifica el campo que coincide con el error que recibiste:
- Verifica que el From Address sea una dirección de correo electrónico válida permitida para enviar correos a través del host SMTP configurado.
- Verifica que el URI use el formato
smtp://<hostname>:<port>osmtps://<hostname>:<port>. Consulta Configurar SMTP para los protocolos y formatos soportados. - Verifica que el UserName y Password coincidan con las credenciales del servidor SMTP.
- Después de realizar un cambio, utiliza la función Test Email en la ventana emergente del servidor de notificaciones para confirmar la configuración antes de implementarlas en un flujo de trabajo.
Los enlaces profundos dejan de funcionar después de renombrar una aplicación o página
- Síntoma: Un enlace profundo que anteriormente dirigía a los usuarios a una aplicación o página específica ya no funciona.
- Causa posible: Renombrar una aplicación o página en App Builder cambia la ruta de URL utilizada en los enlaces profundos. Cualquier enlace existente que contenga el antiguo nombre de la aplicación o página ya no es válido.
- Resolución:
- Actualizar cualquier sistema externo, correos electrónicos, portales o marcadores que contengan la antigua URL de enlace profundo para usar el nuevo nombre de la aplicación o página.
- Construir el nuevo enlace profundo navegando a la página de destino en App Builder y copiando la URL de la barra de direcciones del navegador, luego eliminar la cadena de consulta (todo lo que está desde
?en adelante) para obtener la URL canónica. - Para evitar este problema en el futuro, utilizar el campo Etiqueta para nombres de visualización y mantener el campo Nombre (que determina la ruta de URL) corto y estable.
Un evento se ejecuta varias veces en guardar, insertar, actualizar o eliminar
- Síntoma: Un evento que debería activarse una vez se activa múltiples veces en la misma acción del usuario, resultando en registros duplicados, notificaciones duplicadas u otros efectos secundarios repetidos.
- Causas posibles:
- La acción o validación del evento está registrada tanto en la capa de datos como en la capa de lógica de negocio simultáneamente. App Builder permite esta configuración, pero activa el evento una vez por registro de capa.
- La vinculación de la acción está sin vincular o está vinculada a más de un registro. La acción se activa una vez por cada registro en el ámbito.
- Resolución: Abrir el Taller de Aplicaciones, localizar la configuración del evento, luego abordar la causa que aplique:
- Determinar si la lógica pertenece a la capa de datos (para comportamiento a nivel de tabla) o a la capa de lógica de negocio (para comportamiento específico de la página). Ver Configurar eventos para orientación, y eliminar el registro duplicado de la capa a la que no pertenece.
- Revisar la vinculación de la acción. Si está sin vincular o vinculada a más de un registro, limitarla al único registro previsto. Ver Vinculación implícita y explícita.
El usuario no puede acceder a las páginas o funciones esperadas
- Síntoma: Un control de ícono HTML en una página no respeta los permisos de rol de un usuario. Por ejemplo, un ícono que debería estar deshabilitado para usuarios sin permiso permanece activo.
- Causa posible: Los íconos HTML se comportan como botones. Sin un evento adjunto, los permisos basados en roles no se aplican al ícono, por lo que permanece visible y activo independientemente del rol del usuario.
- Resolución:
- Adjuntar un evento vacío al control de ícono HTML para que se aplique la visibilidad basada en roles.
- Especificar el acceso apropiado (por ejemplo, Actualizar) en el rol para los usuarios que deberían ver el ícono.
El icono de auditoría no aparece en una página
- Síntoma: El botón o ícono de Auditoría utilizado para ver los registros de Auditoría Completa no es visible en un panel de Formulario o Cuadrícula.
- Causas posibles:
- El usuario no pertenece al rol de App Builder - Administradores o al rol de App Builder - Auditoría.
- El panel de la página no tiene habilitado Mostrar Auditoría, o el panel no es un panel de Formulario o Cuadrícula.
- Resolución:
- Confirmar que el usuario pertenece al rol de App Builder - Administradores o al rol de App Builder - Auditoría. Ver Seguridad.
- En un panel de Formulario o Cuadrícula, habilitar Mostrar Auditoría para el panel de la página. Ver Habilitar auditoría completa en una página.
Aplicación sin conexión: La base de datos local se borra cuando se actualiza la aplicación
- Síntoma: Después de que se actualiza una aplicación fuera de línea, todos los datos almacenados localmente en el dispositivo móvil desaparecen.
- Causa posible: La base de datos local de una aplicación fuera de línea se borra cada vez que se actualiza la aplicación. Esta es una limitación conocida de las aplicaciones fuera de línea.
- Resolución:
- Asegúrate de que todos los datos recopilados localmente estén completamente sincronizados con el servidor antes de que se implemente una actualización de la aplicación.
- Informa a los usuarios sobre las actualizaciones planificadas con anticipación para que puedan sincronizarse antes de que la actualización entre en efecto.
Aplicación sin conexión: Los programas en segundo plano no se ejecutan cuando la aplicación está cerrada
- Síntoma: Las tareas programadas o los procesos en segundo plano en una aplicación fuera de línea no se están ejecutando en un dispositivo móvil cuando se espera.
- Causa posible: Los horarios en segundo plano no se ejecutan cuando la aplicación de App Builder está cerrada en el dispositivo móvil. Los horarios solo se ejecutan mientras la aplicación está abierta.
- Resolución:
- Informa a los usuarios que el procesamiento programado en segundo plano requiere que la aplicación permanezca abierta.
- Rediseña los flujos de trabajo que dependen de horarios en segundo plano para que se activen con la interacción del usuario, o mueve el procesamiento programado al lado del servidor.
La aplicación móvil se congela, falla o tiene problemas de enlaces
Para resolver problemas con la aplicación móvil App Builder, consulta Solución de problemas de aplicación móvil.
El widget no se activa o no carga correctamente
Para resolver problemas de configuración de widgets y archivos zip, consulta Solución de problemas de widgets.