Eine Datei in einzelne Datensätze mit SCOPE_CHUNK in Jitterbit Studio aufteilen
Einführung
Dieses Designmuster kann verwendet werden, um die Daten in einer Datei mit mehreren Datensätzen in mehrere Dateien aufzuteilen, von denen jede einen einzelnen Datensatz enthält. Dazu wird die SCOPE_CHUNK-Präfixsyntax der Set-Funktion verwendet.
Tipp
Dieses Muster wird empfohlen, wenn die Quelldaten flach (nicht hierarchisch) sind und der Vorgang keine Transformation mit bedingter Logik enthält. Für komplexe (hierarchische) Quelldaten siehe Eine Datei in einzelne Datensätze mit SourceInstanceCount aufteilen.
Anwendungsfall
In diesem Szenario enthält die Quelle mehrere Datensätze, und der Geschäftsprozess oder der Zielendpunkt erfordert, dass Datensätze einzeln verarbeitet werden.
Designmuster
Dieses Designmuster besteht darin, die Datei mit einem Vorgang zu lesen, bei dem die Transformation das gleiche Quell- und Zielschema verwendet. Dieses Muster hat diese Hauptmerkmale:
- Im ersten Feld der Transformation, die die Daten verarbeitet, wird die
Set-Funktion verwendet, um eine Variable zu setzen, die mitSCOPE_CHUNKbeginnt, gefolgt von zusätzlichem Text zur Konstruktion des Variablennamens. Das erste Argument erstellt den Namen der Ausgabedatei, typischerweise unter Verwendung einer Datensatzkennung aus den Quelldaten. Die Dateinamen müssen eindeutig sein, um nicht überschrieben zu werden. Daher kann ein Datensatzzähler oder eine GUID als Teil des Dateinamens verwendet werden. - Ein Dateispeicherziel wie Temporary Storage oder Local Storage muss verwendet werden. (Die Verwendung einer Variable wird nicht unterstützt.) Das Definieren eines Pfads wird empfohlen. Der Dateiname sollte mit dem globalen Variablennamen konfiguriert werden, der in der
Set-Funktion verwendet wird. - Die Vorgangsoptionen müssen mit aktiviertem Enable Chunking konfiguriert werden, mit einer Chunk Size von
1, Number of Records per File von1und Max Number of Threads von1. - Zur Laufzeit wird jeder Datensatz gelesen, erhält einen eindeutigen Dateinamen und wird einzeln in das Ziel geschrieben.
Nach Verwendung dieses Musters besteht der nächste Schritt normalerweise darin, die FileList-Funktion zu verwenden, um das Array der Dateinamen im Verzeichnis zu erhalten (konfigurieren Sie die Read-Aktivität des Dateiverzeichnisses mit dem Platzhalter *), dann durchlaufen Sie das Array und lesen jede Datei in die Quelle für den nächsten Vorgang.
Beispiele
Beispiele für die oben beschriebene Verwendung des Designmusters werden für zwei verschiedene Arten von Quelldaten bereitgestellt: eine flache CSV-Datei und eine hierarchische JSON-Datei.
Flache CSV
Diese Beispiel-Operationskette wendet das oben beschriebene Designmuster an, um flache CSV-Daten in eine Datei pro Datensatz aufzuteilen. Jede Nummer entspricht einer Beschreibung des Operationsschritts unten. Weitere Details finden Sie in den Screenshots für das Hierarchische JSON-Beispiel.
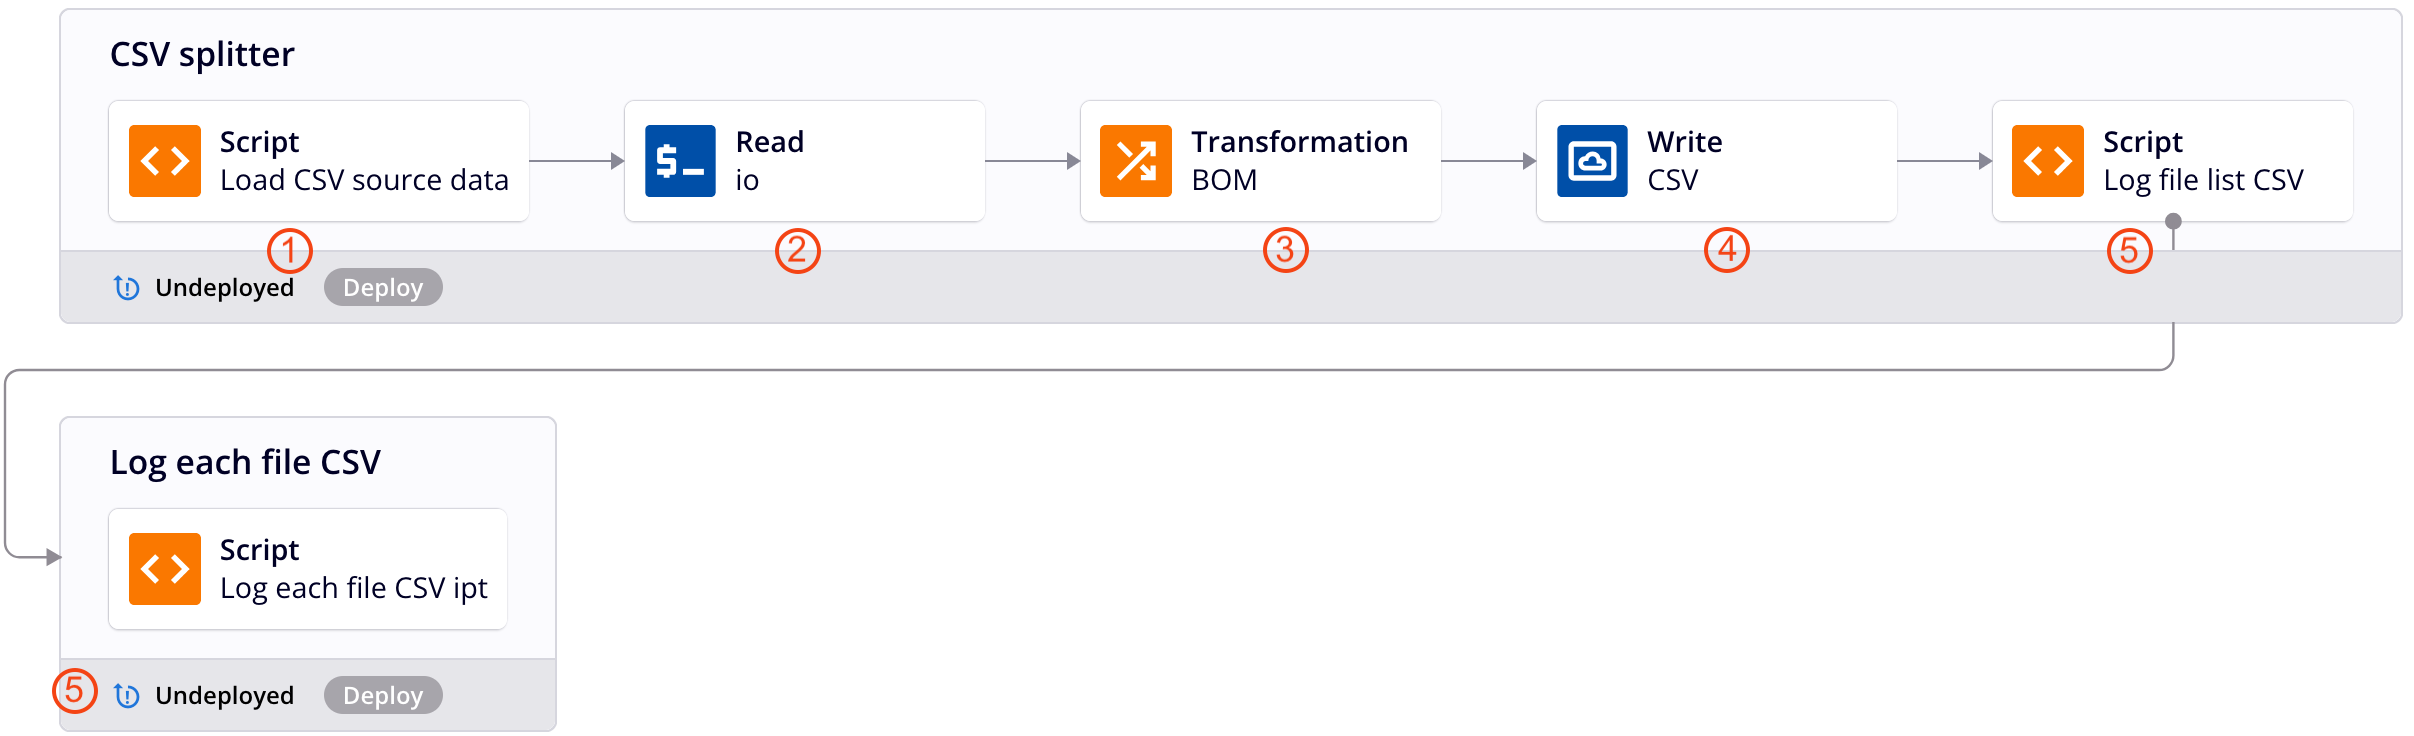
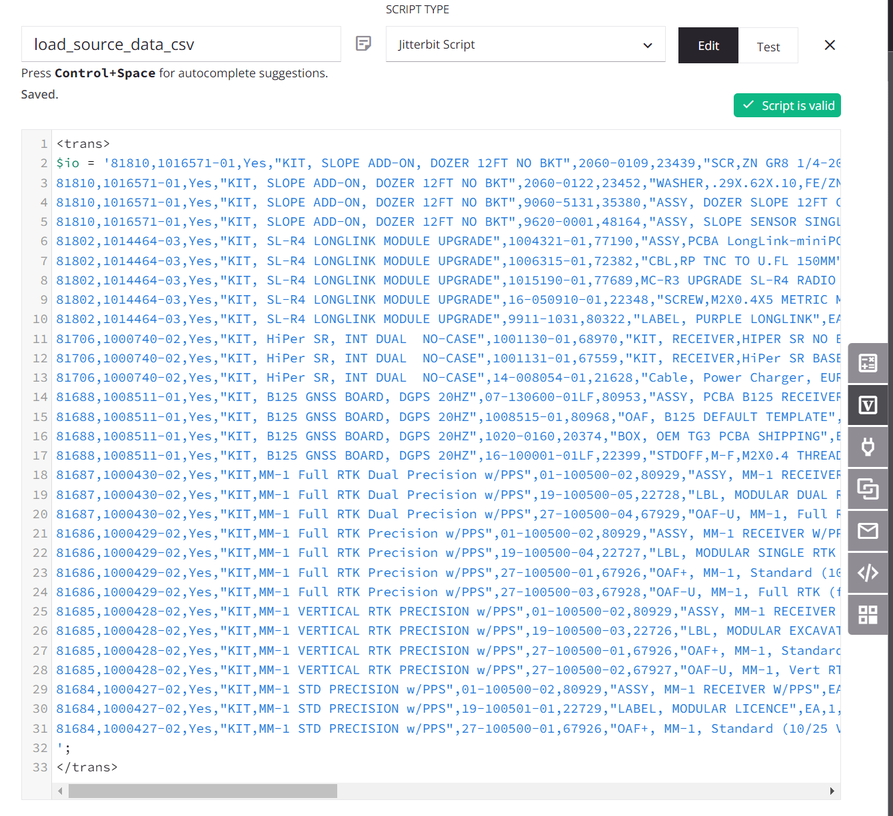
- Das Skript weist die Quelldaten einer globalen Variablen namens
io(input/output) zu. (Ein Skript wird zu Demonstrationszwecken verwendet; die Quelldaten könnten auch von einem konfigurierten Endpunkt stammen.)
-
Die globale Variable
iowird verwendet, um einen Variable-Endpunkt zu konfigurieren, und eine zugehörige Variable Read-Aktivität wird von der Operation als Quelle der Transformation verwendet. -
Innerhalb der Transformation verwenden Quelle und Ziele das gleiche Schema, und alle Felder werden zugeordnet. Das erste Datenfeld im Zuordnungsskript der Transformation ist so konfiguriert, dass es
SCOPE_CHUNKverwendet. DieSet-Funktion wird verwendet, um eine Variable zu erstellen, die mit dem AusdruckSCOPE_CHUNKbeginnt und mit der eindeutigen Datensatz-ID aus der Quelle sowie einem Datensatzzähler und einem Suffix von.csvverkettet wird: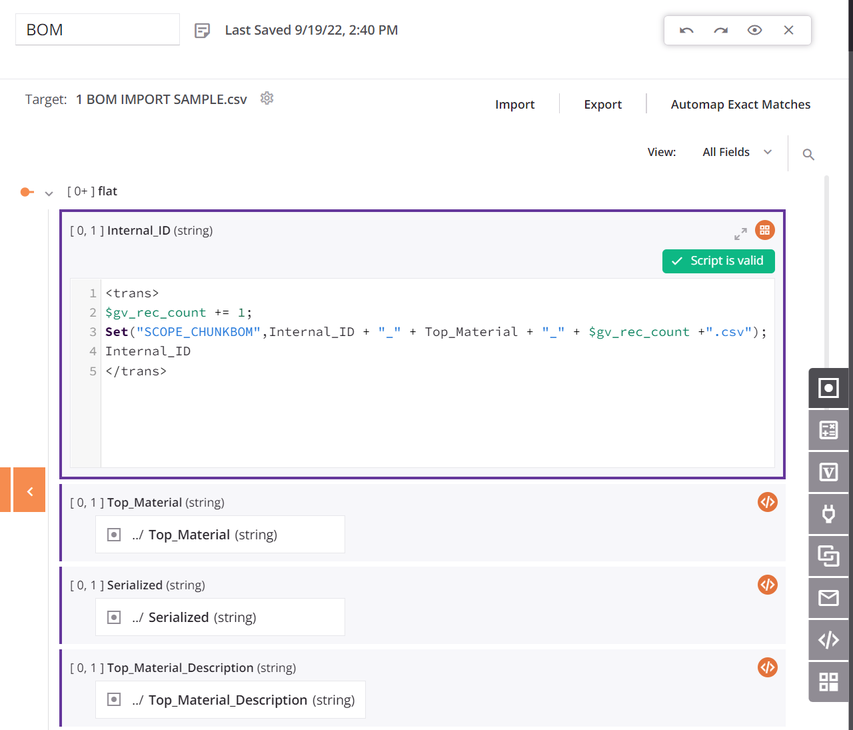
-
Das Ziel ist eine Temporary Storage Write-Aktivität, die mit einem Standardpfad und der zuvor definierten Dateiname-Globalvariablen konfiguriert ist.
-
Die Skripte dienen der Protokollierung der Ausgabe und sind optional. Das erste Skript ruft eine Liste der Dateien aus dem Verzeichnis ab und durchläuft die Liste, protokolliert den Dateinamen und die Größe und übergibt dann den Dateinamen an eine Operation mit einem anderen Skript, das den Dateiinhalt protokolliert. (Siehe die Screenshots für das Hierarchical JSON-Beispiel oben.)
-
Die Operationsoptionen müssen mit Enable Chunking konfiguriert werden, mit einer Chunk Size von
1, Number of Records per File von1und Max Number of Threads von1.
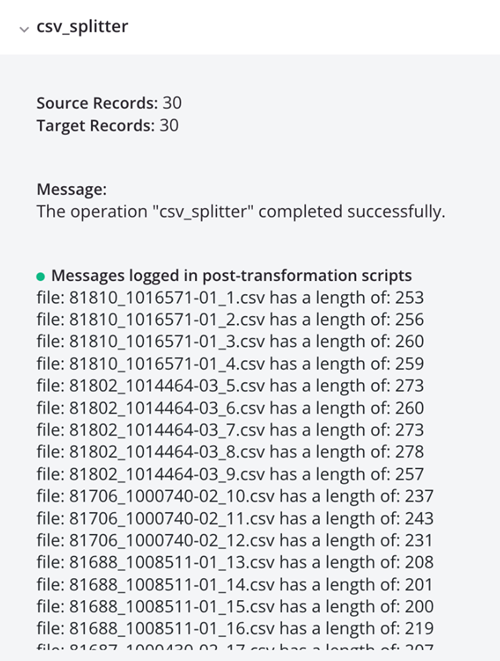
Das Ausführen der Operation ergibt einzelne CSV-Datensätze, wie in der Protokollausgabe gezeigt:
Hierarchical JSON
Diese Beispieloperationskette wendet das oben beschriebene Designmuster an, um hierarchische JSON-Daten in eine Datei pro Datensatz aufzuteilen. Jede Nummer entspricht einer Beschreibung des Operationsschritts unten.
Hinweis
Dieses Designmuster ist nicht mehr die empfohlene Methode zum Aufteilen hierarchischer JSON-Daten. Die empfohlene Methode finden Sie unter Split a file into individual records using SourceInstanceCount.
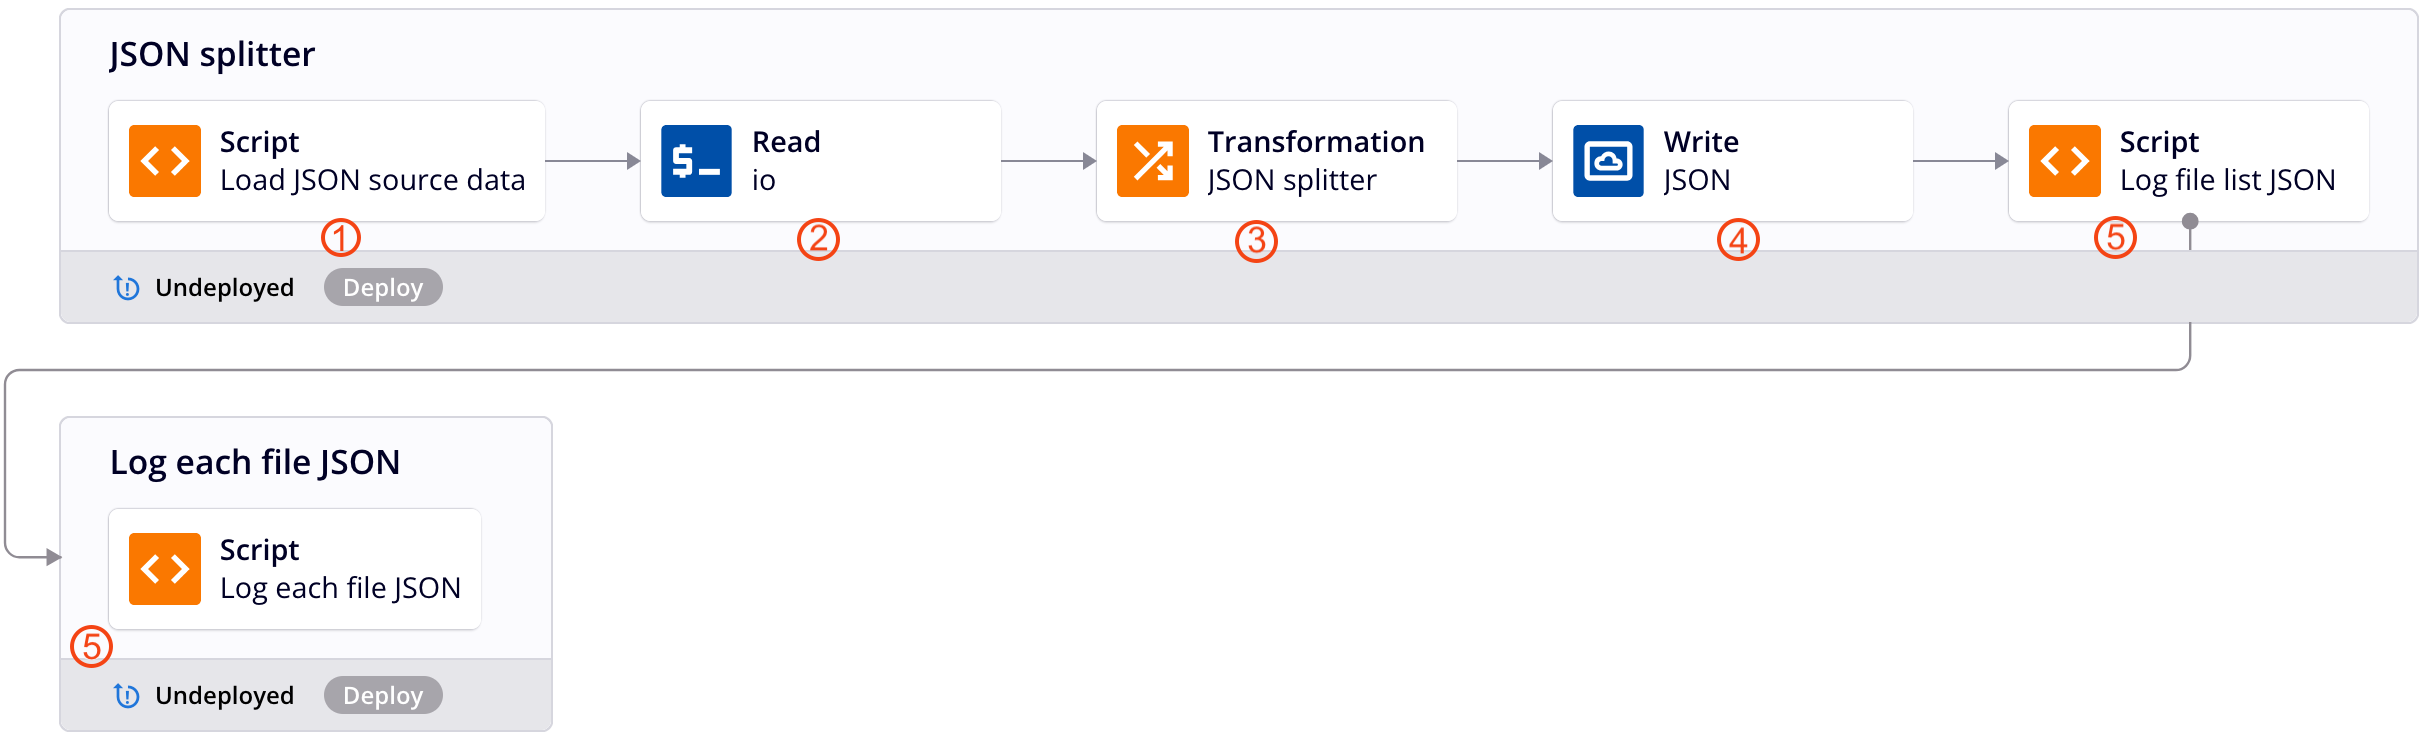
-
Das Skript weist die Quelldaten einer globalen Variablen namens
io(input/output) zu. (Ein Skript wird zu Demonstrationszwecken verwendet; die Quelldaten könnten auch von einem konfigurierten Endpunkt stammen.)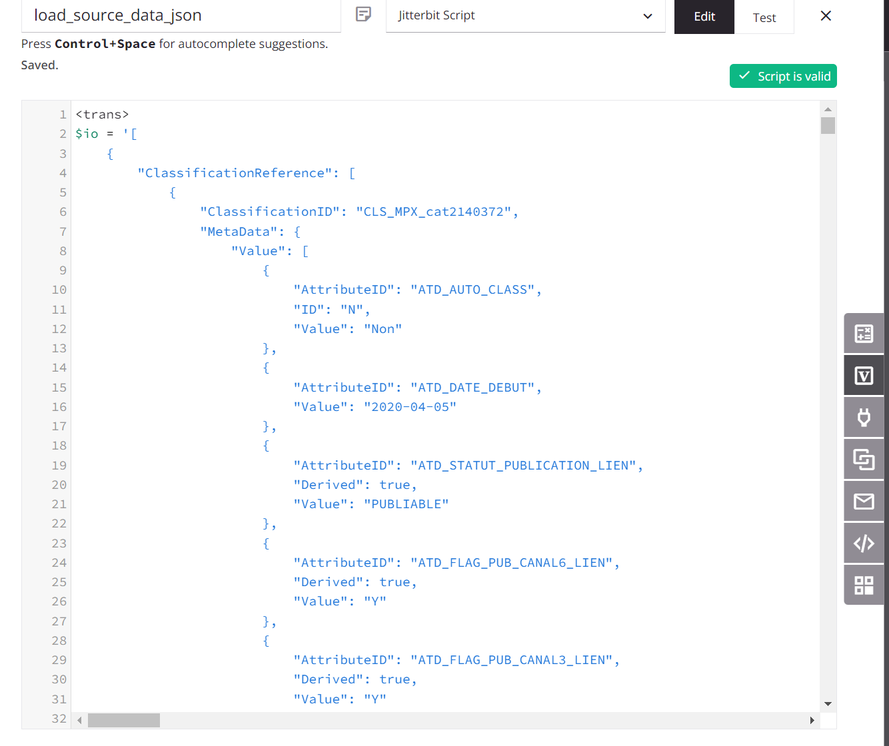
-
Die globale Variable
iowird verwendet, um einen Variable-Endpunkt zu konfigurieren, und eine zugehörige Variable Read-Aktivität wird von der Operation als Quelle der Transformation verwendet: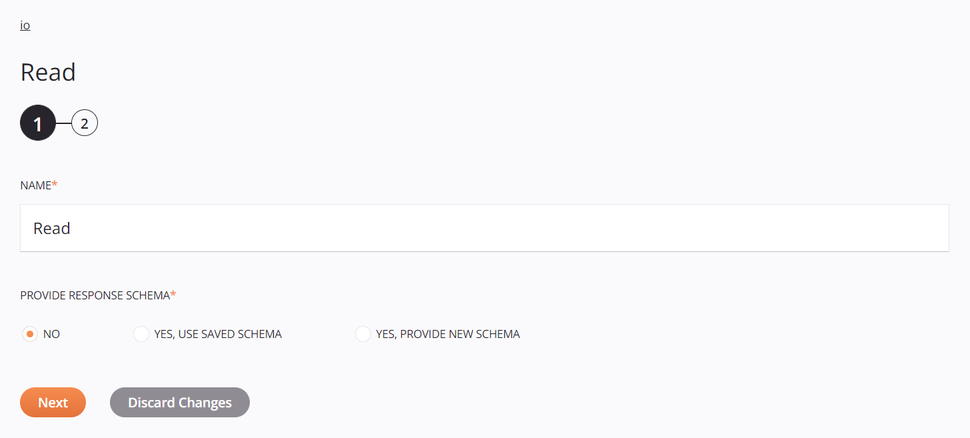
-
Innerhalb der Transformation verwenden Quelle und Ziel das gleiche Schema, und alle Felder werden zugeordnet:
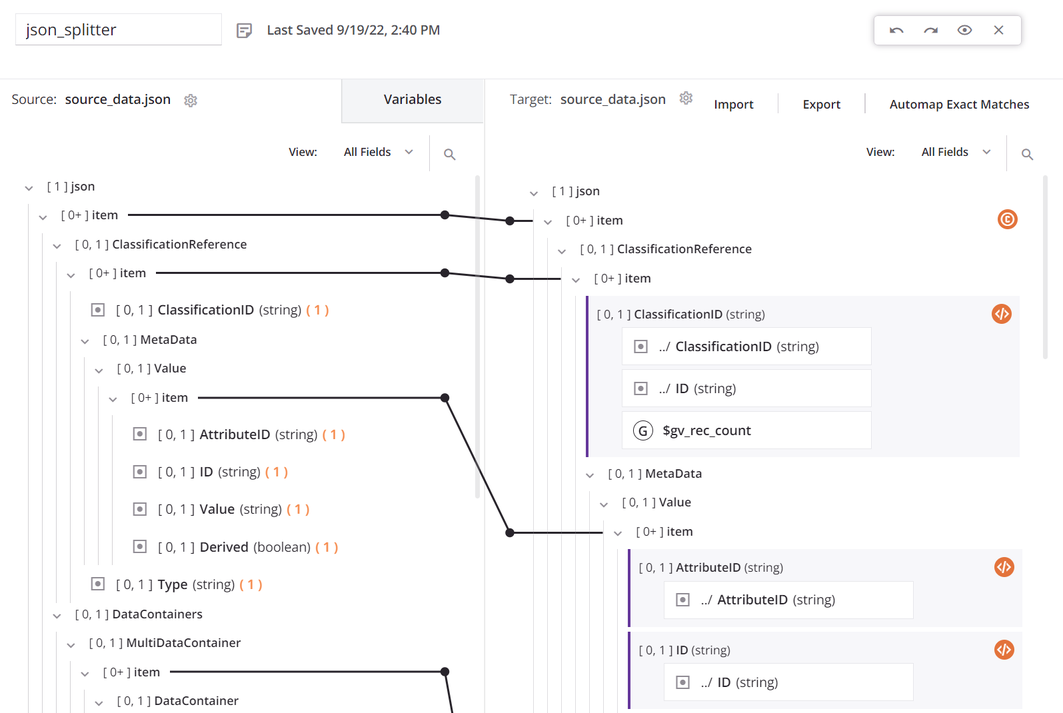
Der oberste
item-Knoten hat eine Bedingung, um die Datensatzanzahl zu generieren. Das erste Datenfeld in der Transformationszuordnung ist so konfiguriert, dass esSCOPE_CHUNKverwendet. DieSet-Funktion wird verwendet, um eine Variable zu erstellen, die mit dem AusdruckSCOPE_CHUNKbeginnt und mit der eindeutigen Datensatz-ID aus der Quelle sowie einem Datensatzzähler und einem Suffix von.jsonverkettet wird: -
Das Ziel ist eine Temporary Storage Write-Aktivität, die mit einem Standardpfad und der zuvor definierten Dateiname-Globalvariablen konfiguriert ist:
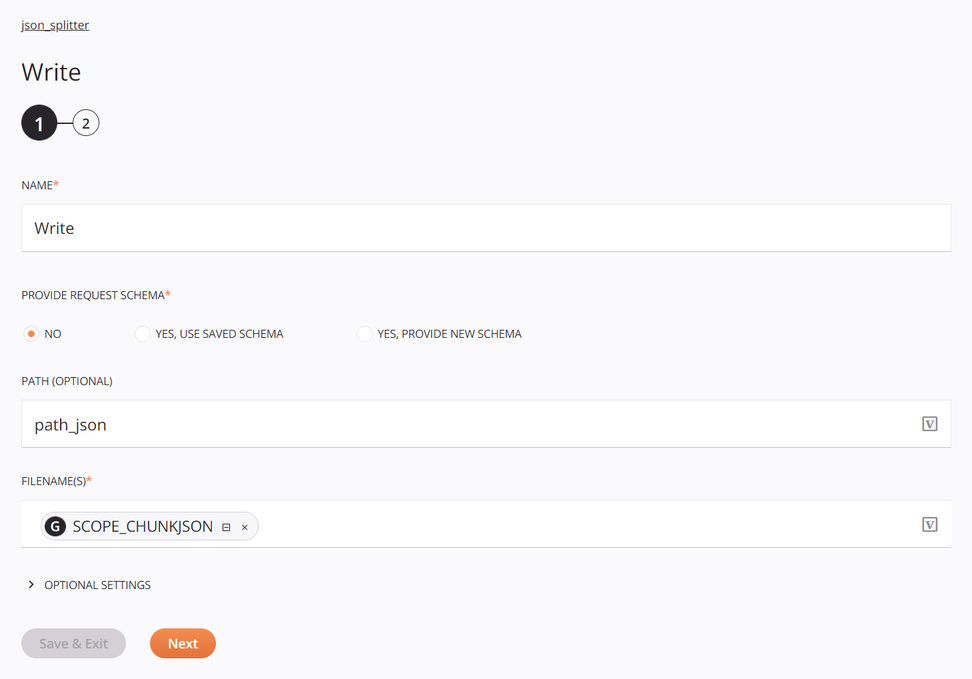
-
Die Skripte dienen der Protokollierung der Ausgabe und sind optional. Das erste Skript ruft eine Liste der Dateien aus dem Verzeichnis ab und durchläuft die Liste, protokolliert den Dateinamen und die Größe und übergibt dann den Dateinamen an einen Vorgang mit einem anderen Skript, das den Dateiinhalt protokolliert:
log_file_list_json<trans> arr = Array(); arr = FileList("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>"); cnt = Length(arr); i = 0; While(i < cnt, filename = arr[i]; file = ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",filename); WriteToOperationLog("file: " + filename + " has a length of: " + Length(file)); $gv_file_filter = filename; RunOperation("<TAG>operation:log_each_file_json</TAG>"); i++ ); </trans>log_each_file_json<trans> WriteToOperationLog(ReadFile("<TAG>activity:tempstorage/json_splitter/tempstorage_read/Read</TAG>",$gv_file_filter)); </trans>Dieses optionale Protokollierungsskript ruft
RunOperationeinmal pro aufgeteilter Datei auf. Wenn mehr als 50 Dateien erzeugt werden, erreicht diese Schleife das Limit auf Agent-Ebene für synchroneRunOperation-Aufrufe aus einer einzelnenWhile-Schleife (standardmäßig50); siehe den Hinweis unterRunOperationfür Details. -
Die Vorgangsoptionen müssen mit Enable Chunking konfiguriert werden, mit einer Chunk Size von
1, Number of Records per File von1und Max Number of Threads von1: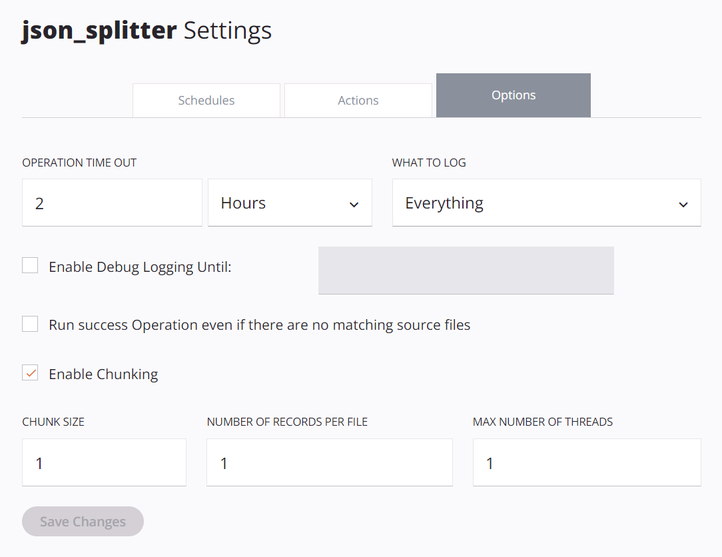
Das Ausführen des Vorgangs ergibt einzelne JSON-Datensätze, die in der Protokollausgabe angezeigt werden:
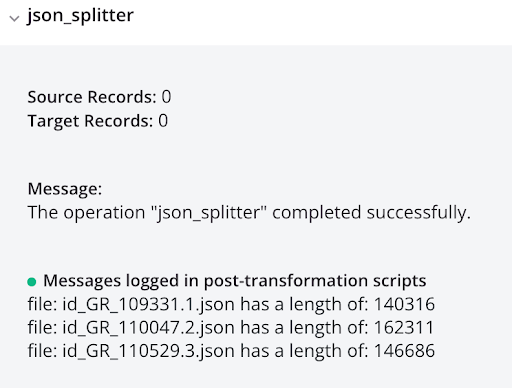
Nach dem Aufteilen und Verarbeiten einzelner Datensätze besteht ein häufiger nächster Schritt darin, eine Zusammenfassungs-E-Mail oder ein Protokoll verarbeiteter Datensätze zu senden. Siehe Generate a summary log after processing records. Überlegungen zum gleichzeitigen Ausführen von Vorgängen pro Datensatz finden Sie unter Manage asynchronous operations.