Schlüsselkonzepte für Transformationen in Jitterbit Studio
Diese Seite erläutert die Kernkonzepte, die Sie beim Entwerfen von Transformationen und bei der Behebung von Problemen verstehen müssen.
Schemas
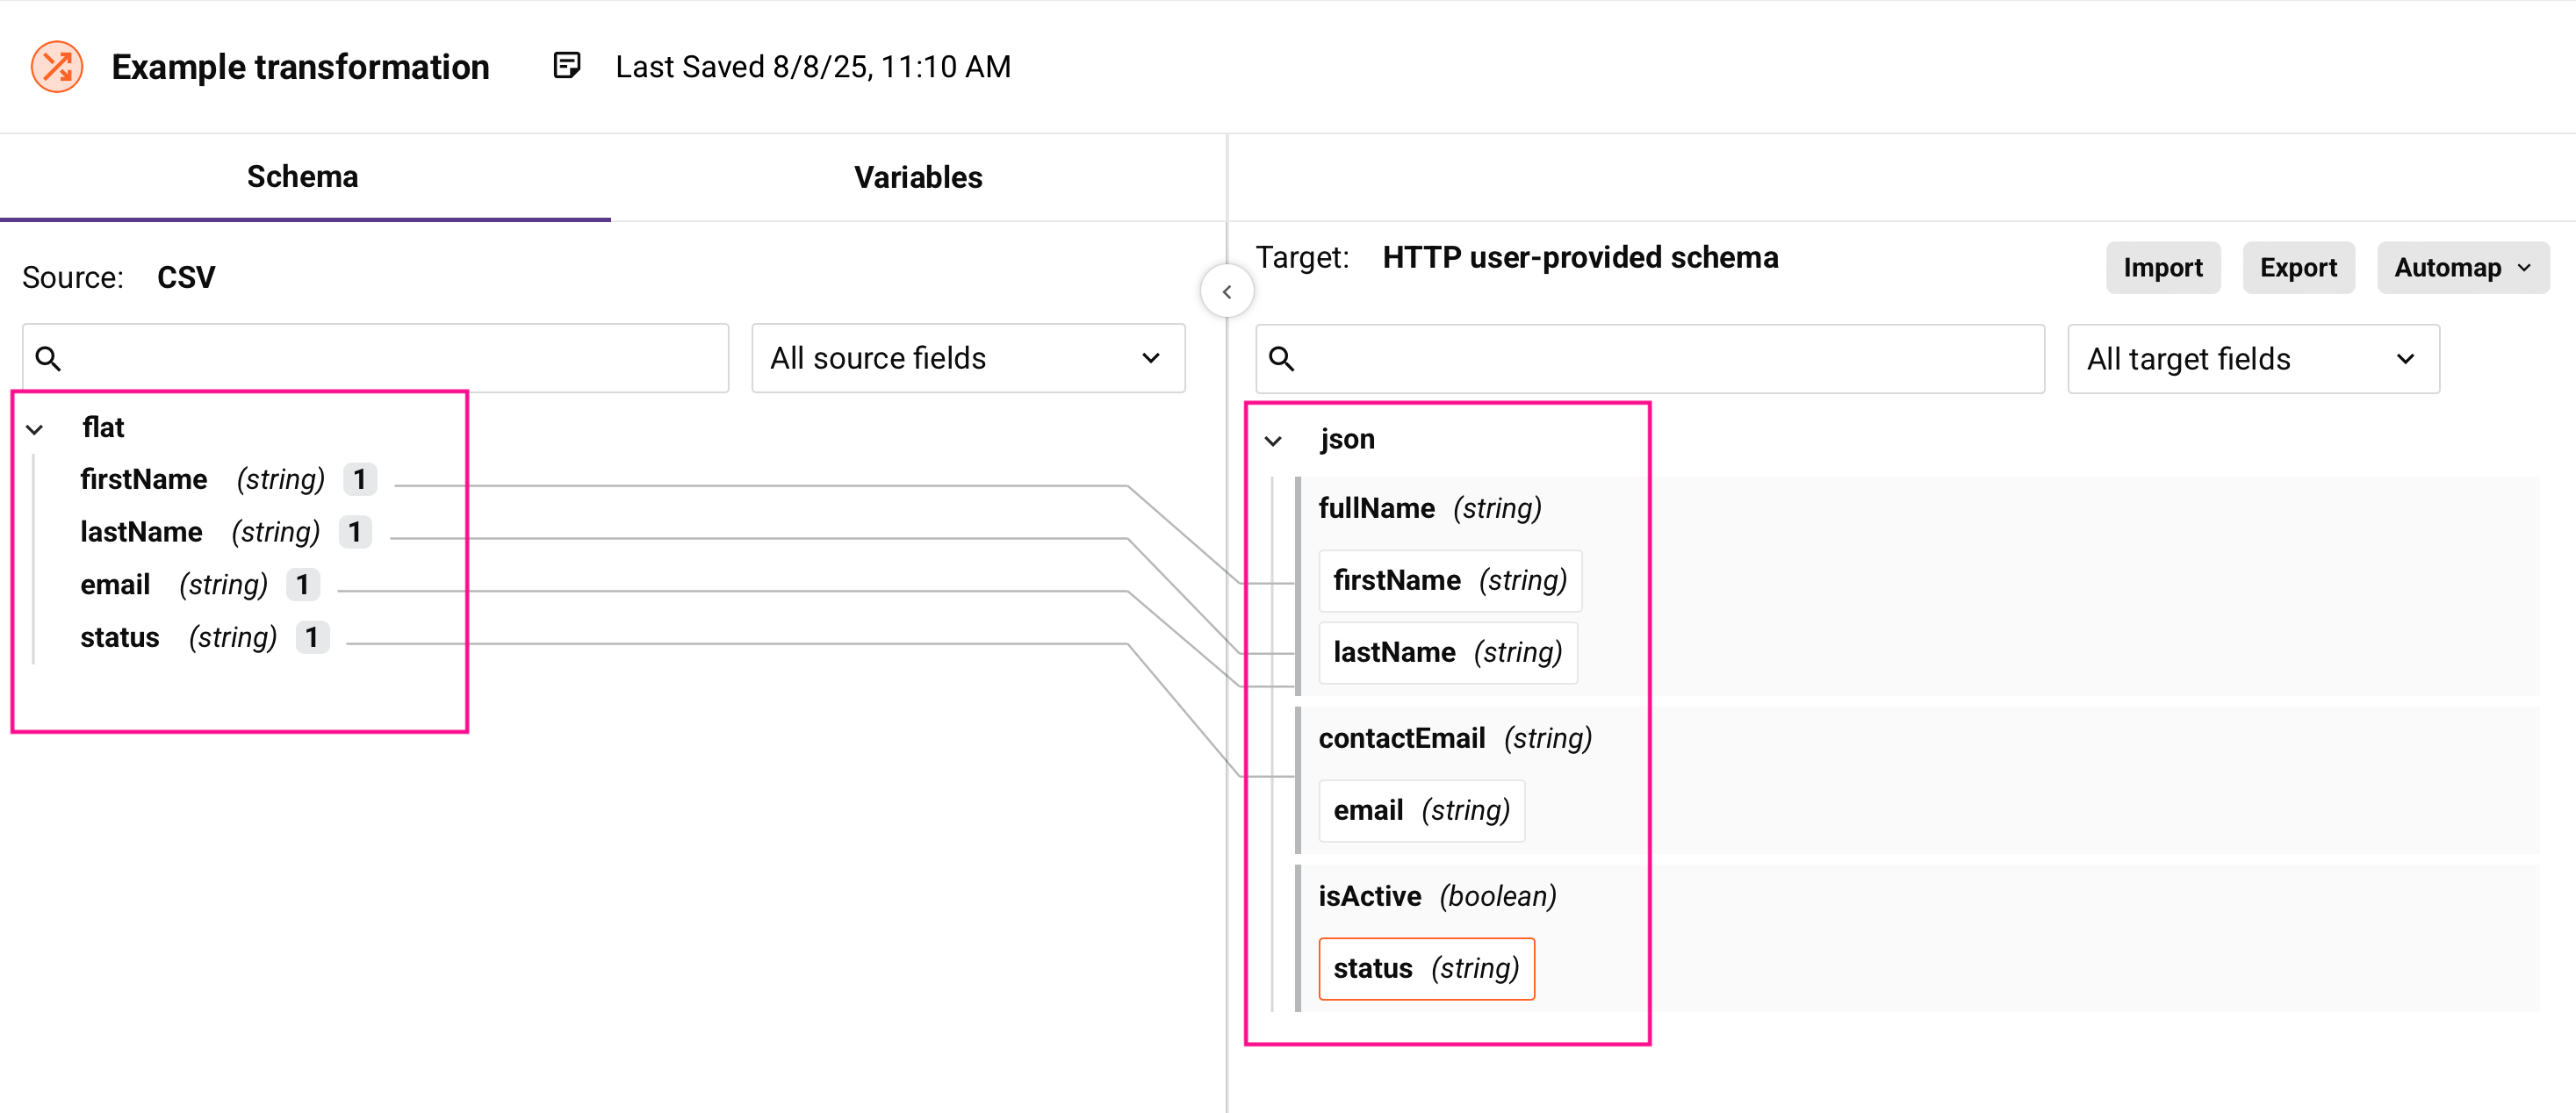
Ein Schema definiert die Struktur und die Datentypen Ihrer Ein- oder Ausgabedaten. Schemas geben an, welche Felder verfügbar sind, welche Datentypen sie haben und wie Felder organisiert sind:
Quellschemas
Das Quellschema beschreibt die Struktur der Daten, die in Ihre Transformation eingehen. Quellschemas können aus diesen Quellen stammen:
-
Von Aktivitäten generierte Schemas: Werden automatisch von Connector-Aktivitäten wie Datenbankabfragen oder API-Aufrufen erstellt.
-
Benutzerdefinierte Schemas: Benutzerdefinierte Schemas, die Sie erstellen oder hochladen.
Quellschemas sind optional. Sie benötigen kein Quellschema, wenn Sie in Ihren Zuordnungen nur Variablen, benutzerdefinierte Werte oder Skriptlogik verwenden.
Weitere Informationen finden Sie unter Schemaquellen auswählen.
Zielschemas
Das Zielschema beschreibt die Struktur der Daten, die Ihre Transformation verlassen. Wie Quellschemas können Zielschemas von Aktivitäten generiert oder benutzerdefiniert sein.
Zielschemas sind immer erforderlich. Jede Transformation muss ein Zielschema haben, das die Ausgabestruktur definiert.
Detaillierte Anleitung zum Erstellen und Konfigurieren von Schemas finden Sie unter Transformation erstellen und Schemas konfigurieren.
Datenstrukturen
Datenstrukturen definieren, wie Informationen innerhalb von Schemas organisiert sind.
Flache Strukturen
Flache Strukturen enthalten Felder auf einer einzelnen Ebene ohne Verschachtelung. Beispiele sind diese Formate:
- CSV-Dateien mit Spalten
- Einzelne Datenbanktabellen
- Einfache XML-Dateien ohne verschachtelte Elemente
Beispiel
<customer>
    <id>10123</id>
    <fullname>ABC Co.</fullname>
    <street>1 Main St.</street>
    <city>Anytown</city>
    <state>NY</state>
    <zip>12345</zip>
</customer>
Hierarchische Strukturen
Hierarchische Strukturen enthalten verschachtelte Beziehungen zwischen Feldern und Datensätzen. Beispiele sind diese Formate:
- Komplexe XML-Dateien mit verschachtelten Elementen
- JSON-Objekte mit verschachtelten Eigenschaften
- Datenbankverbindungen über mehrere Tabellen
Beispiel
<customer>
    <id>10123</id>
    <name>ABC Co.</name>
    <addresses>
        <address>
            <street>1 Main St.</street>
            <city>Anytown</city>
            <state>NY</state>
            <zip>12345</zip>
        </address>
        <address>
            <street>1 Time Square</street>
            <city>New York City</city>
            <state>NY</state>
            <zip>54321</zip>
        </address>
    </addresses>
</customer>
Weitere Informationen zum Arbeiten mit Datenstrukturen finden Sie unter Daten zuordnen.
Für komplexe hierarchische Datenszenarios siehe Mit hierarchischen Daten arbeiten.
Knoten und Felder
Schemas werden als Baumstrukturen angezeigt, die Knoten und Felder enthalten. Knoten sind Container, die Felder in hierarchischen Strukturen organisieren. Felder enthalten die tatsächlichen Datenwerte.
Jeder Knoten und jedes Feld zeigt diese visuellen Indikatoren:

- Kardinalitätsschlüssel: Zeigt Vorkommenregeln in Klammern an.
- Name: Der Elementbezeichner aus dem Schema
- Datentyp: Nur für Felder (String, Integer, Boolean usw.)
-
Attribut-/Wertindikatoren: Einige XML-Strukturen enthalten zusätzliche Symbole:
Symbol Bedeutung @Elementattributdaten, z. B. @image#Elementtextdaten, z. B. #text
Knoten
Knoten sind Container, die Felder in hierarchischen Strukturen organisieren:
- Carets: Knoten erweitern und reduzieren.
- Fettgedruckte Namen: Geben Knoten an, die Zuordnungen enthalten, wenn sie reduziert sind.
- Standarderweiterung: 8 Ebenen tief für Schemas mit weniger als 750 Knoten, 5 Ebenen tief für Schemas mit 750 bis 5.000 Knoten und 2 Ebenen tief für Schemas mit 5.000 oder mehr Knoten. Das Erweitern oder Reduzieren eines Knotens über diese Standardeinstellung hinaus wird beibehalten, wenn Sie die Transformation erneut öffnen.
Sie können Daten nicht direkt Knoten zuordnen. Stattdessen ordnen Sie Daten den Feldern zu, die Knoten enthalten.
Felder
Felder enthalten die eigentlichen Datenwerte und haben diese Eigenschaften:
- Name: Die Feldkennung.
- Datentyp: Der Datentyp, z. B. String, Integer, Boolean, Datum und weitere.
- Format: Optionale Formatierung für Daten oder Währungen.
-
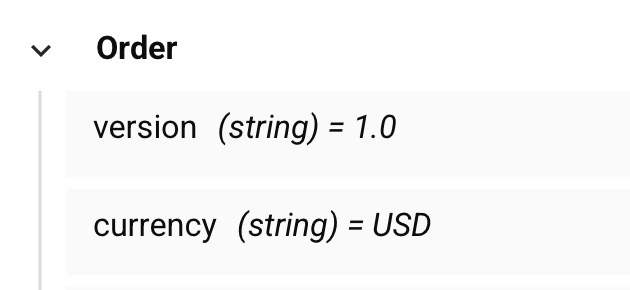
Standardwerte: Wenn ein XSD- oder WSDL-Schema einen Standardwert für ein Element oder Attribut angibt, wird der Wert neben dem Feldnamen in der Transformationsschnittstelle angezeigt:
Kardinalitätsnotation
Kardinalitätsschlüssel geben Vorkommenregeln mit UML-ähnlicher Notation an:
| Kardinalitätsschlüssel | Definition |
|---|---|
[1] |
Genau ein Element (erforderlich) |
[1+] |
Ein oder mehr Elemente (erforderlich, wiederholbar) |
[0,1] |
Null oder ein Element (optional) |
[0+] |
Null oder mehr Elemente (optional, wiederholbar) |
Zuordnungen
Eine Zuordnung verbindet Quelldaten mit Zielfeldern und definiert, wie Daten transformiert werden sollen.
Zuordnungstypen
-
Direkte Feldzuordnungen: Verbinden Quellfelder direkt mit Zielfeldern. Siehe Felder manuell zuordnen.
-
Benutzerdefinierte Wertzuordnungen: Weisen statische Werte oder Ausdrücke zu. Siehe Benutzerdefinierte Werte verwenden.
-
Variablenzuordnungen: Referenzieren Sie Projekt- oder globale Variablen. Siehe Variablen zuordnen.
-
Skriptzuordnungen: Verwenden Sie Funktionen und Logik zur Datentransformation. Siehe Zuordnung mit Skripten.
-
Bedingte Logik: Wenden Sie unterschiedliche Logik basierend auf Bedingungen an. Siehe Bedingte Logik.
Zuordnungsskripte
Alle Zuordnungen werden als Skripte in Zielfeldern implementiert. Auch visuelle Zuordnungen wie Drag-and-Drop erstellen zugrunde liegende Skripte. Sie können diese Skripte direkt für komplexe Transformationen bearbeiten.
Für die automatische Zuordnung ähnlicher Strukturen siehe Identische Strukturen zuordnen.
Schleifenknoten
Schleifenknoten verarbeiten wiederholte Daten, z. B. mehrere Datensätze oder Arrays. Wenn Sie Felder in Schleifenknoten zuordnen, verarbeitet die Transformation jede Iteration der Daten.
Automatische Schleifengenerierung
Schleifenknoten werden automatisch generiert, wenn Sie Felder aus wiederholten Quelldaten zu wiederholten Zielstrukturen zuordnen. Eine Iterator-Linie wird angezeigt, die zeigt, wie die Transformation die Daten durchlaufen wird.
Manuelle Schleifendefinition
Sie können Schleifenknoten manuell definieren, wenn die automatische Generierung nicht Ihren Datenverarbeitungsanforderungen entspricht. Dies ist nützlich, wenn Sie mehrere Ebenen wiederholter Daten haben und kontrollieren müssen, welche Ebene die Iteration antreibt.
Umfassende Anleitungen zur Arbeit mit wiederholten Daten finden Sie unter Datenschleifen steuern.
Variablen
Variablen sind für die Übergabe von Werten, Konfigurationseinstellungen und kleinen Datenmengen zwischen verschiedenen Komponenten in Ihrer Integration konzipiert. Variablen sind nützlich, wenn Sie Informationen wie Sitzungs-IDs, Konfigurationsparameter oder berechnete Werte über Skripte, Transformationen und Operationen hinweg freigeben müssen. Diese Variablentypen stehen zur Verfügung:
| Typ | Bereich | Ideal für |
|---|---|---|
| Local | Einzelnes Skript | Berechnungen und temporäre Werte |
| Global | Operationskette | Datenaustausch zwischen Operationen |
| Project | Gesamtes Projekt | Konfiguration und Anmeldedaten |
| Jitterbit | Systemdefiniert | Laufzeitinformationen |
Beispiele und detaillierte Informationen zu den einzelnen Variablentypen finden Sie auf den entsprechenden Dokumentationsseiten.
Praktische Beispiele für die Verwendung von Variablen in Transformationen finden Sie unter Variablen zuordnen.
Datenfluss
Daten fließen in dieser Reihenfolge durch Transformationen:
-
Eingabe: Eine Quellaktivität stellt Daten bereit, die dem Quellschema entsprechen.
-
Verarbeitung: Eine Transformation wendet Zuordnungen, Funktionen und Geschäftslogik an.
-
Ausgabe: Die transformierten Daten, die dem Zielschema entsprechen, gehen an die Zielaktivität.
Das Verständnis dieses Flusses hilft Ihnen, Zuordnungen zu entwerfen, die Daten korrekt verarbeiten, und Probleme zu beheben, wenn Daten nicht wie erwartet transformiert werden.
Hinweise zur Validierung und Fehlerbehebung finden Sie unter Transformationen testen und validieren und Transformationszuordnungskonflikte und Fehler beheben.